先看一个数字:1,030,000。
这是 AI-miniSOC 刚跑起来时,OpenSearch 里堆着的原始告警条数。Wazuh 开箱的规则集对着 75 台资产全方位扫描——SSH 爆破、Web 500 错误、端口扫描、系统日志异常……一天下来就是几千条。
一个人面对 103 万条告警是什么体验?
- 看不完:每秒看一条也要 12 天不睡觉
- 分不清:一条 level-10 的 SSH 爆破和一条 level-3 的日志轮转,在列表里长得没区别
- 更糟的是会麻木:第三天开始你就不看了——这就是告警疲劳,SOC 死亡的开始
这一篇讲 AI-miniSOC 的告警治理,全部围绕四个真实问题展开:
- 量的问题:103 万条怎么变成每天 ≤20 个可处理对象?
- 口径的问题:同一条告警为什么在不同页面显示不同等级?
- 噪声的问题:已知良性告警要不要每天出现在你眼前?
- 优先级的问题:20 个簇里先处理哪个?
问题一:103 万条怎么变成 20 个?——告警指纹聚合
核心洞察一句话:
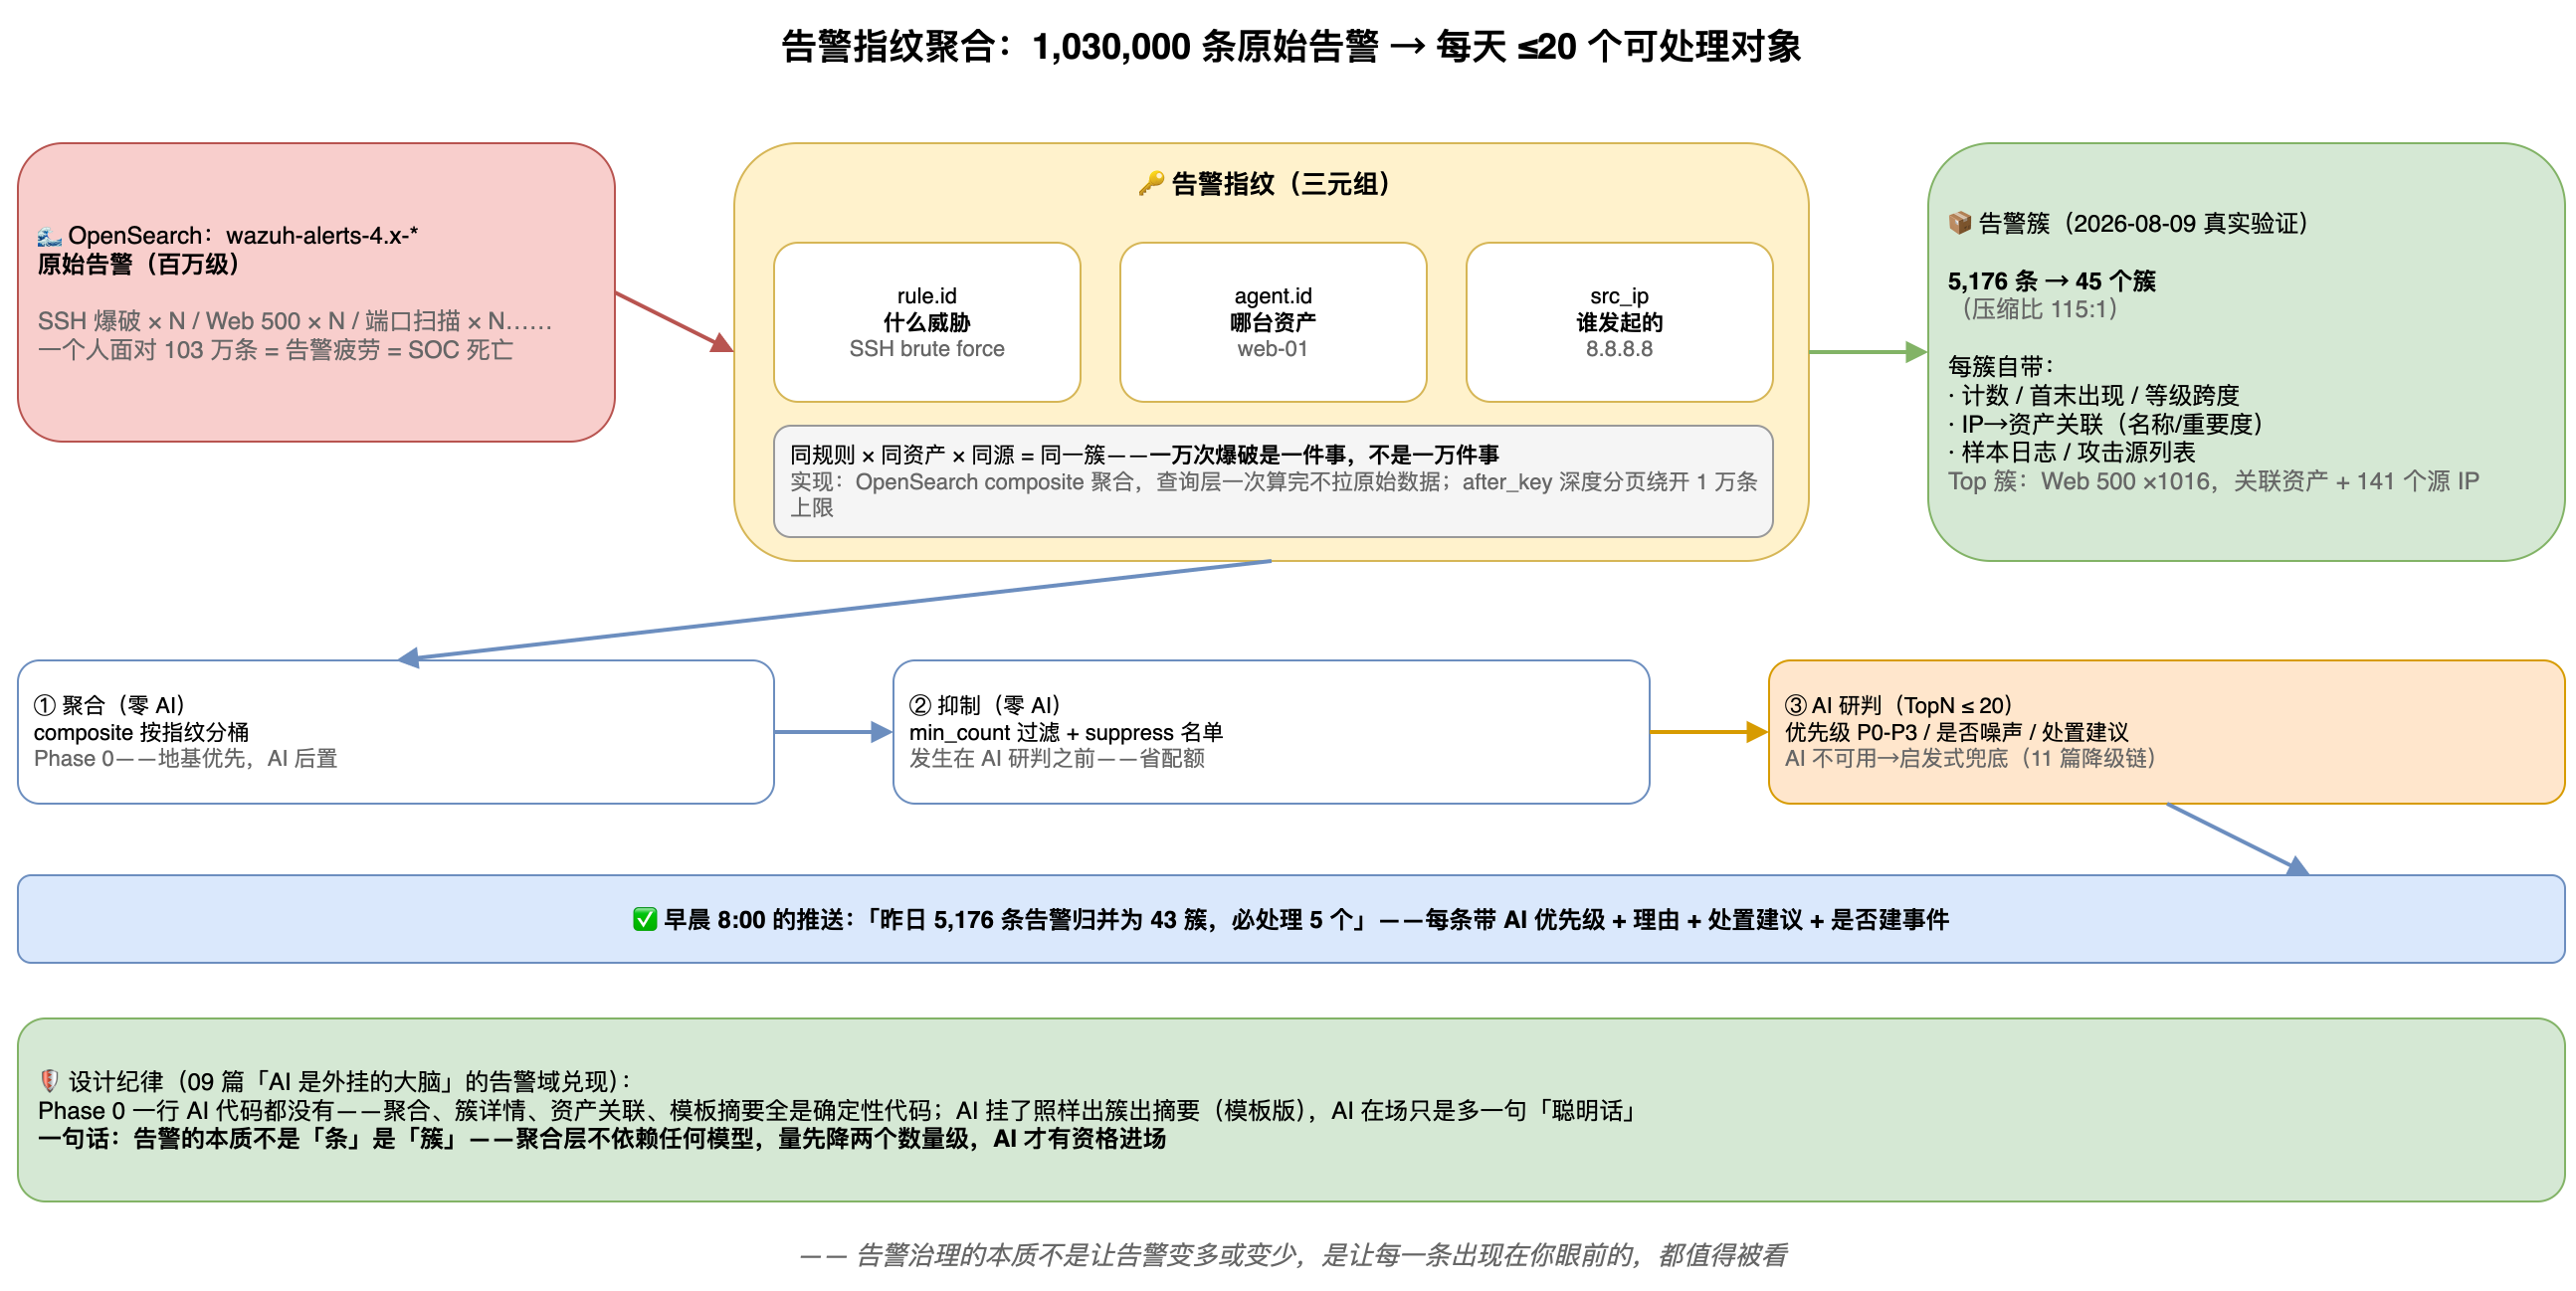
告警的本质不是"条",是"簇"。 一台机器被同一个 IP 爆破 SSH 一万次,那是一件事,不是一万件事。
指纹设计
把原始告警按三元组建簇:
fingerprint = rule.id + agent.id + src_ip
              (什么威胁)(哪台资产)(谁发起的)
同规则 × 同资产 × 同源 = 同一簇。实现上用 OpenSearch 的 composite 聚合在查询层一次算完,不拉原始告警回内存——百万级数据天然支持,还用 after_key 深度分页绕开了 1 万条上限。
真实数据验证
2026-08-09 Phase 0 上线当天,端到端验证的真实数字:
24h 内 5,176 条原始告警 → 归并为 45 个告警簇(压缩比 115:1) Top 簇:
rule 31120 Web 500 错误 @ aliCloudECS ×1016详情正确关联资产,并列出 141 个不同攻击源 IP
这个 115:1 意味着什么:你早上一睁眼要面对的不是 5,176 行列表,而是 45 个带上下文的"事件"。再配合下面的 TopN + AI 研判,每天真正需要人看的,不到 20 个。
设计纪律:地基优先,AI 后置
Phase 0 的实现清单里一行 AI 代码都没有——聚合、簇详情、IP→资产关联、摘要模板,全部是确定性代码。设计文档里原话:
地基优先、AI 后置:Phase 0 先把"聚合 + 摘要 + 查询"做扎实——此时完全不调 AI,也能显著提效。
这是 09 篇"AI 是外挂的大脑,不是中枢神经"在告警域的又一次兑现:聚合层不依赖任何模型,AI 挂了照样出簇、照样出摘要(模板版),AI 在场时只是多一句"聪明话"。
问题二:同一条告警,两个页面两个等级?——13/10/7/4 阈值统一
聚合解决了"量",接下来是更隐蔽的"口径"问题。
四套阈值打架的历史
2026-08-22 之前的代码里,同一个项目同时存在 4 套告警分级阈值:
| 使用方 | 阈值 |
|---|---|
| alert_query / report_generator / impact_analysis / query_templates | 13 / 10 / 7 / 4 |
| ai_analysis(两处) | 12 / 7 |
| ai_analysis(另一处) | 12 / 8 |
| asset_summary | 12 |
后果是什么?alert_levels.py 模块注释里记着一次生产实测:
同一条 level-10 告警在「AI 分析」页显示"中风险"、在「安全报告」里计为 high,生产实测 7 天内该区间有 4,921 条告警受影响。
4,921 条告警处在"这套阈值说是 high、那套阈值说是 medium"的模糊带里。这不是显示瑕疵,是信任裂缝——你在报告里给老板写"本周 high 告警 23 条",另一页面显示 4,904 条,你怎么解释?
解法:一个文件,唯一权威
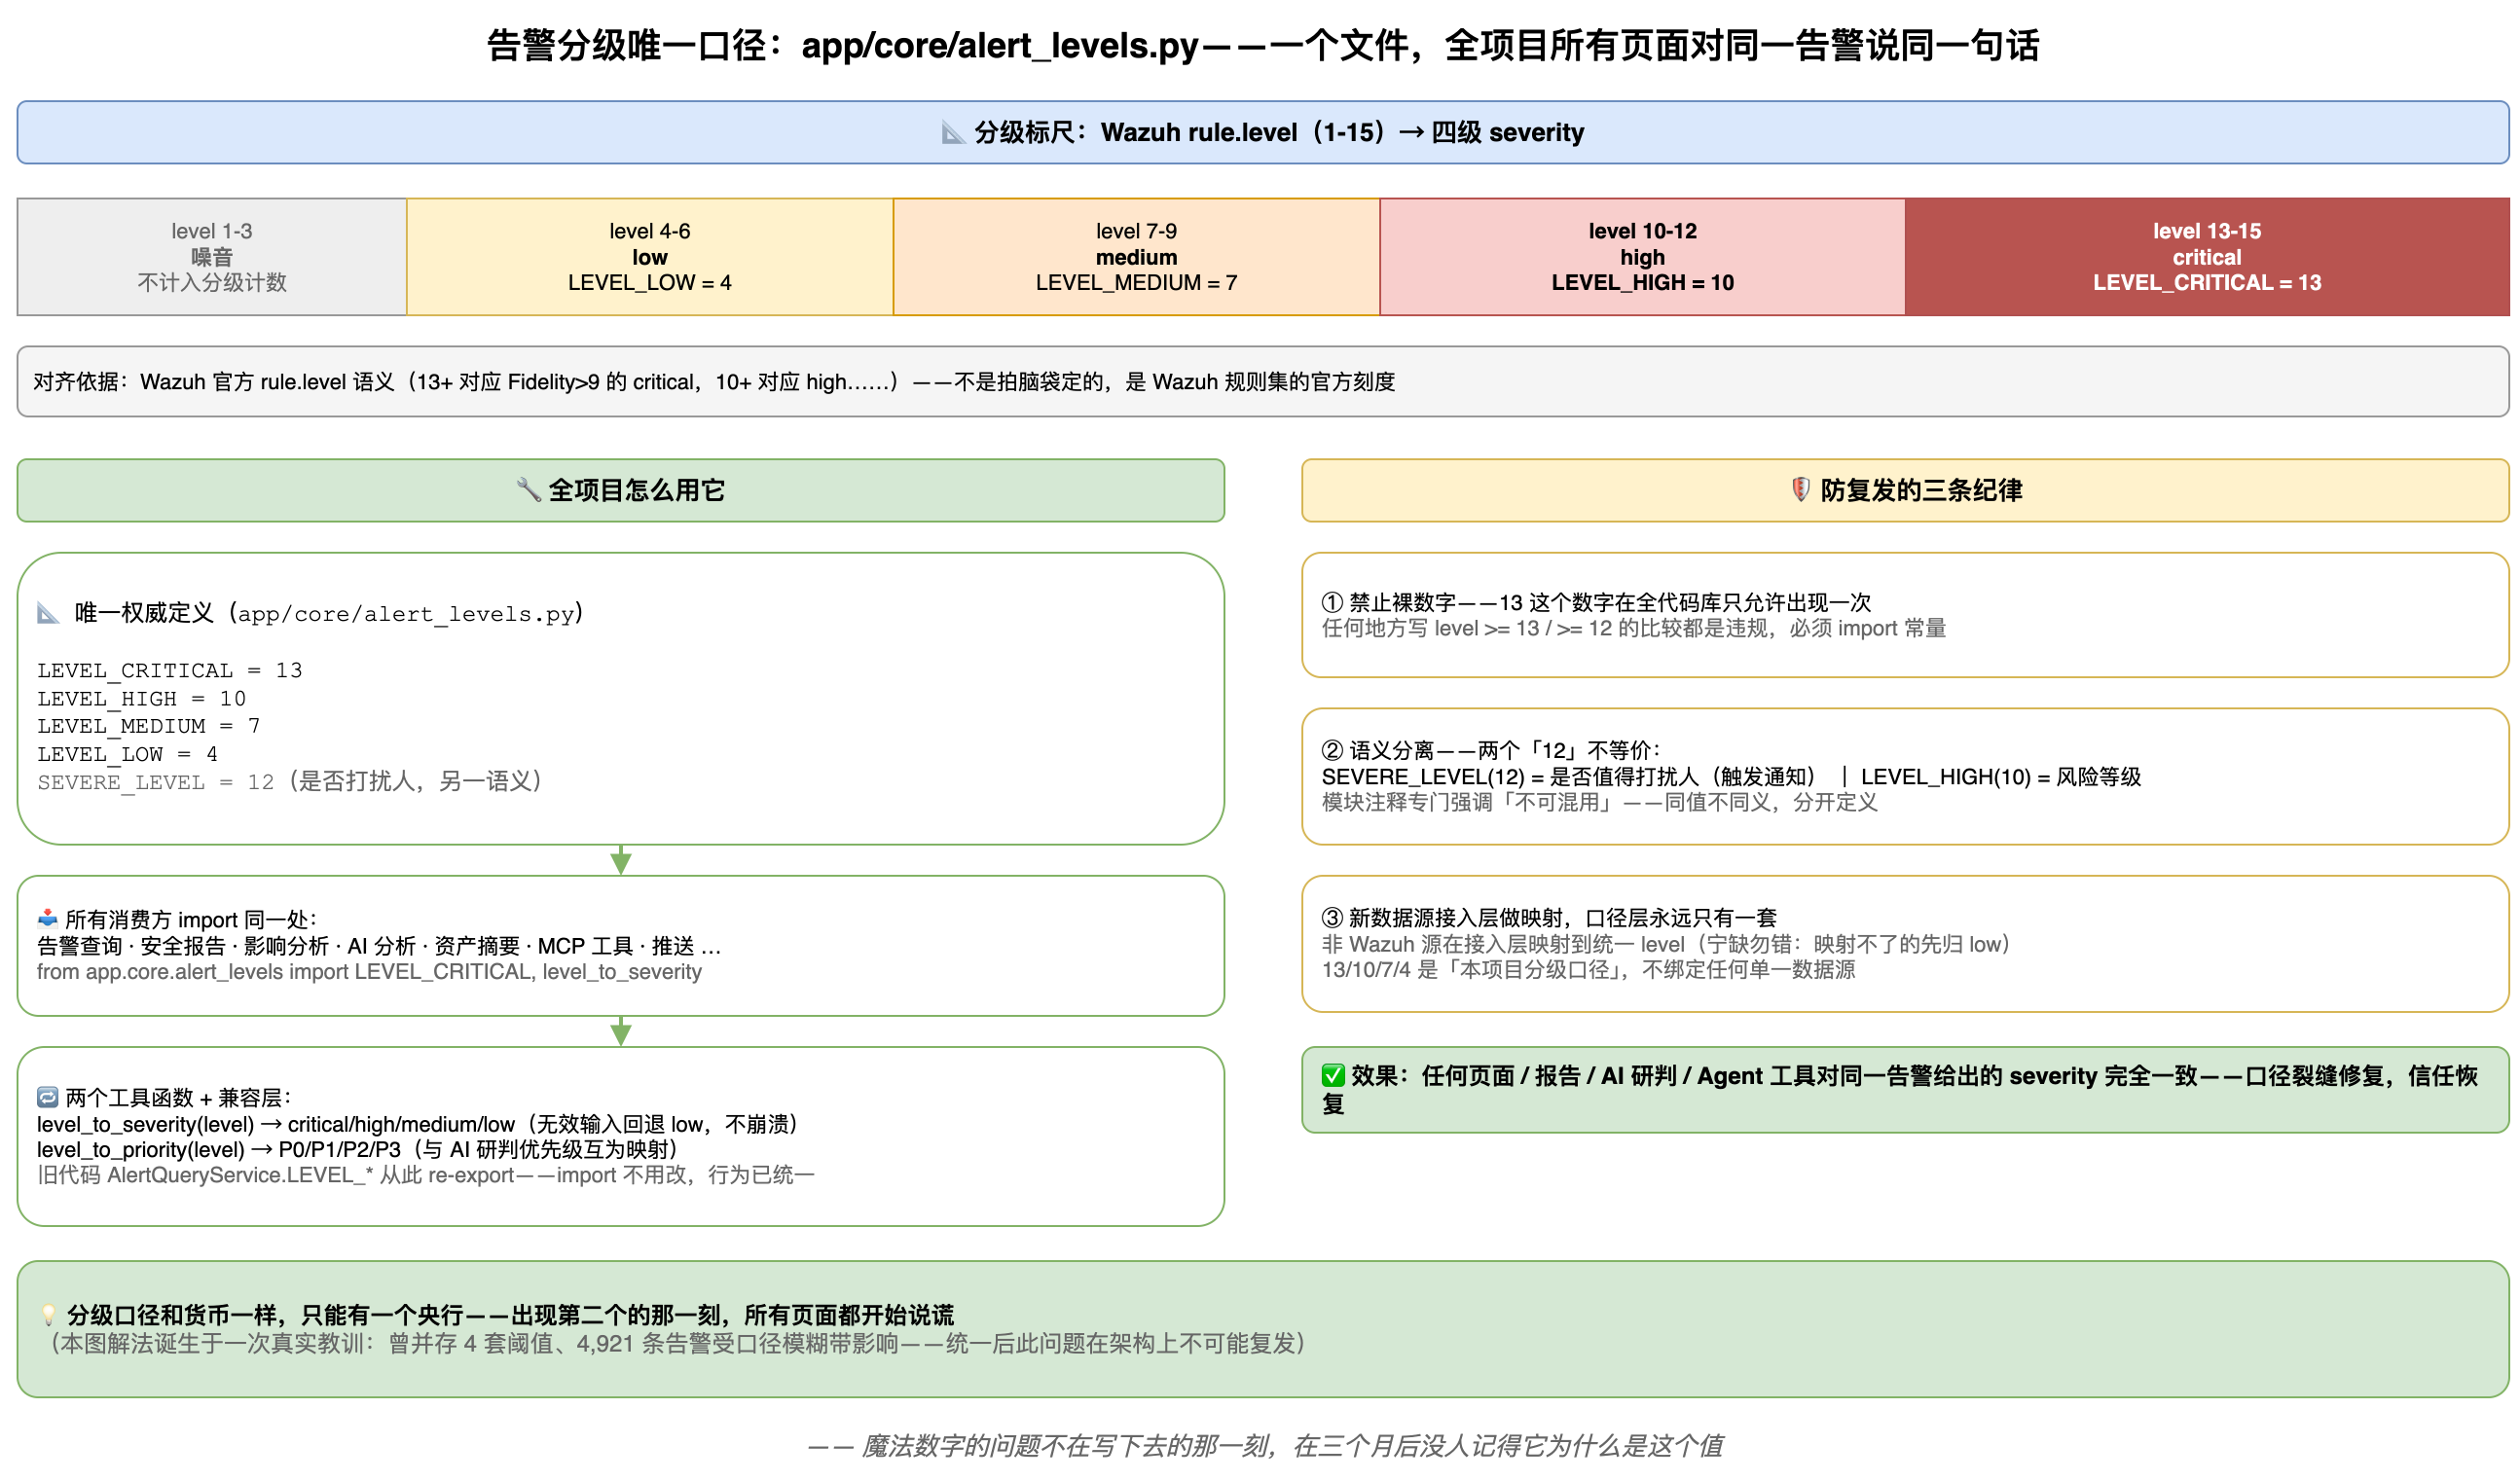
统一动作干脆利落——新建 app/core/alert_levels.py,全项目唯一权威定义:
| |
为什么是 13/10/7/4?对齐依据写在注释里:Wazuh 官方 rule.level 语义(13+ 对应 Fidelity>9 的 critical,10+ 对应 high……),而 report_generator 从第一天就用的这套,覆盖面最广。
配套三条纪律:
- 所有新代码一律
from app.core.alert_levels import LEVEL_CRITICAL, ...,禁止再写裸数字比较——13 这个数字在整个代码库里只允许出现一次 - 旧代码的
AlertQueryService.LEVEL_*从此模块 re-export,import 不用改,行为已统一 - 阈值语义文档化——注意
SEVERE_LEVEL = 12(是否值得打扰人)与LEVEL_HIGH = 10(风险等级)是两个不同语义,模块注释里专门强调"不可混用"
分级口径和货币一样,只能有一个央行。 出现第二个的那一刻,所有页面都开始说谎。
问题三:已知噪声,要不要每天见?——抑制名单与最小阈值
45 个簇里,总有那么几个你早就看腻了的:每周例行的漏扫、监控系统自己的健康检查、那台打印机每次开机报的错。它们不是威胁,但每天都准时出现在列表头部。
AI-miniSOC 的噪声抑制是两层漏斗,配置外置(soc_system_config,admin 可调):
第一层:min_group_count(默认 1)
    少于 N 条的簇不进摘要/研判——单条的孤立告警大概率不值得处理

第二层:suppress_rule_ids(默认空)
    命中抑制名单的 rule.id,整簇标记 ai_is_noise=true,移出"必处理"
    例:已知良性扫描规则、自监控探针
关键细节:过滤发生在 AI 研判之前——digest 降级分支和 triage 研判共用同一个 filter_noise_groups(),研判前先过滤。这意味着被抑制的簇不消耗 AI 配额,又是一条"成本可控"的细节。
治理参数的实际界面——「配置中心 → 配置管理 → 告警治理」,三个参数就是三个旋钮:研判深度(TopN=20,成本说明直接写在旁边)、最小簇条数(注意"下周期生效"标签——批次调度的生效节奏是明示的,不装即时)、噪声规则名单(逗号分隔填 rule.id)。「恢复默认」一键兜底:
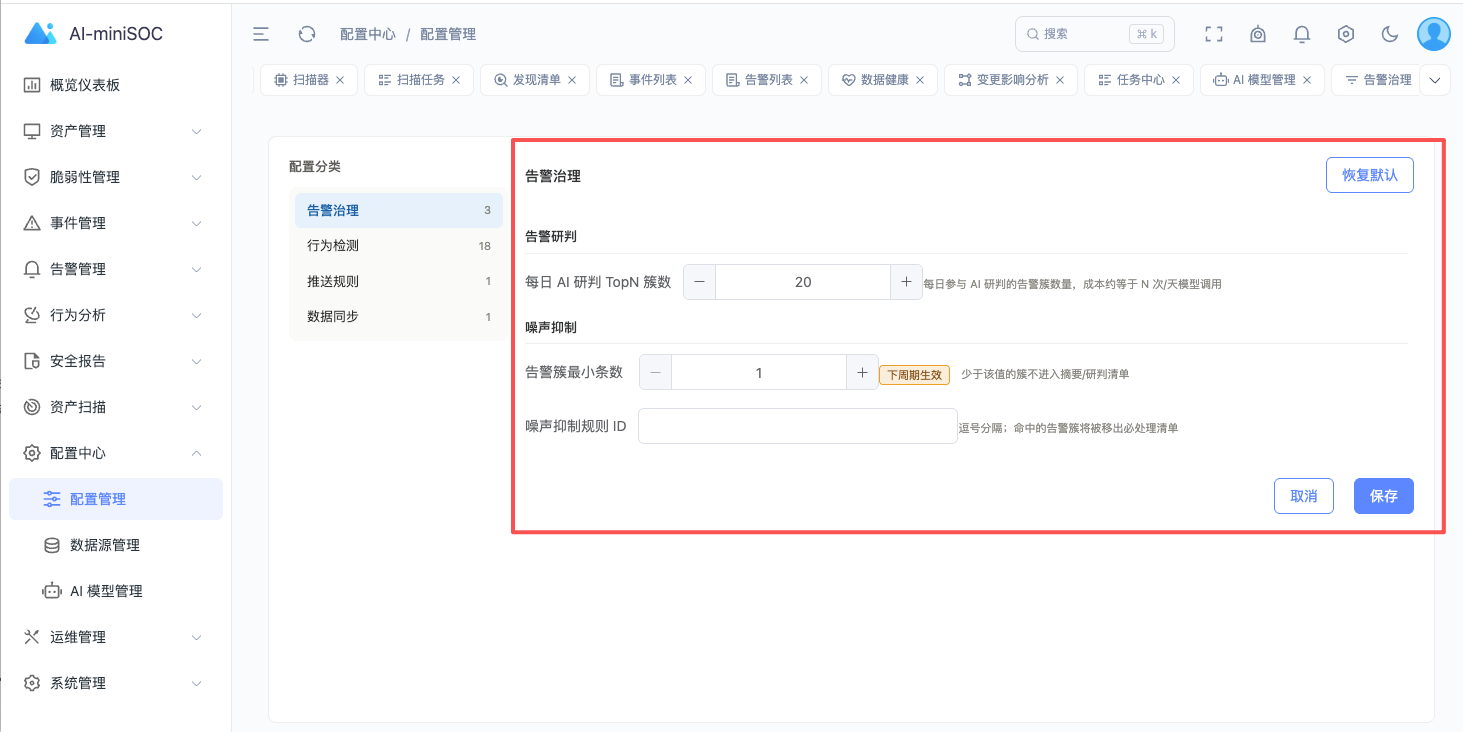
三层配置一并外置在 alert_governance 分类下:
| 键 | 默认 | 作用 |
|---|---|---|
triage_top_n | 20 | 每日 AI 研判的 TopN 簇数(成本 ≈ N 次/天) |
suppress_rule_ids | 空 | 噪声抑制规则 ID 列表 |
min_group_count | 1 | 簇最小条数阈值 |
阈值是运营参数,不是架构常量——这条纪律从 12 篇的推送规则一路贯穿到这里。
问题四:20 个簇,先处理哪个?——AI 簇级研判 + SLA
到这一步,量(45→20)、口径(统一)、噪声(抑制)都解决了,最后一个问题:排序。
AI 簇级研判:从"解释一条"到"研判一簇"
Phase 1 的跃迁:AI 的研判对象从单条告警升级为告警簇。输入一个簇的签名(规则、等级跨度、量级、受影响资产及重要度、样本日志),输出结构化结论:
| |
研判结果按 grp:<fingerprint> 缓存 7 天(复用 soc_ai_analyses 的 TTL 机制)——同簇 7 天内重复询问不花第二次钱。每天只对 TopN(默认 20)簇研判,glm-4-flash 的成本可以忽略。
AI 不可用时降级为启发式 verdict(11 篇的四级降级链),界面照常、标记"启发式兜底"。
SLA:另一个维度的优先级
等级(level)回答"这事多严重",但不回答"这事多急"。2026-09 补上的 SLA 体系按业务影响(BIA)分档:
| 业务影响 | 响应 SLA | 解决 SLA |
|---|---|---|
| core | 15 分钟 | 4 小时 |
| important | 1 小时 | 8 小时 |
| normal | 4 小时 | 24 小时 |
| auxiliary | 24 小时 | 72 小时 |
| ignorable | 72 小时 | 7 天 |
链路:告警 → agent.ip → 资产 → business_impact → SLA 配置。设计要点注释里写得清楚:data_sensitivity 驱动评分,business_impact 驱动处置——两个维度职责分离,core 资产上的 medium 告警可能比 auxiliary 资产上的 high 更早需要你出手。
超 SLA 未处置的告警进 12 篇的推送场景——治理体系到这里完全咬合。
全链路:一张图串起来
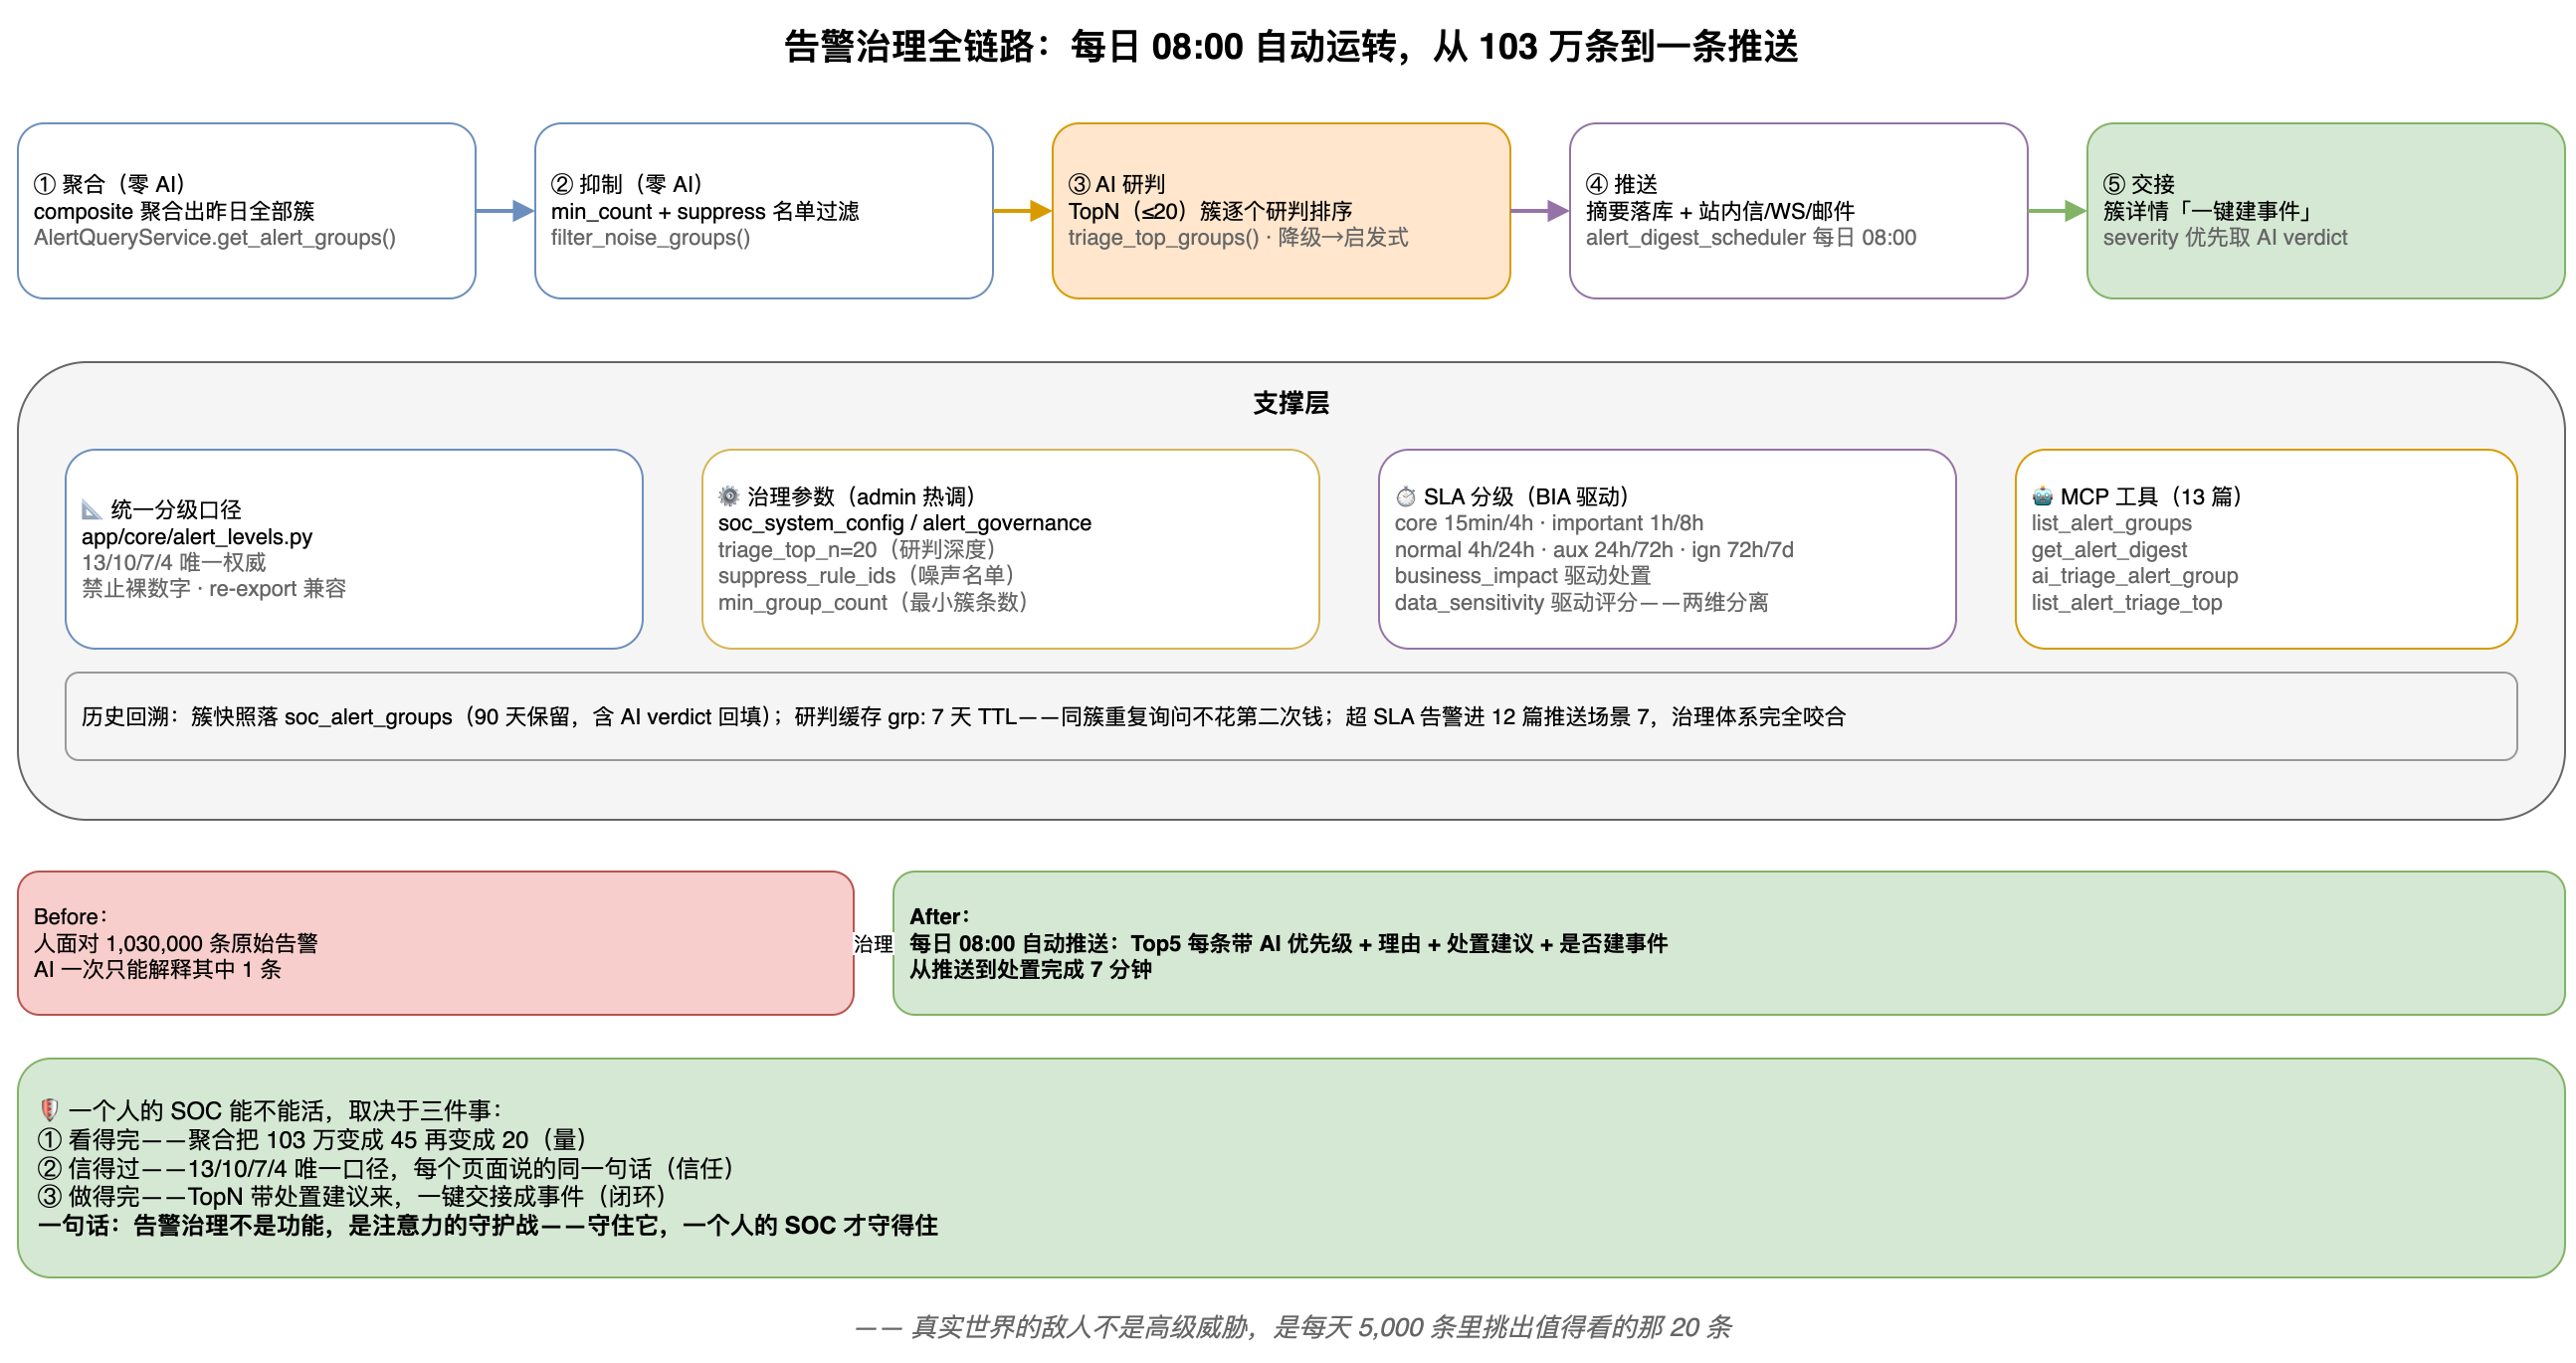
整条链每日自动运转(Phase 2 调度器,每日 08:00):
- 聚合:composite 聚合出昨日全部簇(零 AI)
- 抑制:min_count + suppress 名单过滤(省 AI 配额)
- 研判:TopN 簇逐个 AI 研判,按优先级排序
- 推送:摘要落库 + 站内信/WS 推送给 admin
- 交接:簇详情页"一键建事件",severity 优先取 AI verdict
从 103 万条到早上一条推送里的 Top5,每条带优先级、理由、处置建议、是否建事件。
端到端效果
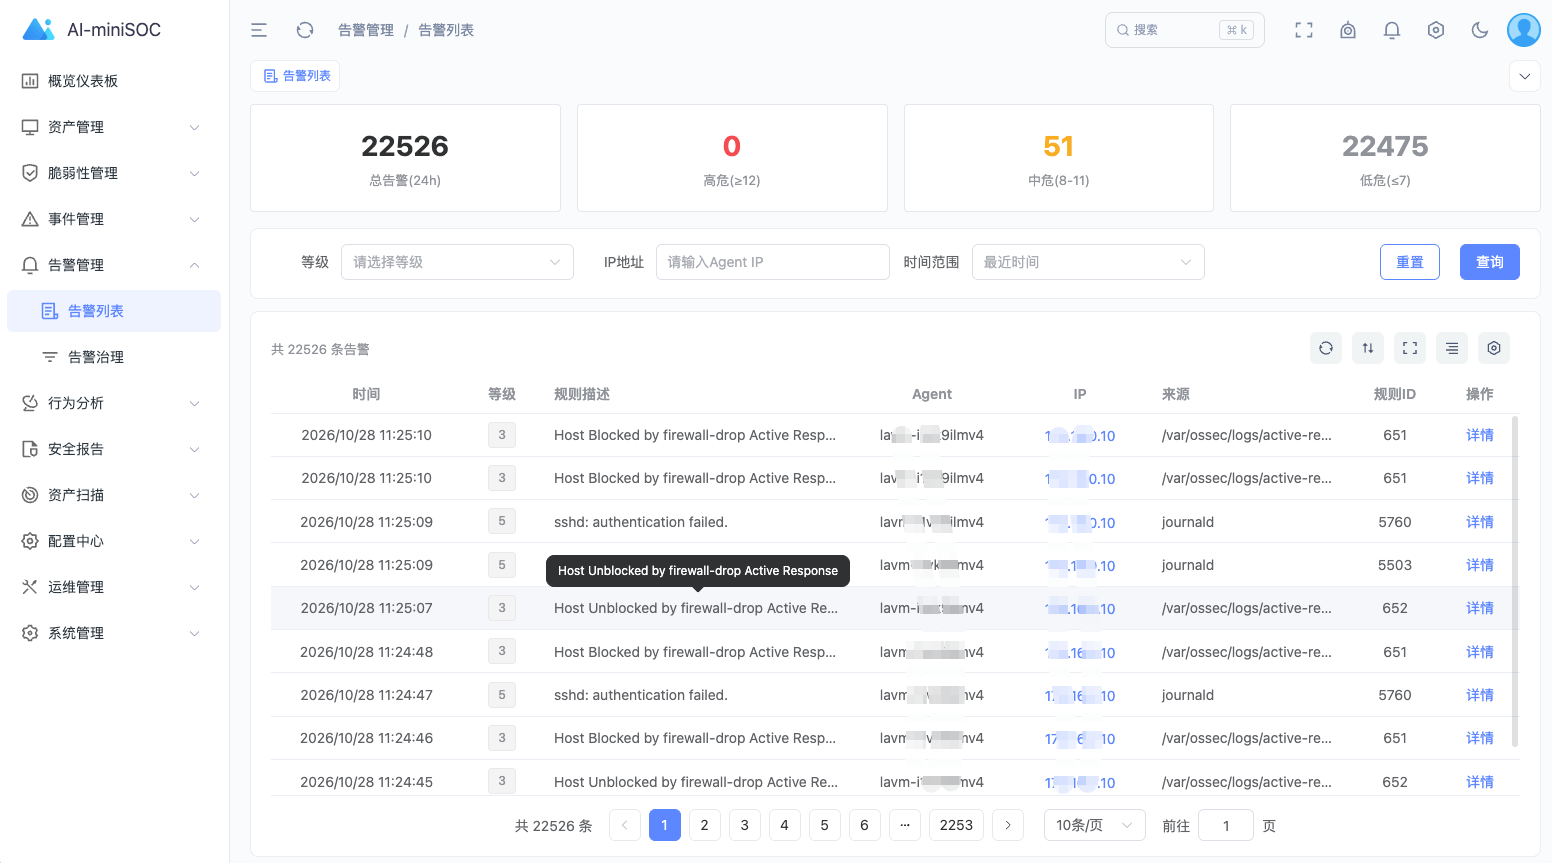
改造前的世界——原始告警列表,近 24h 22,526 条、2,253 页。注意看前几行:firewall-drop 封禁 和 sshd 认证失败 在时间上紧挨着反复出现——这正是典型的"同一件事被拆成几万条"的现场:
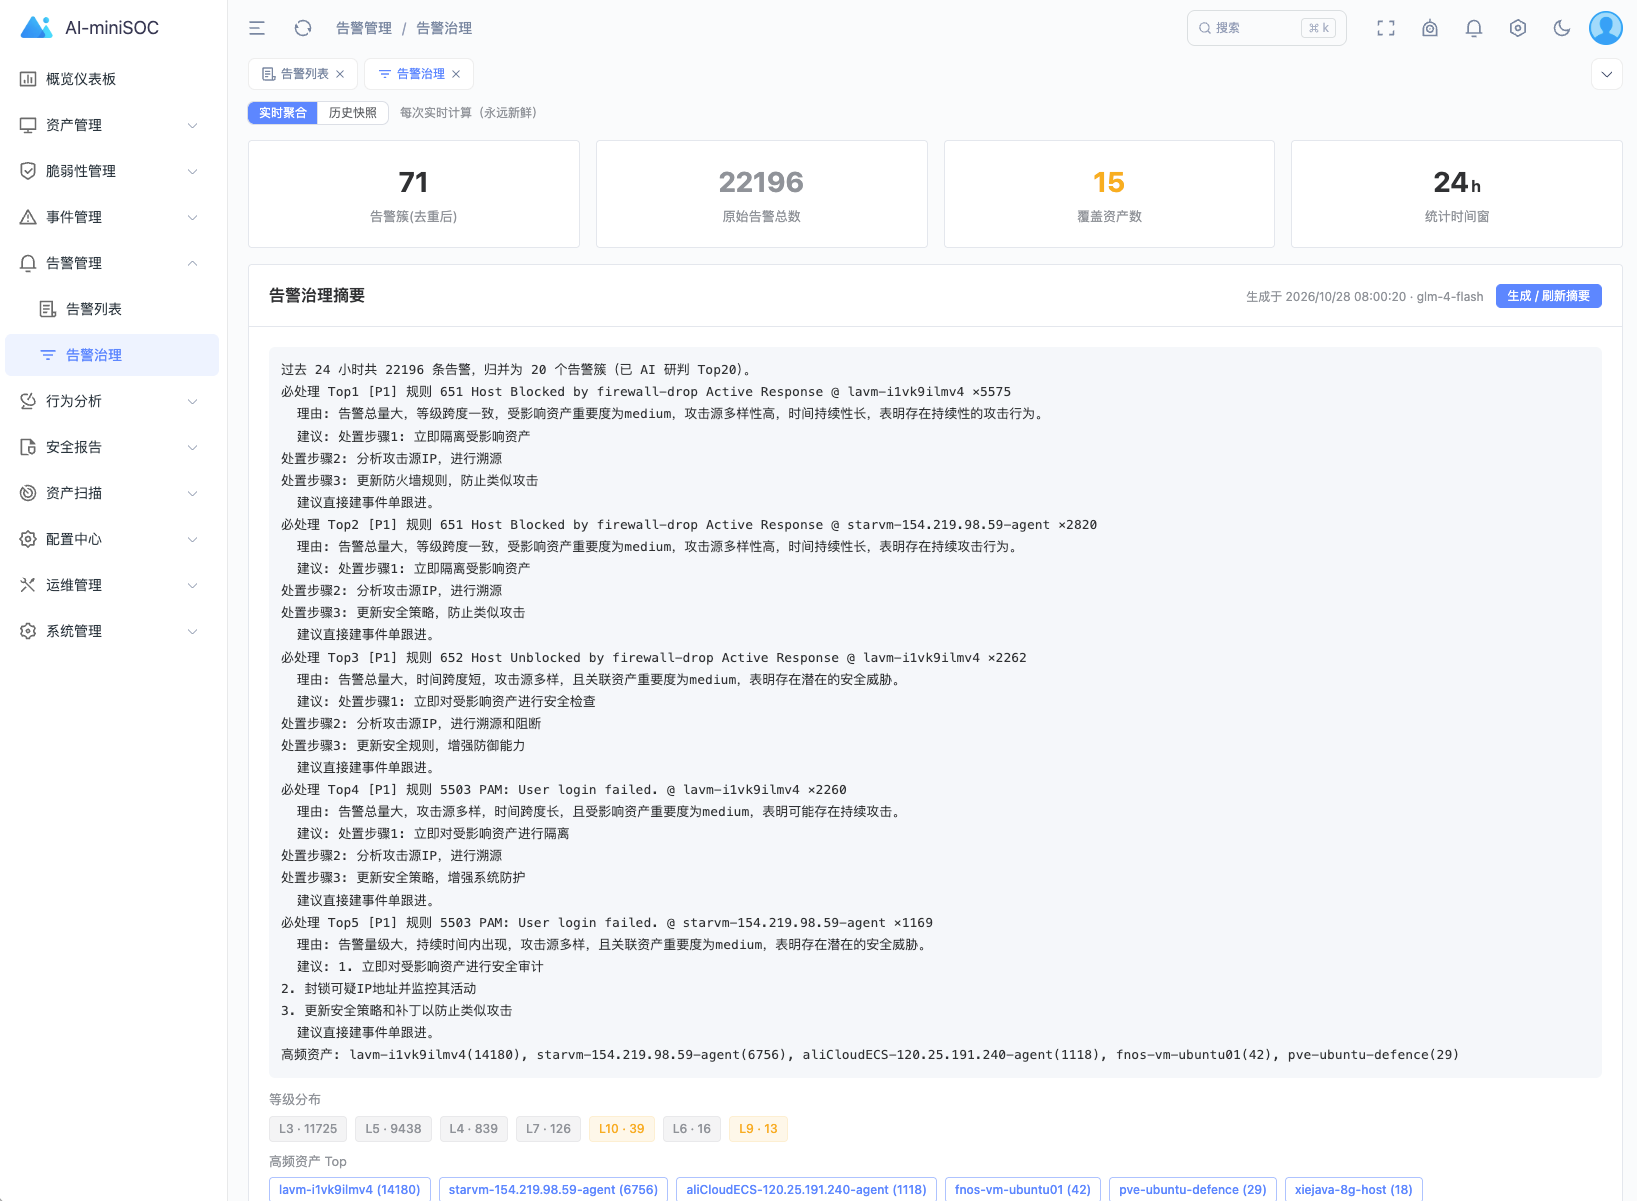
治理后的同一份数据——告警治理摘要页:22,196 条归并为 71 簇(压缩比 313:1),顶部卡片一句话给你全景。下方是 glm-4-flash 每日 08:00 自动生成的治理摘要,“必处理 Top5"每条带优先级、理由、处置步骤:
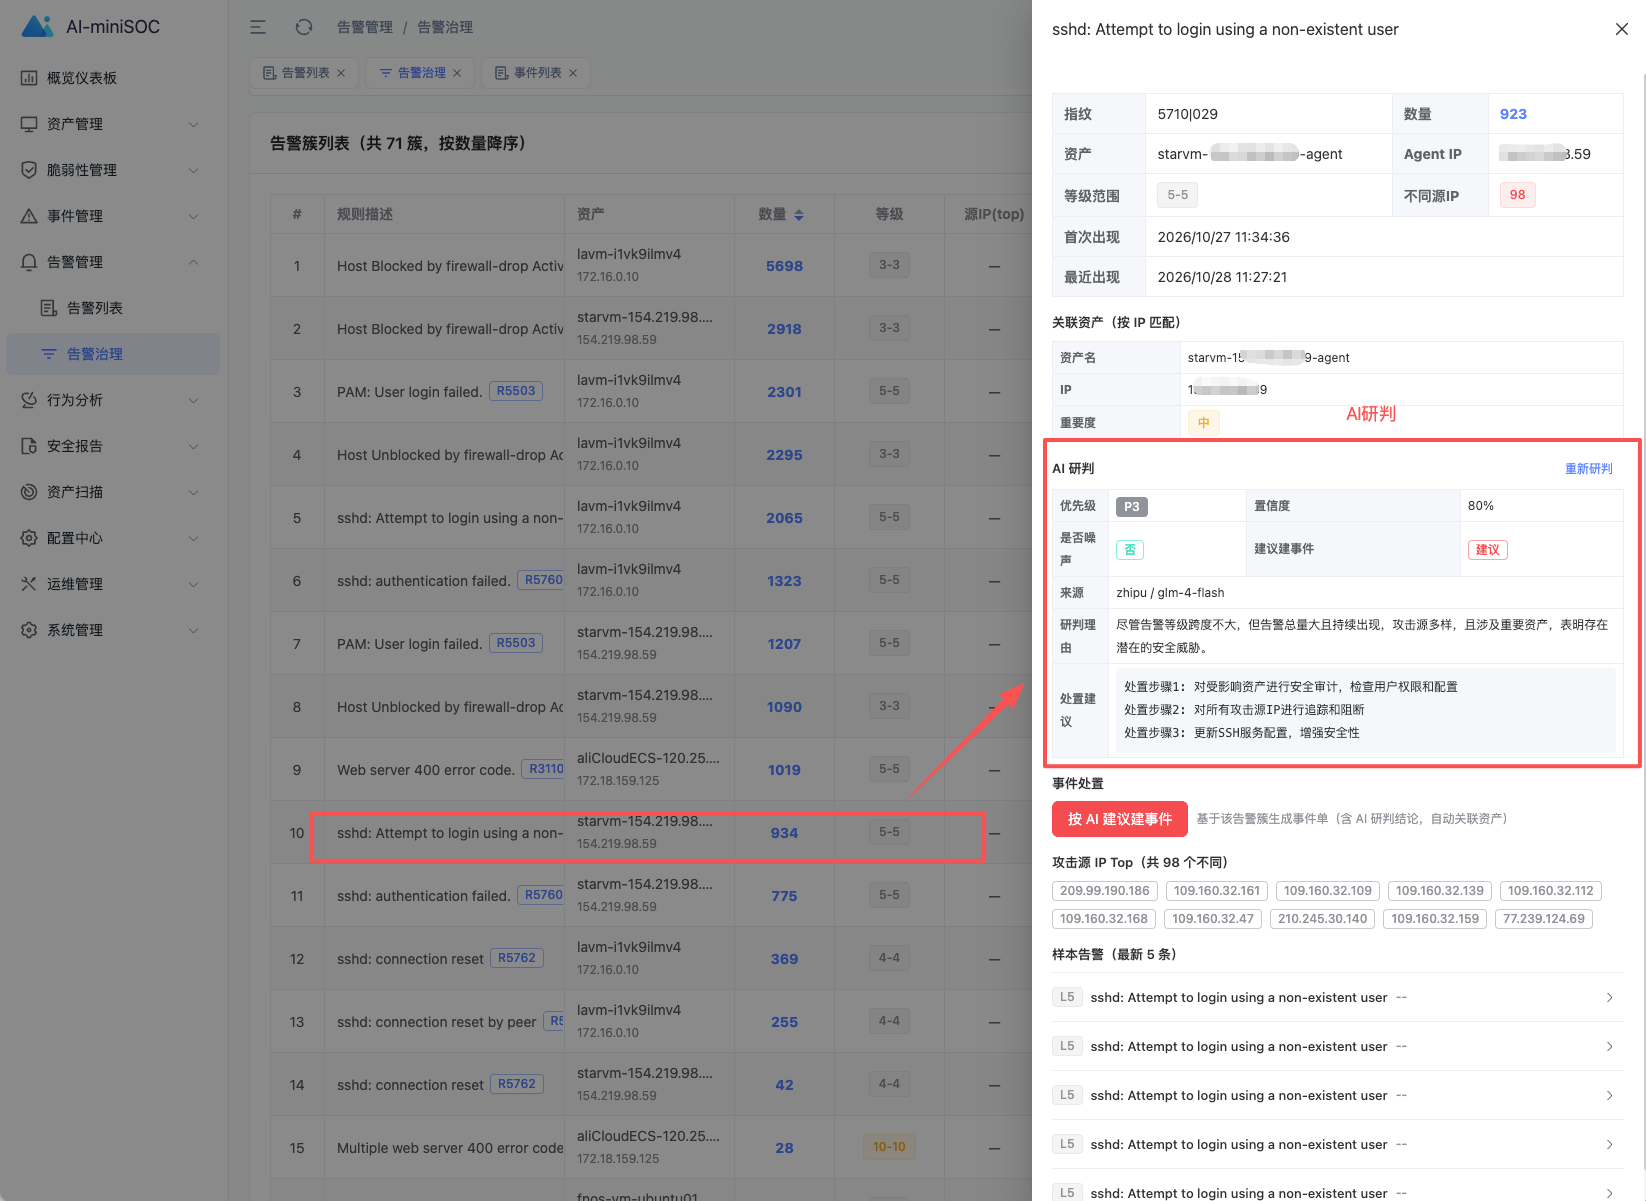
点开一个簇——右侧详情面板把一个"簇"该有的上下文全部拉齐:指纹、923 条计数、等级跨度、98 个不同攻击源 IP、首末出现时间、关联资产(含重要度)、样本告警。下半部是 AI 研判块:P3 优先级、80% 置信度、非噪声、研判理由、三步处置建议——还有一个"重新研判"按钮,结论不是一次定终身:
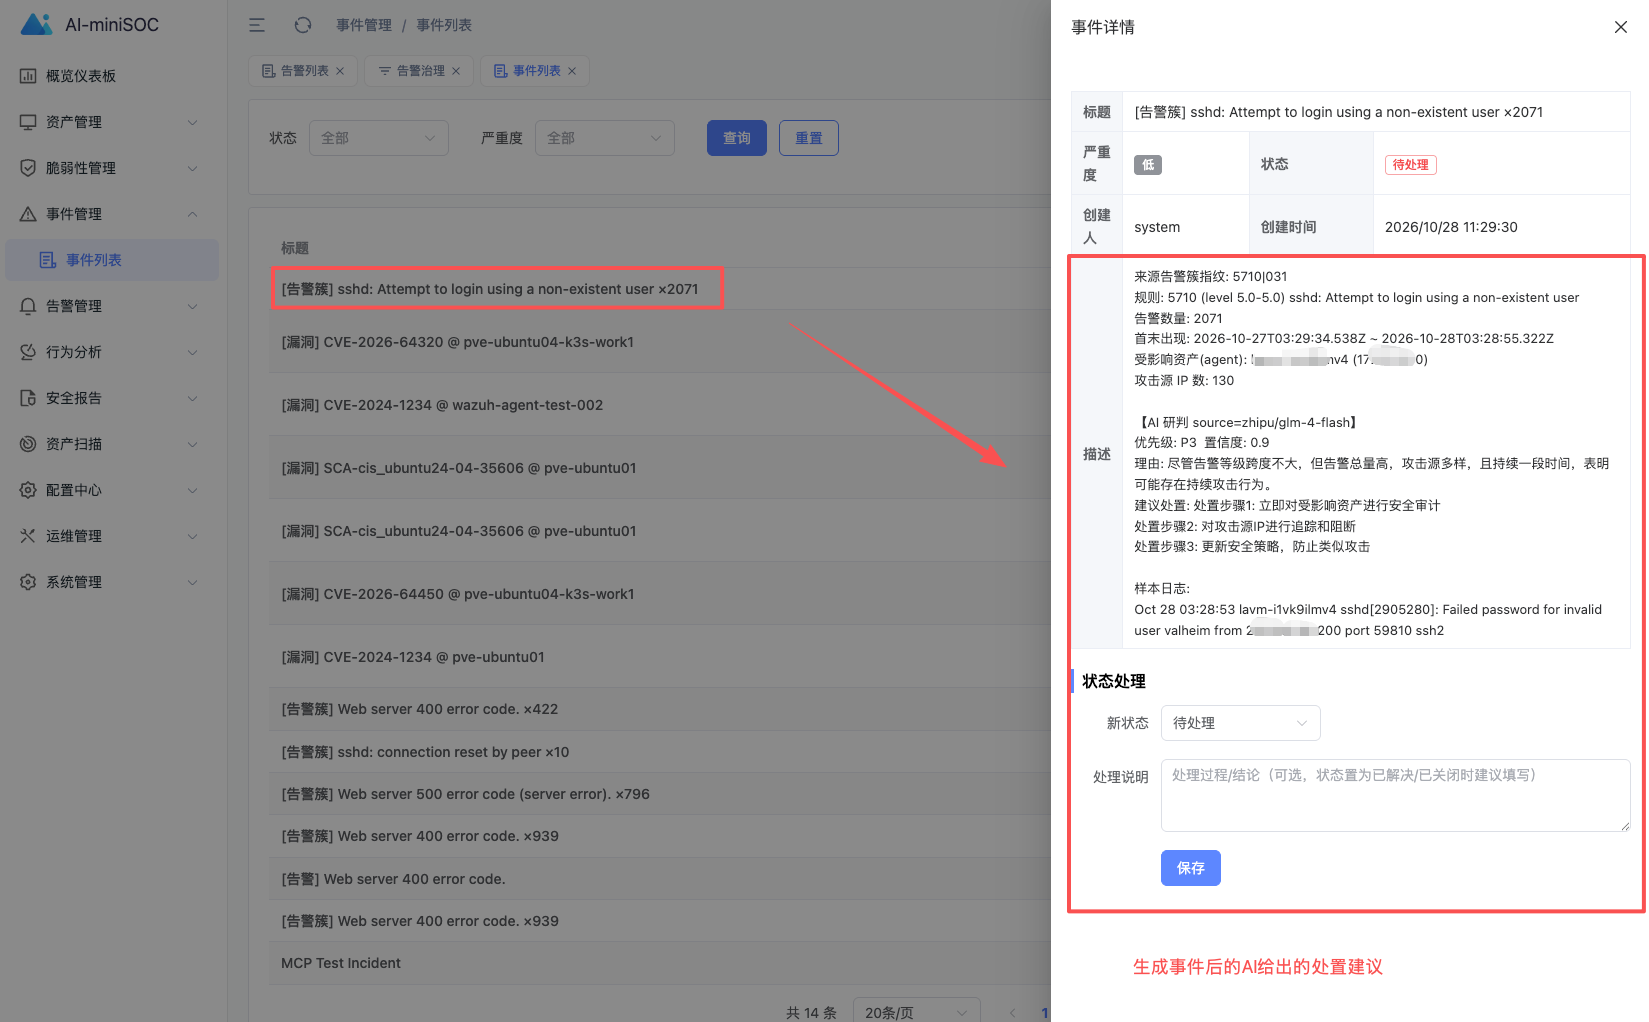
一键交接——“按 AI 建议建事件"按下后,事件列表出现 [告警簇] sshd: ... ×2071,描述里自动带上了聚类信息(指纹/规则/量级/130 个攻击源)和完整的 AI 研判结论(P3、置信度 0.9、理由、三步建议)。从 2 万条告警到一个带着处置建议的事件单,一次点击:
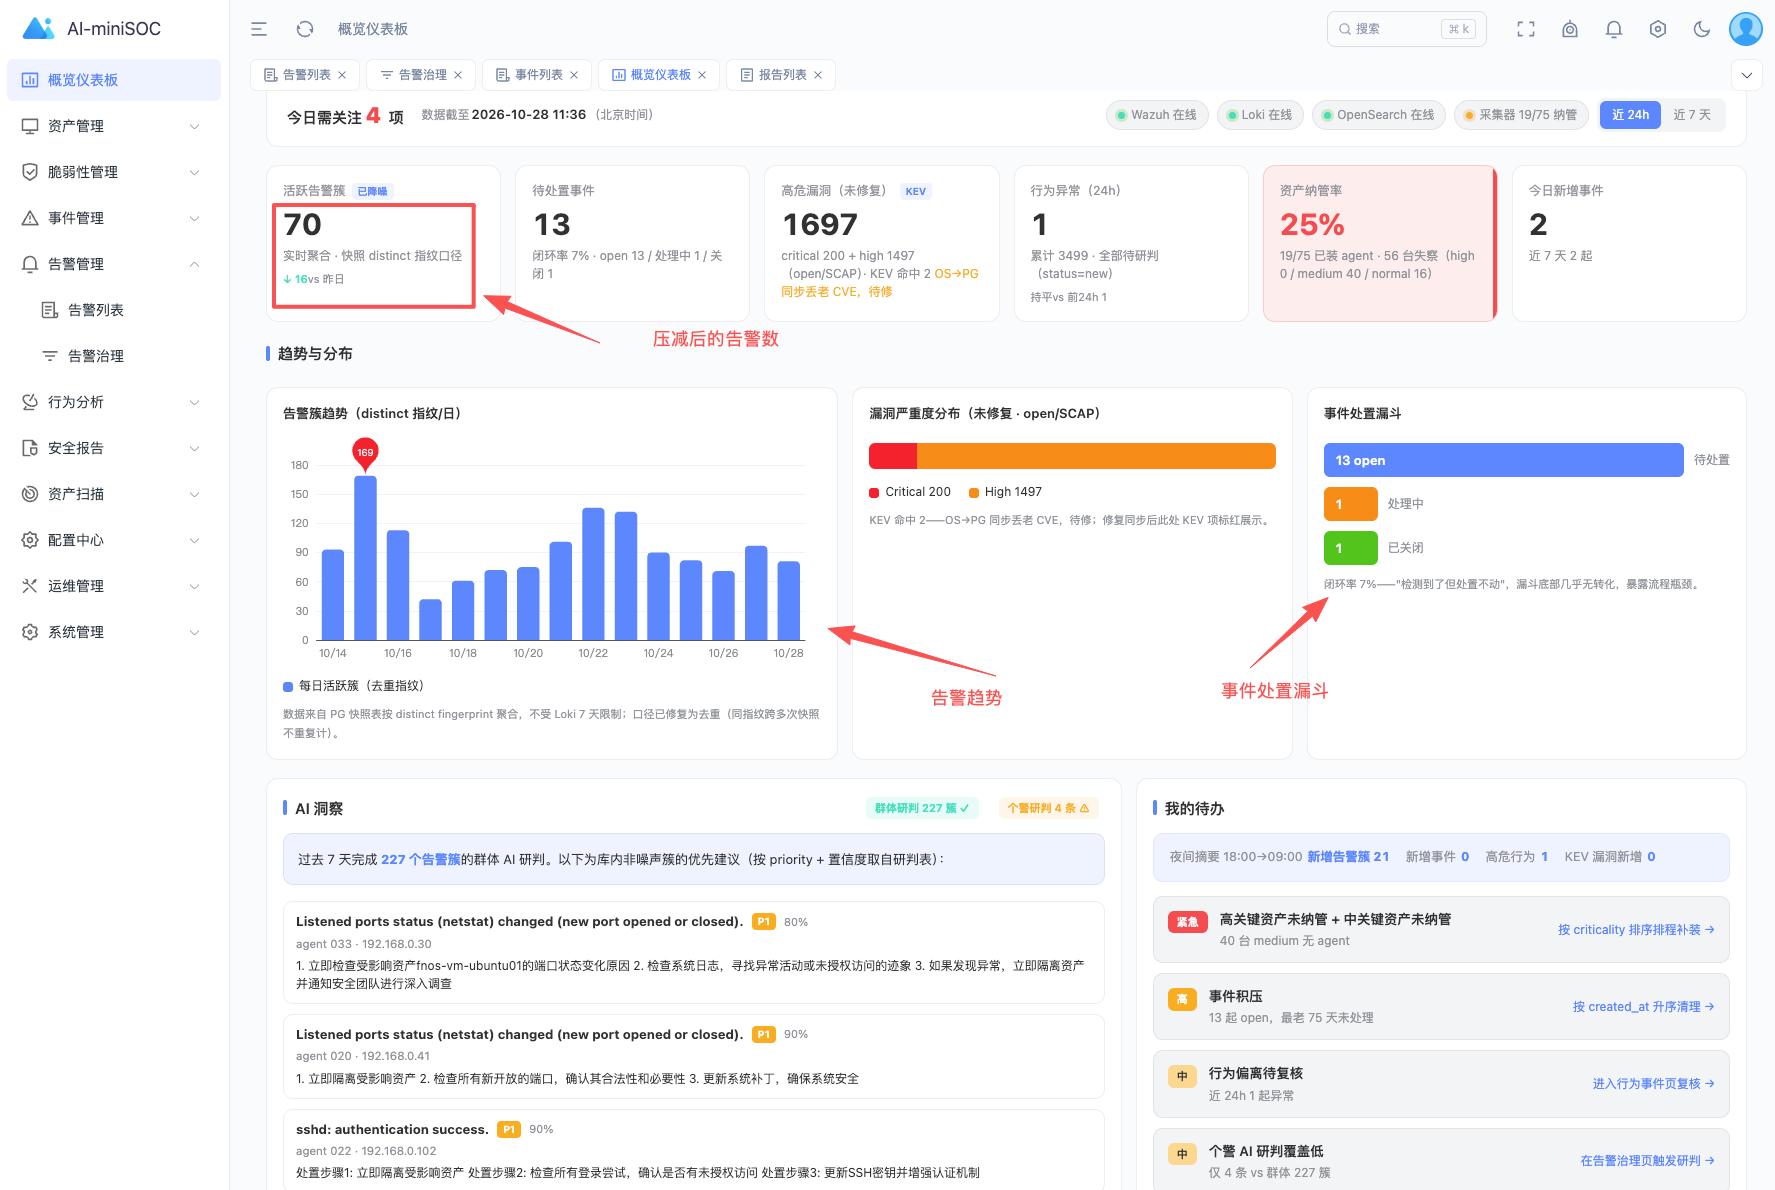
日常打开系统看到的第一屏——仪表板顶部 KPI:活跃告警簇 70(已降噪,环比还降了 16),而非原始告警数;旁边配告警簇趋势图和事件处置漏斗。注意 AI 洞察区的诚实细节:个量研判覆盖偏低时会打 ⚠ 提醒,不装全覆盖:
踩坑记录:三个真实翻车点
坑一:路由顺序,/alerts/groups 被 catch-all 抢匹配。 alerts.py 里已有的 GET /{alert_id} 是个 catch-all,新加的 /alerts/groups 一上线就 404——请求被 /{alert_id} 抢走,把 “groups” 当成了 alert_id。修法:把 alert_digests 路由在 alerts 之前注册。FastAPI 按注册顺序匹配,catch-all 必须最后注册——这是框架级常识,但只有踩过才真的记得。
坑二:get_alert_by_id 长期 404 的陈年 bug。 详情接口按 _id(OpenSearch 内部 ID)查,但列表接口暴露给前端的却是 _source.id(Wazuh 告警自身 ID)——两个 ID 天然对不上,详情 404 存在了很久没人发现(因为列表页点详情之前没人真用过)。做事件交接(Phase 3)时才顺带修复:改为 bool.should(term.id, ids._id) 合并查询,两个 ID 都能查到。教训:同一实体两种 ID 是埋雷设计,接口对齐测试要覆盖"列表→详情"路径。
坑三:四套阈值的产生方式——每次都"就地写个数字”。 没有人故意制造 4 套阈值,每个写 12 的开发者都觉得"这里就是判断一下高危”,顺手写了个数字。等发现时模糊带里已经躺着 4,921 条告警。修法(阈值统一)不难,难的是防复发——所以有了"禁止裸数字比较"的纪律和 re-export 兼容层。教训:魔法数字的问题不在写下去的那一刻,在三个月后没人记得它为什么是这个值。
为什么"告警治理"是 SOC 的生死线
市面上"AI + SOC"的演示永远挑最漂亮的场景:一条高级威胁告警进来,AI 一键溯源出报告。真实世界的敌人不是高级威胁,是每天 5,000 条里挑出值得看的那 20 条。
一个人 SOC 能不能活下去,不取决于 AI 多聪明,取决于三件事:
- 看得完——聚合把 103 万变成 45 再变成 20
- 信得过——口径统一,每个页面说的同一句话
- 做得完——TopN 带着处置建议来,一键交接成事件
告警治理的本质不是让告警变多或变少,是让每一条出现在你眼前的,都值得被看。
常见问题
Q:指纹三元组为什么是 rule + agent + srcip,不加时间窗?
A:时间窗由查询参数 hours 控制(查过去 24h/7d 的簇),而不是写进指纹——同一簇跨天查询时自然合并。若攻击者换 IP,会裂成多簇,这是有意的:不同源的攻击本来就该分开看(141 个源 IP 的例子里,每个 IP 是独立线索)。
Q:45 个簇还是太多怎么办?
A:三个旋钮按需拧紧:min_group_count 调到 5(只看 ≥5 条的簇)、suppress_rule_ids 加入你的已知良性规则、triage_top_n 控制研判深度。治理参数全部热调,不用改代码。
Q:AI 研判错了怎么办?
A:三层兜底。输出带 confidence 和 rationale(错了能定位为什么错);suggest_incident 只是建议,建事件永远是人点的按钮(13 篇"写操作可控"的延续);研判缓存 7 天,人工确认过的结论可复用。
Q:13/10/7/4 是 Wazuh 的标准,其他数据源怎么办?
A:alert_levels.py 定义的是"本项目分级口径",Wazuh 的 level 是它的输入。接入新数据源时在该源接入层做 level 映射(宁缺勿错:映射不了的先归 low),口径层永远只有一套。
Q:怎么给我的系统做告警治理?
A:别从买 AI 开始。三步:① 先做聚合——按"威胁类型×资产×来源"归簇,这一步零 AI 就能把量降两个数量级;② 统一口径——把你系统里所有分级阈值找出来收编成一个文件,禁止裸数字;③ 才轮到 AI——对 TopN 簇做研判排序。顺序不能反:先聚合再 AI,AI 研判的是簇不是海;先统一口径再推送,推出去的话才有公信力。
收尾:14 在系列中的位置
| 系列主线 | 篇目 |
|---|---|
| AI 副手五部曲 | 09-13 |
| 工程化·告警治理(运营生死线) | 14(本篇) |
| 工程化·权限矩阵 / CI-CD | 15 / 16 |
AI 副手讲完了,14 篇起回到工程化——而工程化的第一篇选告警治理,因为它决定一个人的 SOC 能不能活:爆表的告警杀死注意力,混乱的口径杀死信任。15 篇讲权限矩阵——几个人共用系统时,谁 能看什么、谁能动什么。
老李现在的早晨是这样的:8 点推送进来,“昨日 5,176 条告警归并为 43 簇,必处理 5 个”。 他点开 Top1——P1,SSH 爆破,涉及 2 台资产,AI 建议封禁 3 个源 IP 并给出了理由。 他扫了眼 rationale 和证据,点了"按 AI 建议建事件",顺手封了 IP。 从推送到处置完成,7 分钟。 而一年前的这一天早晨,他面对的是 5,176 行没有排序的列表——和一杯凉掉的咖啡。
告警治理不是功能,是注意力的守护战。守住它,一个人的 SOC 才守得住。
【系列导航】《一个人的SOC》总目录(持续更新)
【上一篇】(13) AI Agent 与 MCP——让 Claude 直接操作你的 SOC
【系列开篇】(00) 中小企业为什么需要自己的安全运营中心
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐
【Gitee 镜像】 https://gitee.com/xiejava/AI-miniSOC
【交流】 你的系统里有多少套分级阈值?做个 grep 试试——超过一套的,欢迎来 Issue 对答案。
下一篇(预告):(15) 权限矩阵——admin/operator/viewer/auditor 端点级隔离(连载中,敬请关注)
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!