上一篇 (06) 资产对账我们学了 F1.3——它能告诉你"台账和实际数据差在哪",三类差异清清楚楚列出来。但你跑 F1.3 时一定会撞上一个新问题:
“为什么今天突然有 50 条 shadow?是新增了 50 台新设备吗?还是 5 条新设备,剩下 45 条其实早就在,只是昨天没跑对账?”
更让人头疼的是——你分不清数据流在哪个环节坏了:
- 采集器没收到数据? → 那你看到的"差异"其实是"看不见的真实"
- 采集器收到了但同步失败? → 那你看到的"差异"是"看见但没写进来"
- 同步成功但台账没对账? → 那你看到的"差异"是"该算的没算"
这是三个不同问题,解法也完全不同。
本篇解的就是当数据"看起来不对"时,怎么 30 秒内定位是哪一层坏了——靠的是把"源健康 + 同步死信 + 对账差异"三层信号聚到一个看板上。
为什么 SOC 也需要"数据可靠性"?
直说原因——F1.3 的输出严重依赖它前面两层的健康:
如果 Loki 断了 1 小时,F1.3 跑的时候拿到的就是"1 小时前的数据"——它依然会输出’无差异’,而你以为是’今天没问题’。
错。是你没看到今天的问题。
这就是 06 篇里那条硬约束——“源不新鲜时禁止静默给无差异结论”——的来源。数据可靠性是把那条约束从一句口号,变成一个有数字有事实的看板。
这一篇的实质是:让你不再"被自己骗"。
三层健康聚合:一张图说清"数据流哪一层坏了"
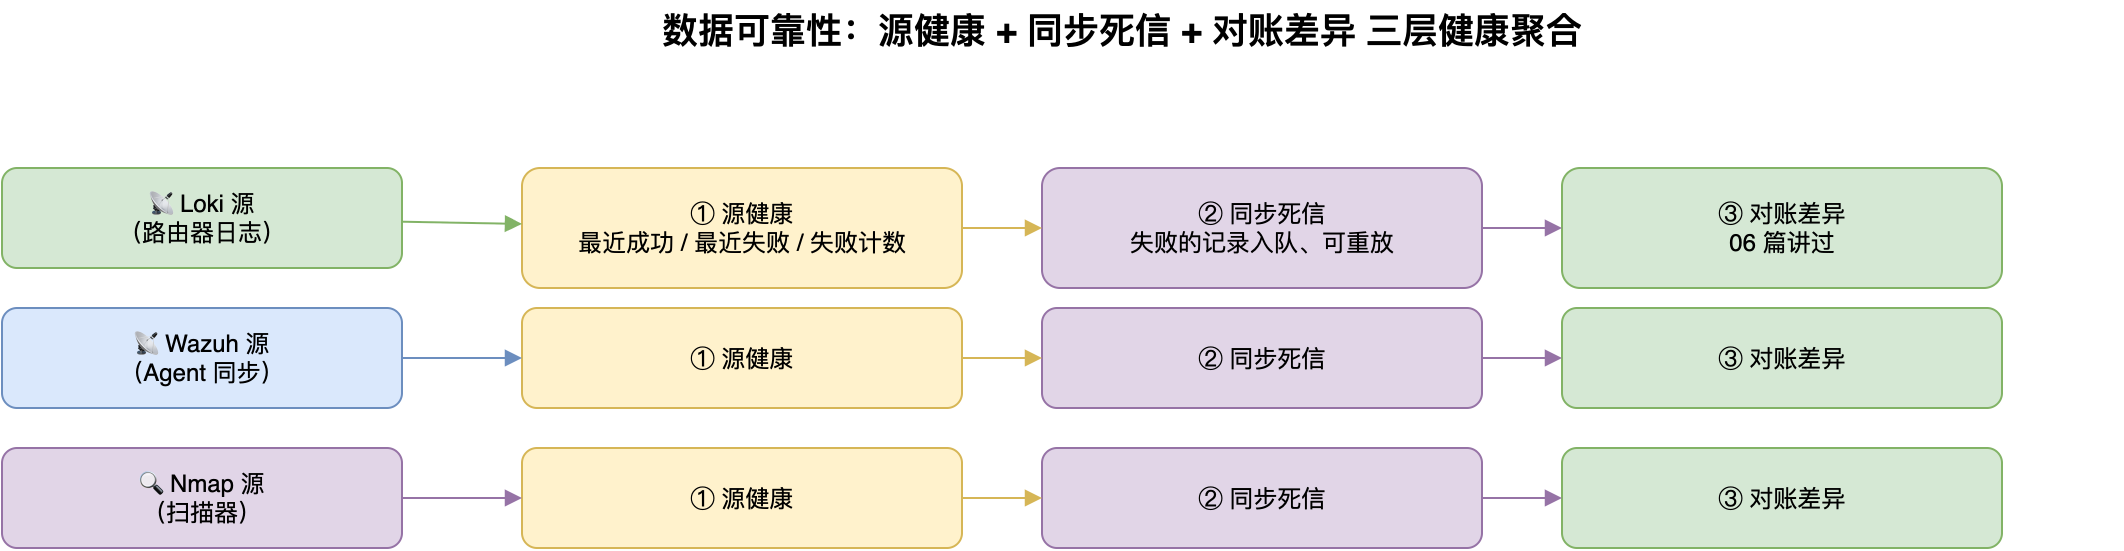
这三层是从左到右的因果链:
采集器 → 同步管道 → 对账引擎 → 你看到的"差异"
  ①        ②          ③
  ↓         ↓           ↓
源健康  同步死信    对账差异
关键洞察:一个源头出问题,会同时让三层都变红——但只有识别出"哪一层先变红",才能知道根因。
| 三层 | 监控对象 | 出问题的现象 |
|---|---|---|
| ① 源健康 | 采集器有没有成功拉到数据 | 卡片红 = 数据源断了/失败 |
| ② 同步死信 | 数据有没有成功写进库 | 卡片红 = 数据进了但写不进去 |
| ③ 对账差异 | 06 篇的台账 vs 实际 | 卡片红 = 台账和实际对不上 |
🎯 实战判断:
- 只有 ③ 变红 + ①② 都绿 → 业务层问题(设备变动、IP 飘了)
- ①②③ 全红 → 先修①(源头都没数据,下游不可能对)
- ① 绿 + ②③ 红 → 先修②(数据有了但写不进去)
- ①② 绿 + ③ 特别红 → F1.3 配置/基线问题,不是数据问题
这就是"30 秒定位"的根因。
实战:看一次健康看板
控制台 → “数据健康” 页就是你刚才看的那张图的全貌。
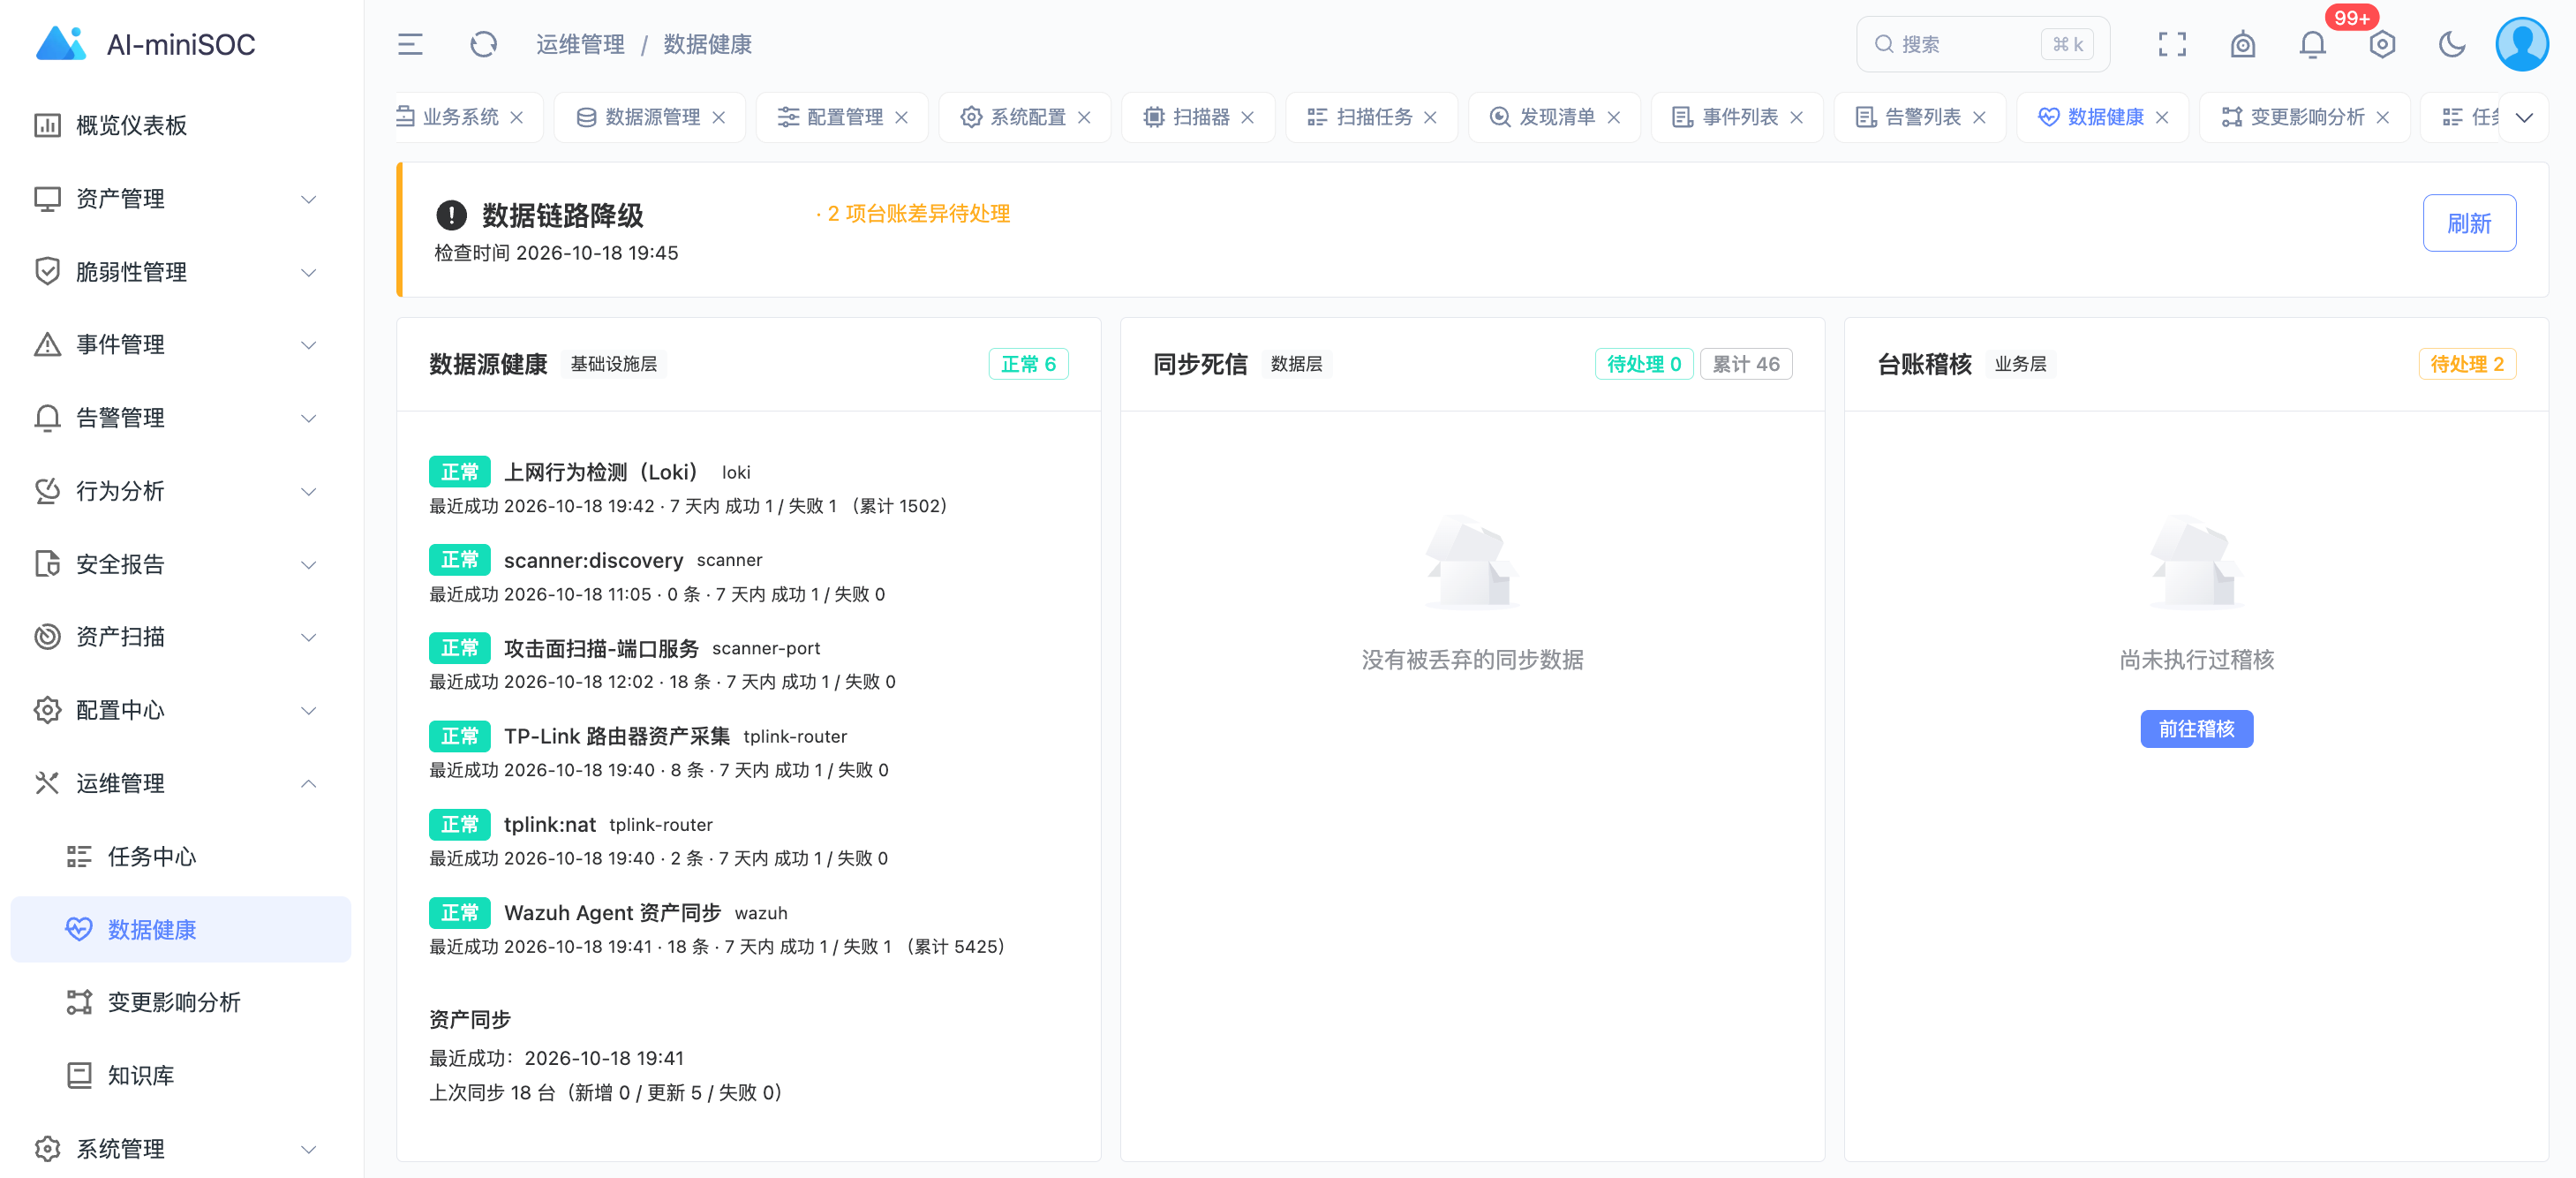
第一次打开这个页面会看到什么?根据你的网络规模不同,大致是:
- 源健康:3 个采集器(Wazuh/TP-Link/Nmap)状态灯——
online/offline/stale(数据 24h 没更新) - 同步死信:失败记录数(新手一般 0;网络抖动时偶尔 1-2 条)
- 对账差异:shadow / offline / mismatch 三类数字
重点看趋势小图——某一条线突然陡增 = 出事了。
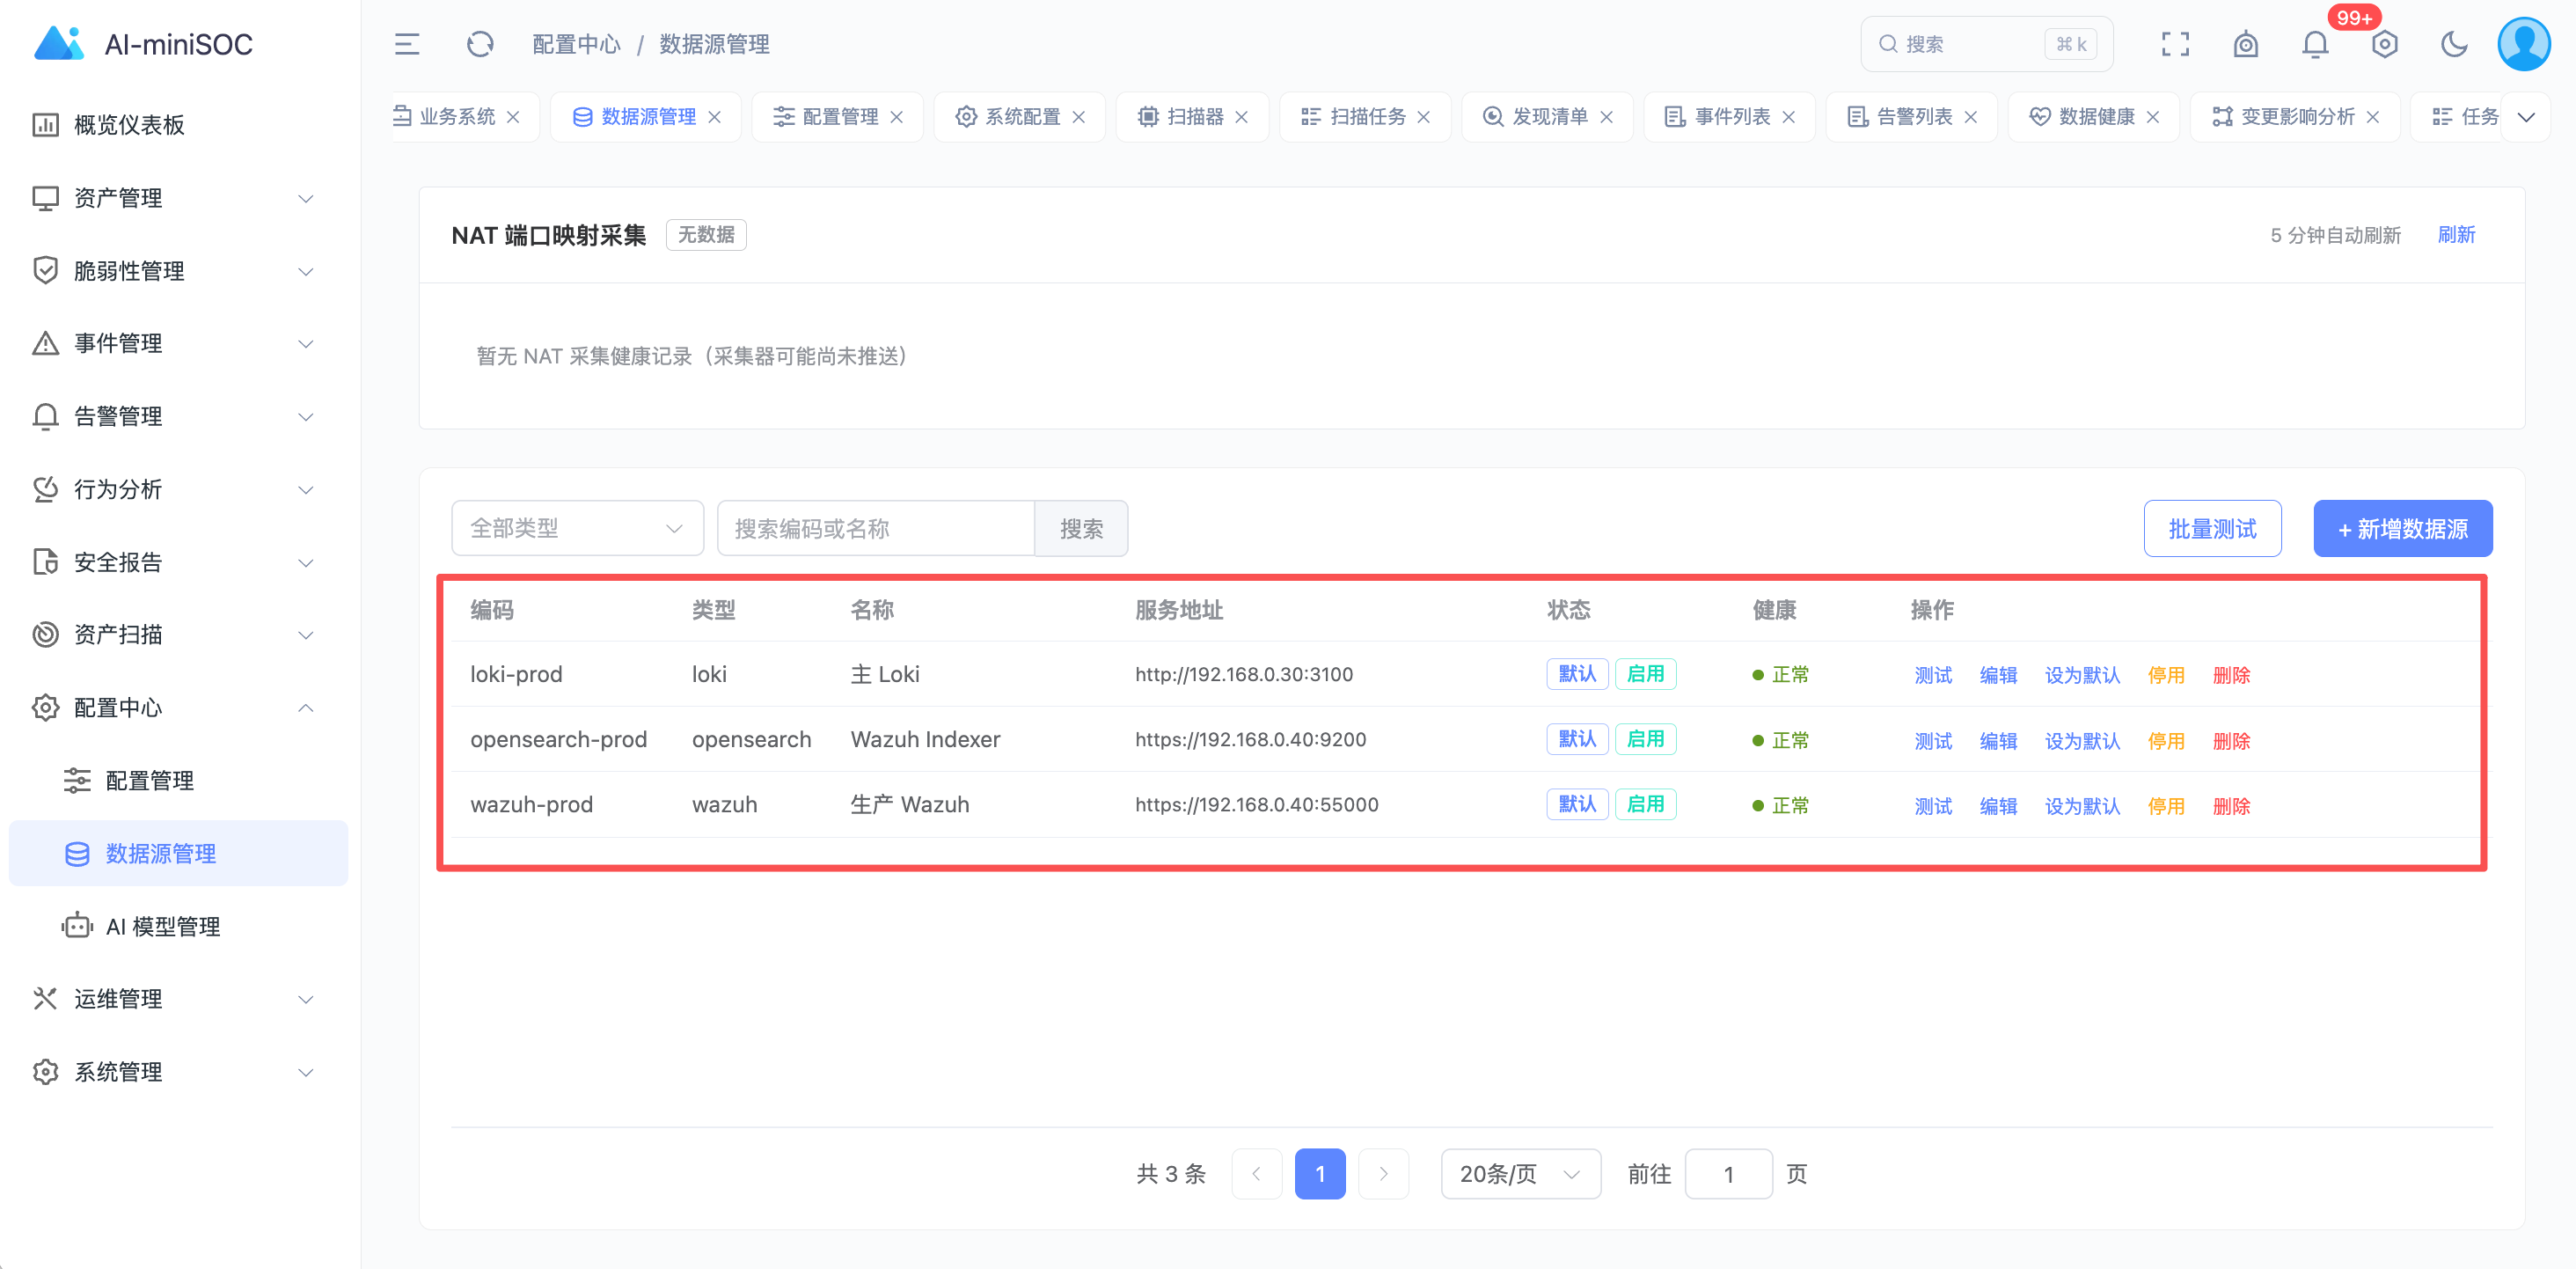 各源健康状态:采集器健康度红黄绿三色
⚠️ 关键约束(06 篇里也讲过,这里再强调一次):任何一个源 24 小时没成功同步,状态灯必须变红。看到红灯别先怪系统——那是设计行为,提醒你"这个源已经断了一阵"。
死信队列:失败的记录去哪了?
你可能想问:“源健康失效"和"同步死信"听起来都像"失败了”——区别是什么?
源健康失效 = 采集器没拉到数据(网络问题、采集器宕机、凭据过期); 同步死信 = 采集器拉到了但写不进库(schema 不匹配、字段越界、关联约束冲突)。
两者的处理路径完全不同。来看看一条数据"从采集器到 SOC"会走哪条路:
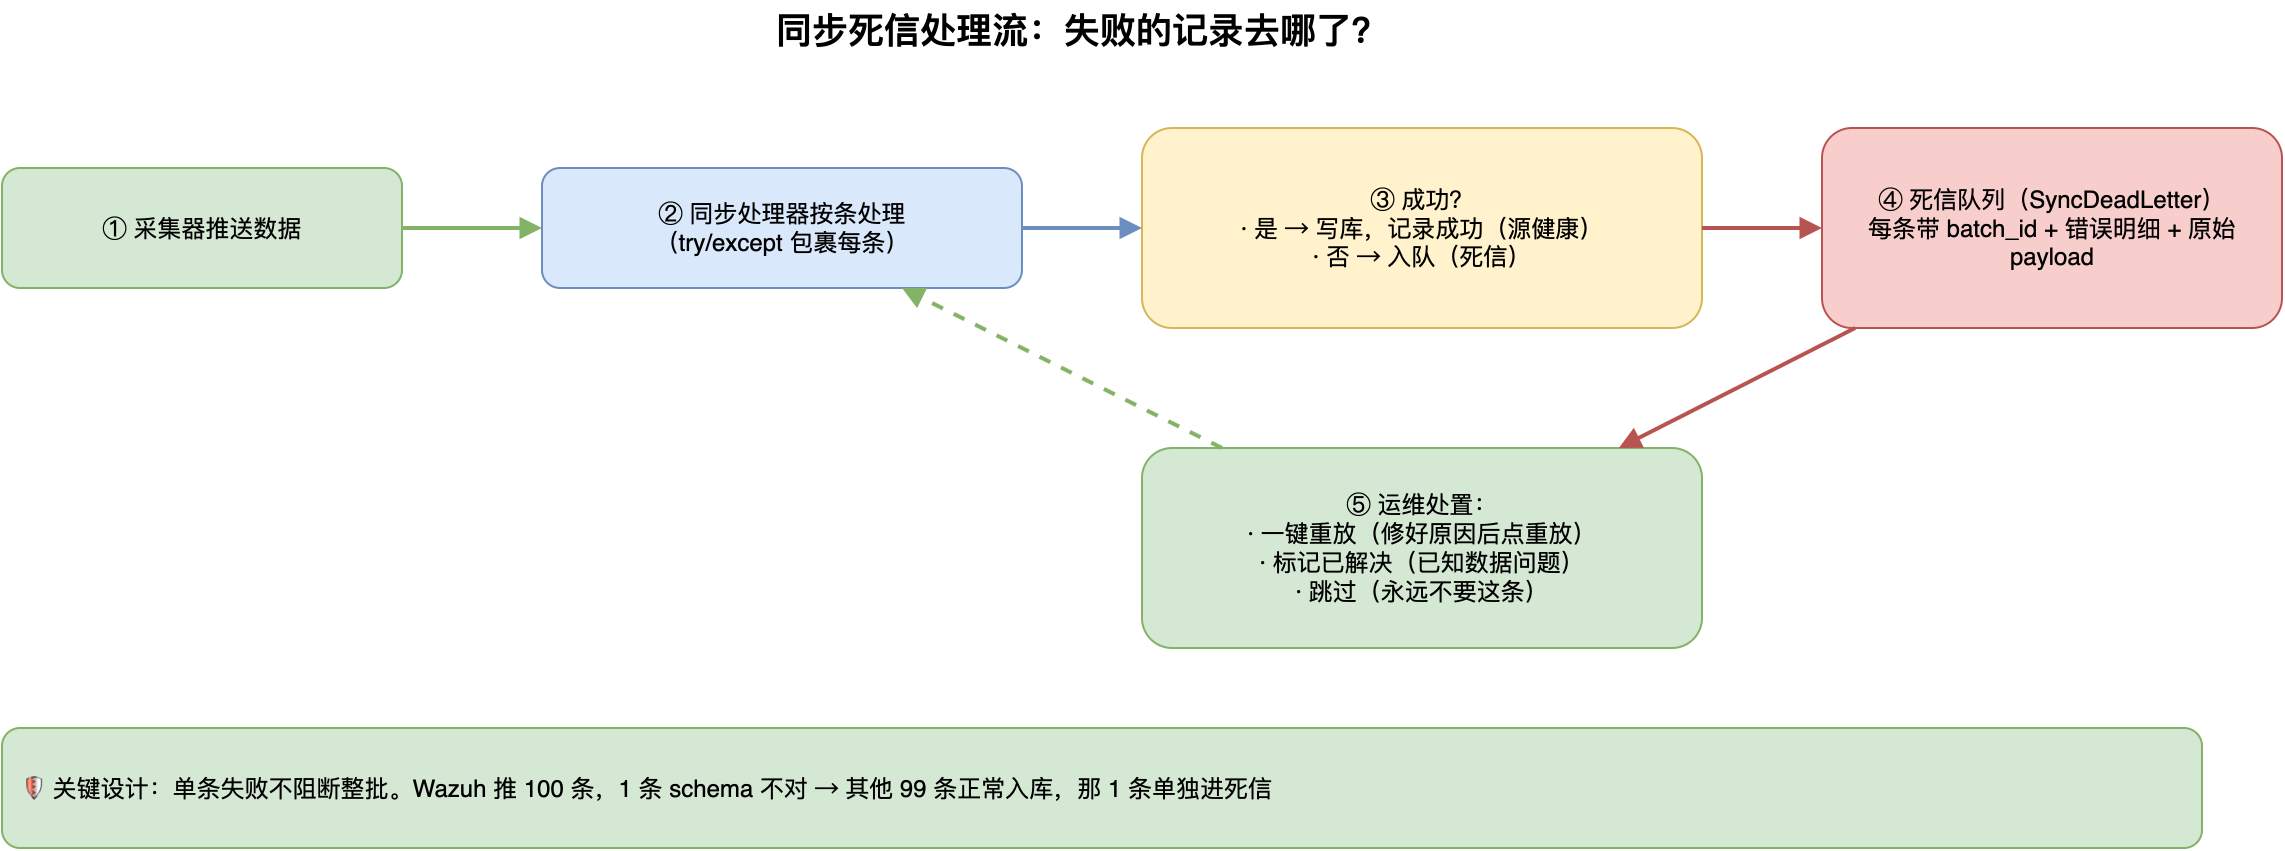
关键设计(这是 F1.3 同源思想):单条失败不阻断整批。Wazuh 推 100 条来,1 条 schema 不对 → 其他 99 条正常入库,那 1 条单独进死信。你随时可以从死信页查到它、修好它、让它重放。
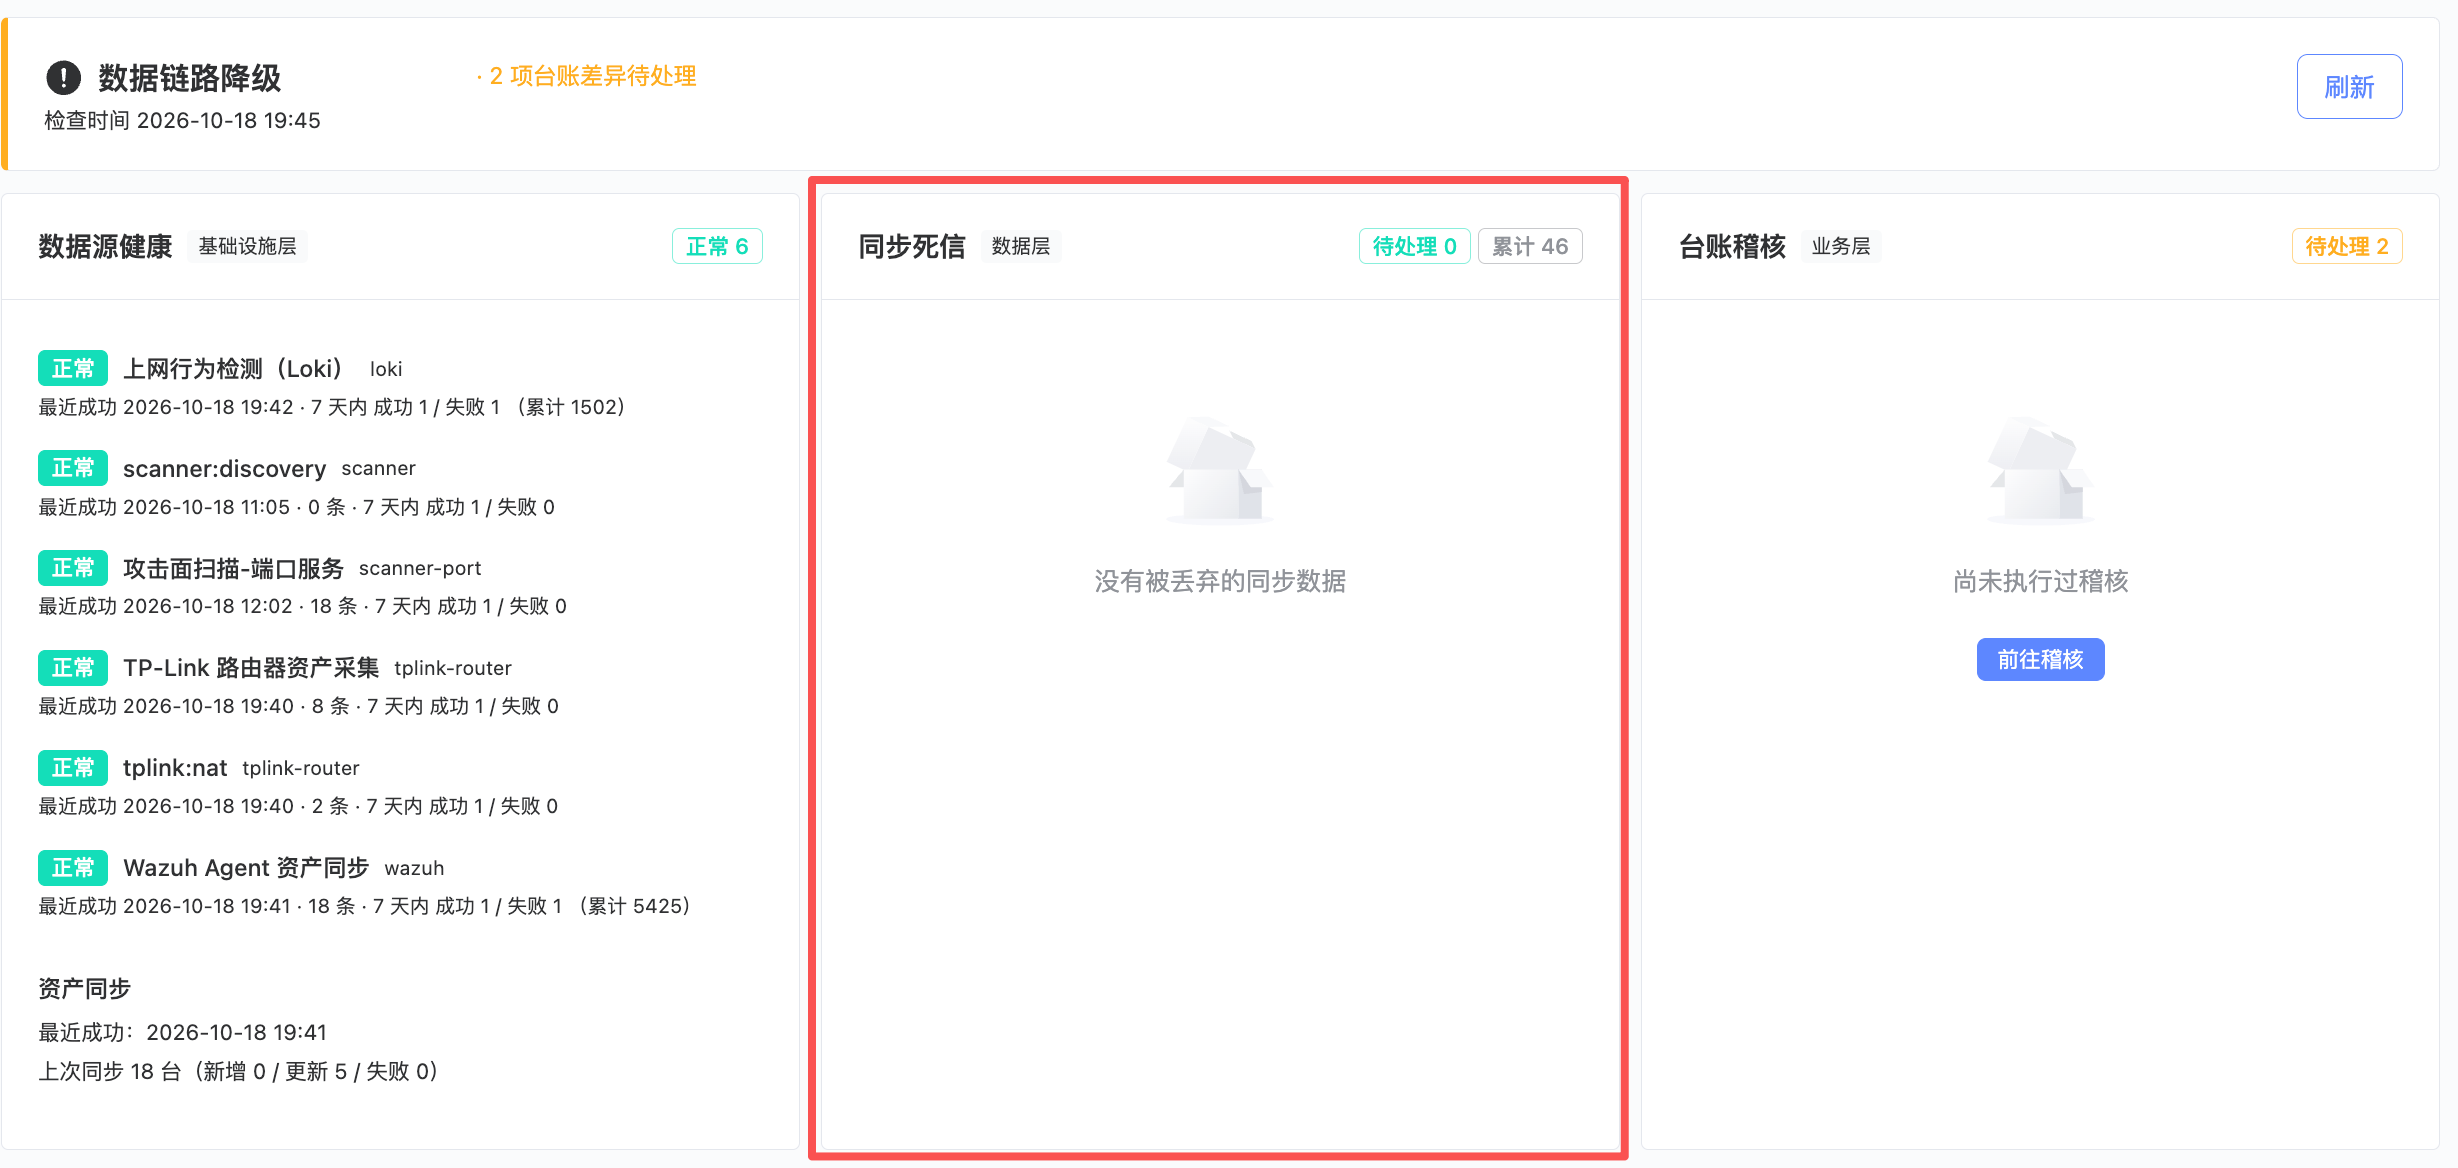 死信计数提示:资产对账页顶部的「X 条死信待处理」一行
💡 为什么"失败不阻断整批"很重要? 因为网络抖动、字段变更、版本升级都太常见了——让 99% 的好数据进得来,比让 1% 的坏数据卡住整批更划算。
处置死信:3 个动作
当死信出现时,你绝大多数时候只有 3 个选择:
| 动作 | 什么时候用 | 结果 |
|---|---|---|
| 一键重放 | 你刚修好代码/字段/约束,回到正常状态了 | 死信记录重走一遍同步流程,成功就标已解决、失败就重新入队 |
| 标记已解决 | 数据"错"是有意为之(比如设备真的下线了,但台账还没改) | 直接标 resolved,永远不再重试 |
| 跳过 | 这条数据永远不要 | 标 ignored,不重试也不阻塞后续 |
💡 典型场景:
- 8 月 23 日我们做了一次代码更新,旧 schema 的数据进死信了——重放一次就解决了;
- 路由器固件升级后 IP 格式变了,3 条死信——改完解析代码后重放;
- 测试期间主动 push 的一些奇怪格式的 payload——直接标记已解决,永远不重试。
常见问题
Q:源健康红 + 死信 0 + 对账差异爆增——什么情况?
A:这是经典"采集器长时间不工作"模式:数据没进 → 看不到死信(因为没东西进失败)→ 但台账与实际差距越来越大。根因在源头,先修采集器(网络/凭据/容器)。
Q:源健康绿 + 死信 100 + 对账差异只增不减——什么情况?
A:典型"schema 升级但代码没跟上"模式:数据在进,但写不进去。根因在管道,看死信详情里的错误码,大部分会是字段类型/约束。
Q:什么时候该重放 vs 跳过?
A:看错误码。重放 = 你修了什么,预期这次会成功(代码改完、字段加完)。跳过 = 你承认这条数据永远不该进来(测试数据、过期格式、已知设备下线)。
Q:F1.3 报"shadow 50 条",先看 07 的看板还是先处理?
A:先看 07 的看板。如果 ① 源健康有红灯,shadow 可能是"采集器突然回了"或"突然没回"造成的假信号——修了源头再看,不然处理到一半发现是"数据本身不准"。
收尾:07 在系列中的位置
到本篇为止,你的 SOC 不只是"看见"和"看清"——还多了一层**“自我诊断”**:
| 阶段 | 能力 | 来源 | 篇目 |
|---|---|---|---|
| 看得见 | 三路数据源拼接 | Wazuh + TP-Link + Nmap | 03 / 04 / 05 |
| 看得真 | 资产台账真实性稽核 | 资产对账(F1.3) | 06 |
| 看得真且不被骗 | 三层健康聚合 | 数据可靠性看板 | 07(本篇) |
接下来 08 篇会进一步把"多源数据不一致时信哪个"——身份可信度评分解决最后一个"真"的问题。
老李上周发现一个诡异现象:F1.3 突然报 30 多条 shadow。 他慌了 5 分钟,然后点开 07 看板——所有源状态绿 + 死信 0。 5 分钟后他意识到:不是有人搞事,是上周换了办公楼、所有人手机重新连了 5GHz 而不是 2.4GHz,路由器把新 MAC 都报给采集器了。 看完看板、知道根因后,他点"一键纳管"批量处理了 30 多条。
没有 07 的看板,他会花两小时翻日志找"是不是被攻击了"。
老李的看板救了他一晚上睡眠时间。你的呢?
【系列导航】《一个人的SOC》总目录(持续更新)
【上一篇】(06) 资产对账——影子/离线/不匹配三类差异稽核
【系列开篇】(00) 中小企业为什么需要自己的安全运营中心
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐ **【Gitee 镜像】**https://gitee.com/xiejava/AI-miniSOC
【交流】 看板上看到 3 个源都变红怎么办?别慌——把死信列表的截图发 Issue,我帮你按"先源头、再管道、最后对账"的顺序诊断。
下一篇:[待 08 完成后补充链接]
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!