这是一份两段的实测记录。第一段讲安装部署:我把开源的 SoduWork Hub 搬到自己服务器,怎么装、怎么配、怎么验;第二段讲实测:把 AI-miniSOC 一组真实的开发需求交给 Agent,走完「提需求 → 执行 → 初审返修 → 验收」的闭环,两条 commit 为证。
环境:macOS + SoduWork.app 1.13.19(客户端)+ 自建 Hub(局域网
192.168.0.128,经 Cloudflare 暴露为sudowork.doai8.dpdns.org)。
先说结论
- 部署:Hub 装在一台独立的宿主机上,客户端在另一台 Mac,两条网络路径(局域网直连、公网隧道)都通,鉴权真的在拦人;管理端配好用户、模型、项目,两台客户端在线干活;
- 实测:Agent(内置的 Pi,跑智谱 GLM)在 AI-miniSOC 仓库里完成了一组真实需求——暴露面分析页改 Tab 布局,只动一个文件
+51/−34,交付报告自带真实浏览器实测证据,初审抓到一个换行瑕疵打回返修+2/−1,两条 commit 落库,三条需求当天全部验收关闭; - 一个值得所有人先看一眼的细节:动手前先摸清自己在哪台机器上——我的客户端内网地址实际是
192.168.0.29 / .31,Hub 在192.168.0.128,不是「在自己电脑上开一个 Hub」,而是一台机器跑 Hub、另一台机器当客户端。这个区分决定了后面所有验证该怎么设计。
先认识一下:SoduWork 是什么,能干什么
直接讲安装实测之前,先把主角交代清楚——不然「为什么要看一个人装它」就成了悬案。
SoduWork 是一个开源(MIT 协议)的企业级 AI 原生引擎,官方给它的定义是「数字 AI 员工,先有数字方法论:沉淀团队最佳实践,驱动多岗位、多 Agent 接力与协同」。说人话:普通 AI 工具的基本单元是对话,SoduWork 的基本单元是需求——对话以答案结束,需求以签字结束。
它瞄准的是用 AI 干活时最典型的四个困境:
| 常见困境 | SoduWork 的做法 |
|---|---|
| AI 做得快,检查太困难,省下的时间又花在核对上 | 需求即标准:开工前写清验收标准,AI 初审逐条对照,人最终签字 |
| 对话做完了,方法没留下,换个人从头再来 | 沉淀为插件:和 AI 把事做对一次,做法变成团队资产,改进一次全员同步 |
| AI 的产出进不了协作流程,靠复制粘贴交接 | 需求池人机接力:需求、上下文、进展随需求流转,人和 Agent 接手即用,谁做了哪一步全程可查 |
| 换个模型、换个 Agent 底座就得推倒重来 | 多底座自由调度:每个步骤各选 Agent 和模型,随时更换,无需重建 |
支撑这三件事的三个核心理念:调度智能(选对 Agent 和模型,让合适的 AI 做合适的事)、治理闭环(谁能用什么 AI、在哪台机器上做什么,由组织决定;插件先审核再共享,用量成本和审计日志都有记录;支持私有化部署)、结果交付(先定标准再动手,独立的 AI 初审,最终由人确认)。
执行层不绑定任何一家:Pi 内置开箱可用,OpenCode、Codex、Kimi Code、Qwen Code、DeepSeek 等 9 种 Agent 运行时按需接入,同一个会话里还能随时切换、记录不丢。
而这一切的载体是同一个需求池:提需求 → AI 补全验收标准 → 交办(自己 · 同事 · Agent)→ Agent 执行 → AI 初审 → 需求方验收 → 沉淀为插件。本文第二部分会用一次真实需求,逐段走完这条链。
官方云开箱即用。我为什么还要折腾自托管、以及怎么折腾、折腾完怎么验证——接下来正文开始。
第一部分:安装部署——把 Hub 搬到自己服务器
为什么搬到自己服务器
官方云省心,但我更想把整套东西整个搬到自己服务器上:数据在自己的 PostgreSQL 里,Agent 在自己的机器上干活,模型密钥在自己手里——对一个安全从业者来说,这不是偏执,是职业习惯。好在私有化部署本来就是它的设计目标之一(治理闭环的一部分),这条路是铺好的。
一条命令起服务
自托管路径官方已经铺好,核心就一条命令:
| |
这条命令背后是 docker compose,起两个服务:
| 服务 | 说明 |
|---|---|
soduwork-hub | Hub 本体(FastAPI),我用源码构建,版本号显示 version=dev |
postgres:16-bookworm | 数据库,所有需求、记录、插件都在这个库里 |
几个值得点赞的安全细节:容器以专用 UID 10001 运行,不给 docker socket,最小权限起步;Hub 容器只绑宿主机回环地址,要对外服务得自己在前面放一层反向代理——默认姿态是「关着的」,露多少开多少,这个顺序是对的。
我的实际部署形态:Hub 在局域网一台宿主机 192.168.0.128 上,前置反向代理终结 TLS(证书是 SoduWork Local Root CA 签的,CN=192.168.0.128,有效期到 2036);公网入口用 Cloudflare Tunnel 回源,拿到 sudowork.doai8.dpdns.org 这个域名。TLS 的完整官方指南在仓库 docs/self-hosted-tls.md。
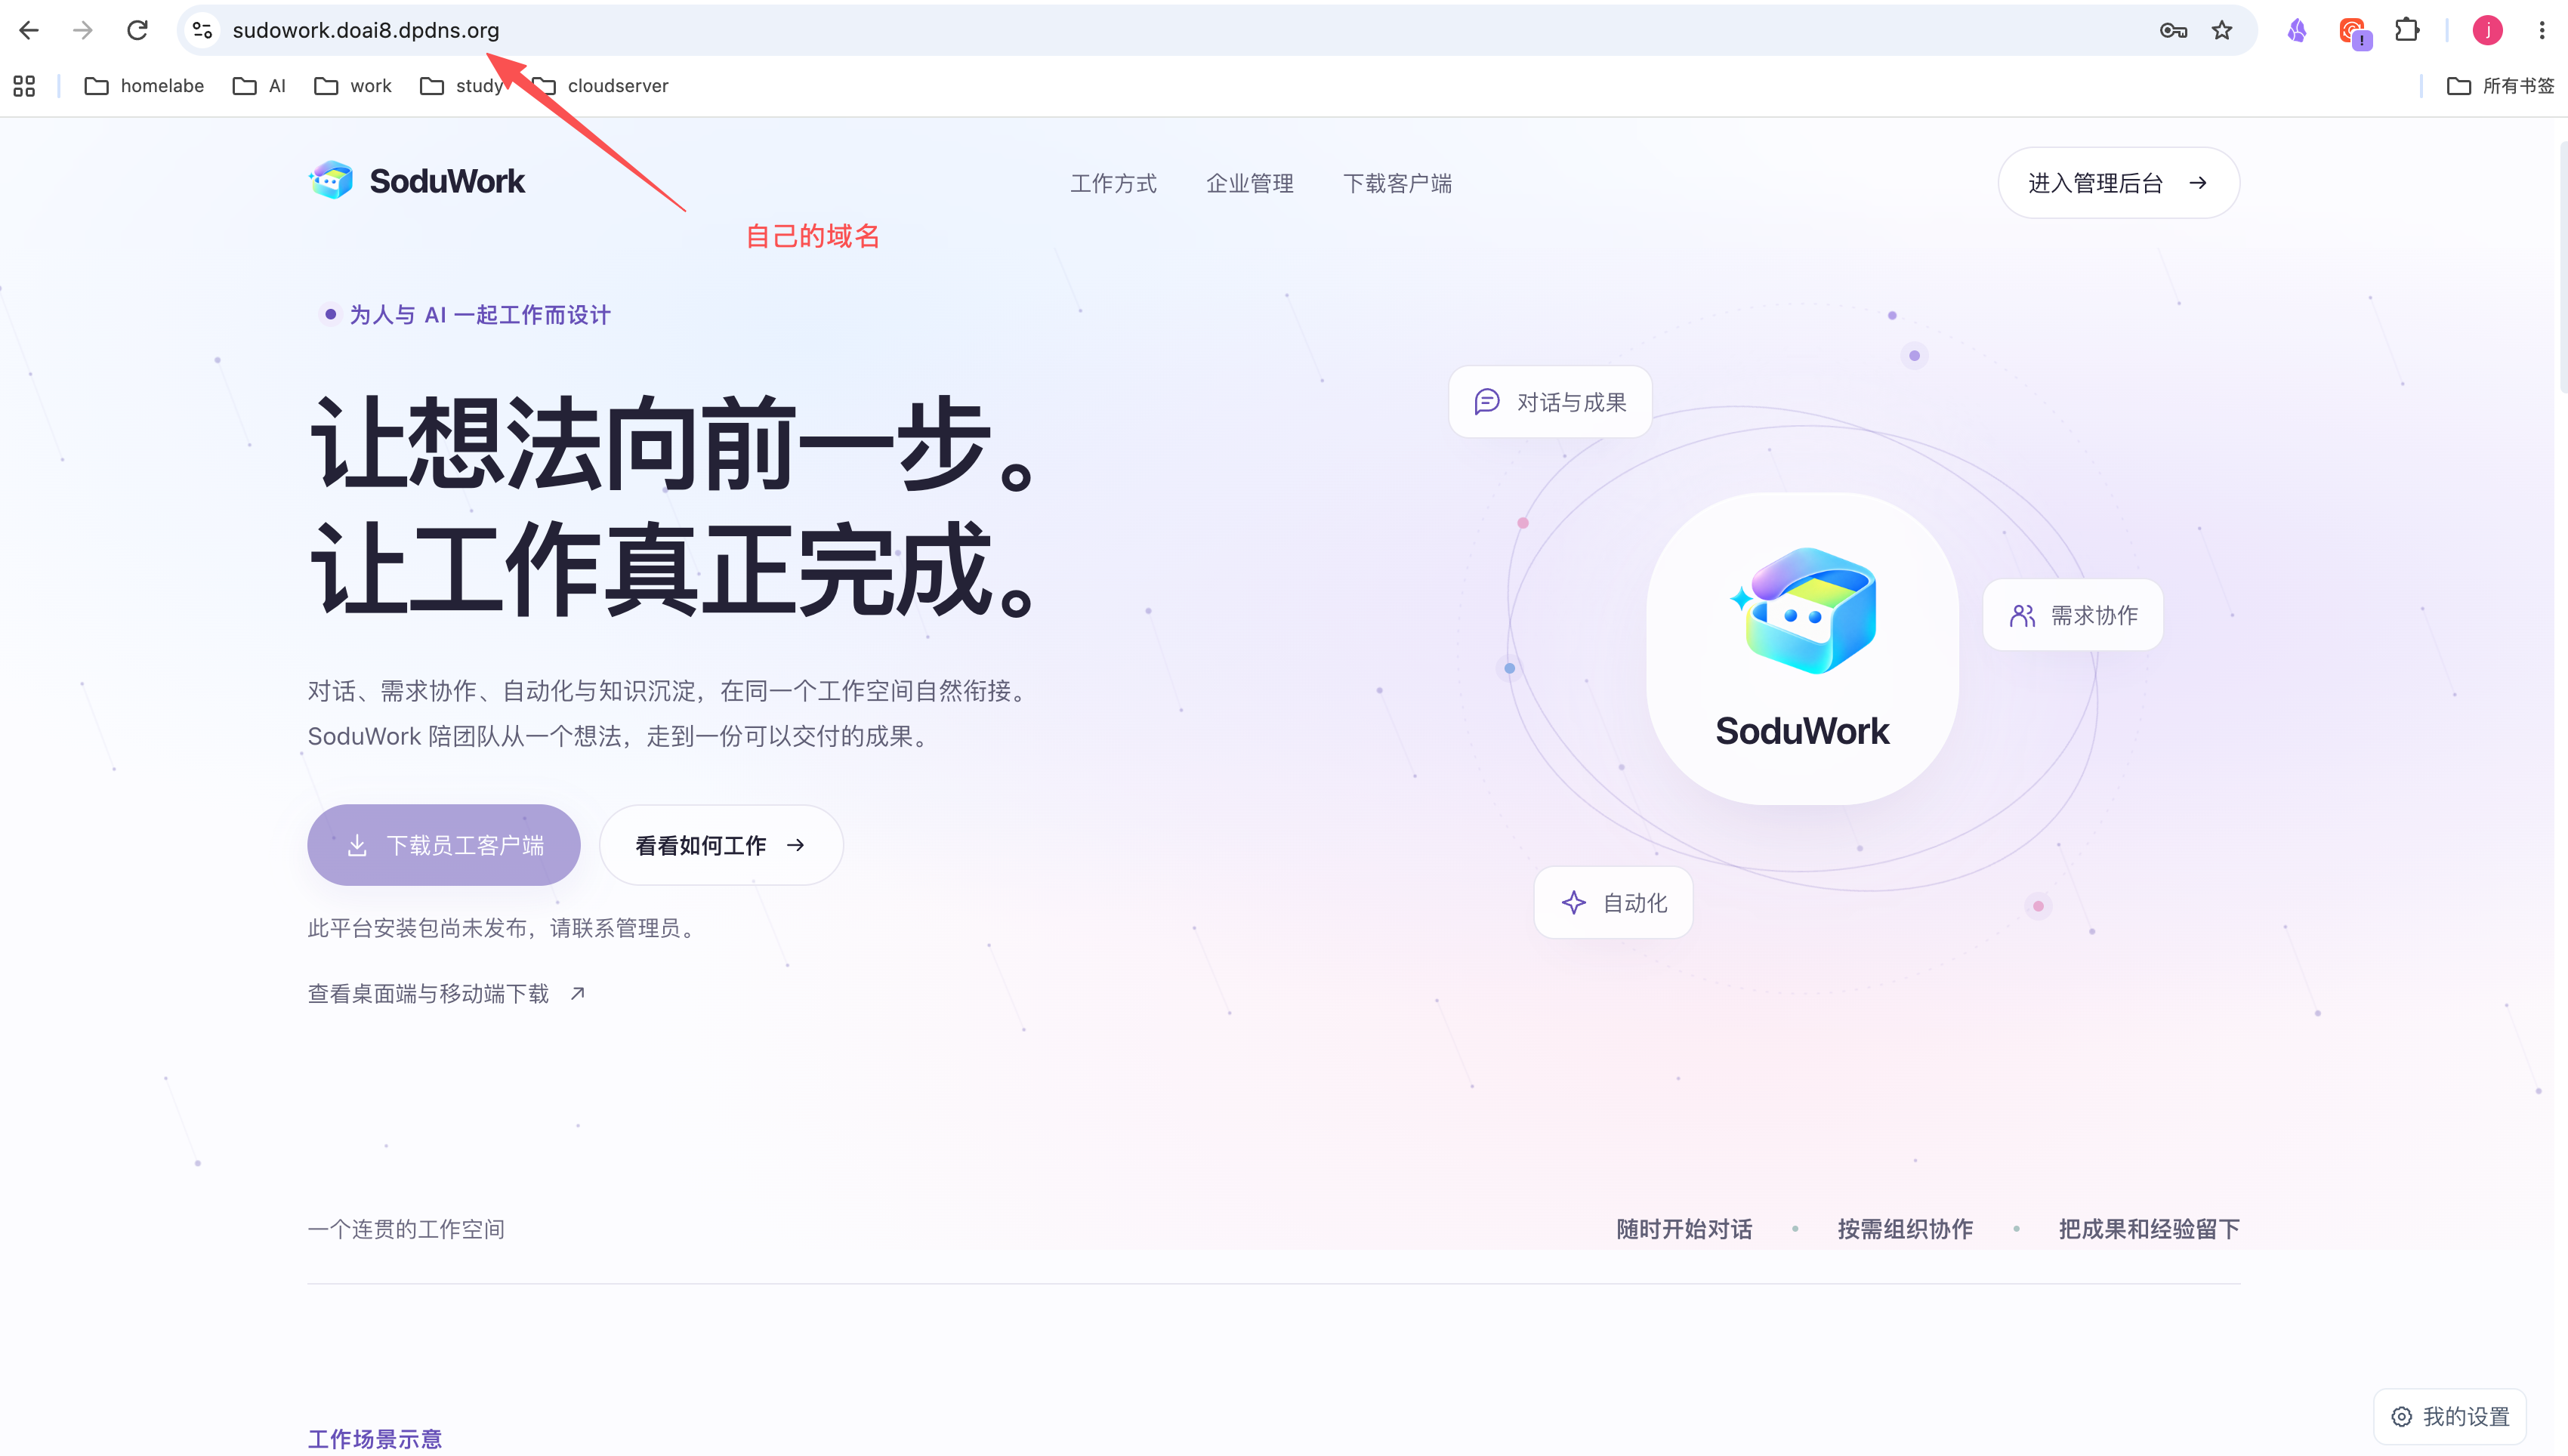
部署完成后,在浏览器里用自己的域名打开,就是自己服务器上的 SoduWork 门户,右上角「进入管理后台」即是 Hub 管理端:
Hub 管理端:三步基础配置
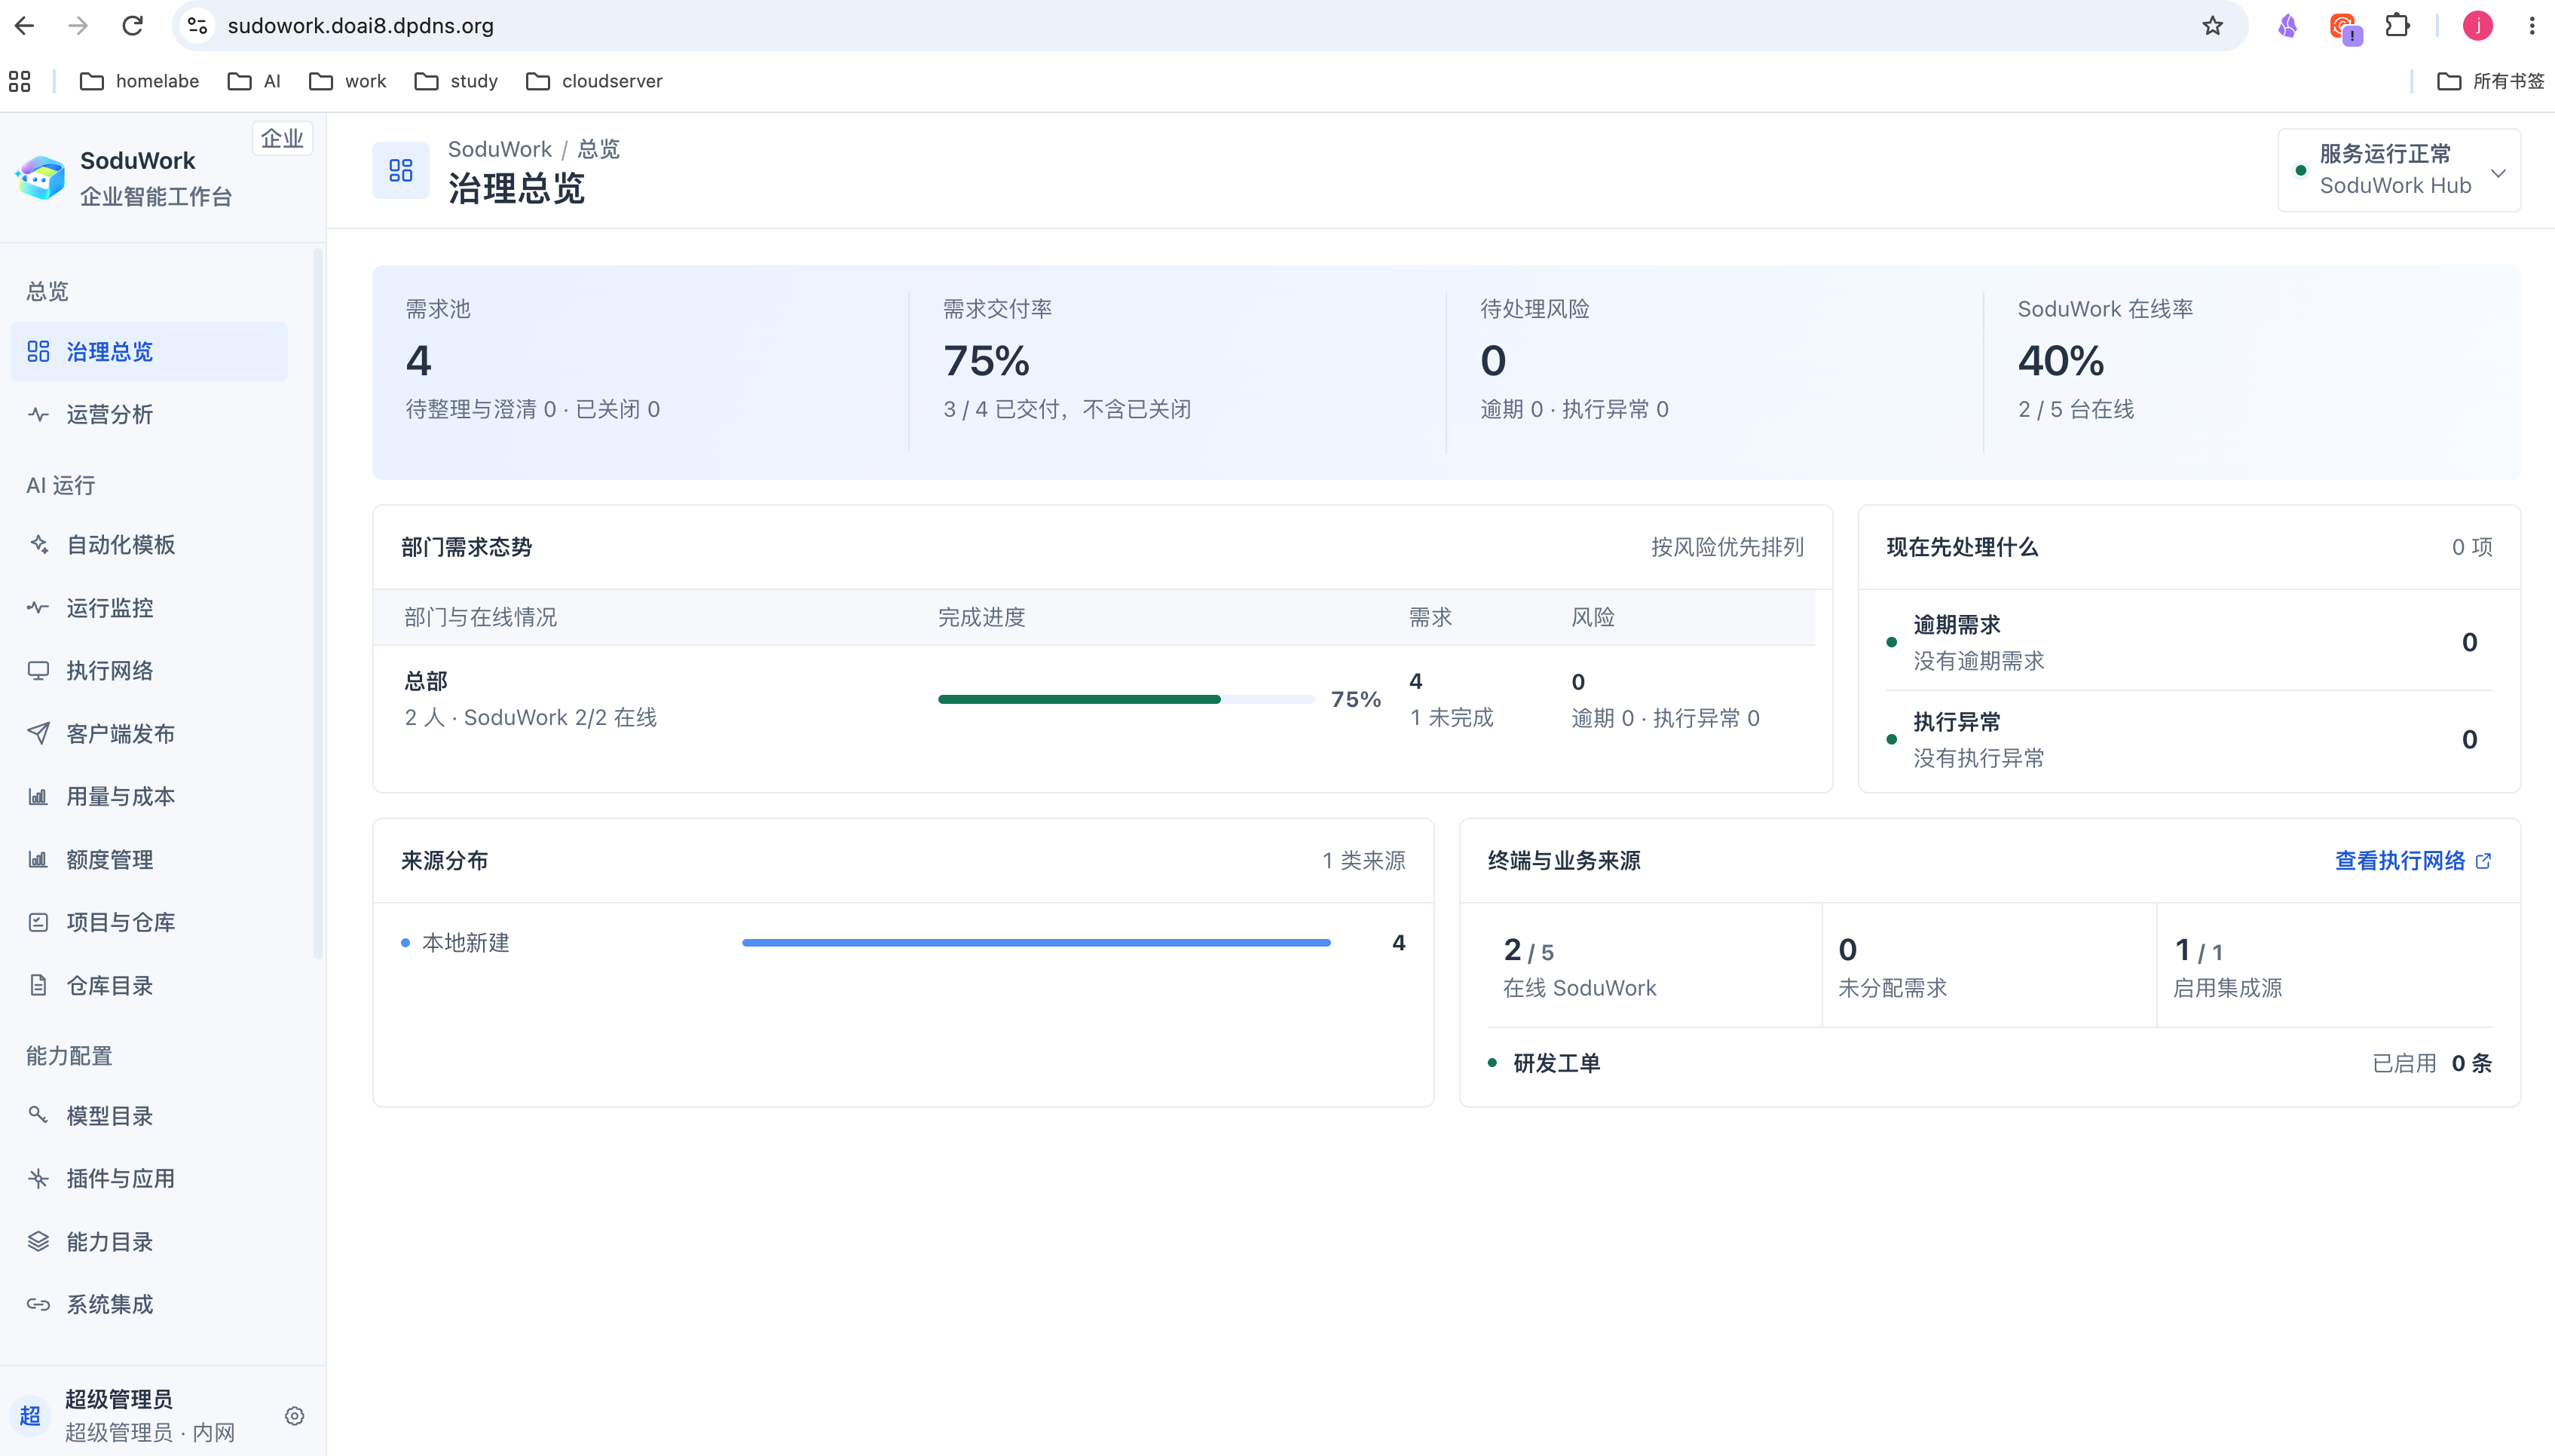
登录管理端,第一眼是「治理总览」:需求池几条、交付率多少、几台客户端在线,服务状态一目了然。真正要让团队(哪怕团队只有我和 Agent)跑起来,配置就三步:
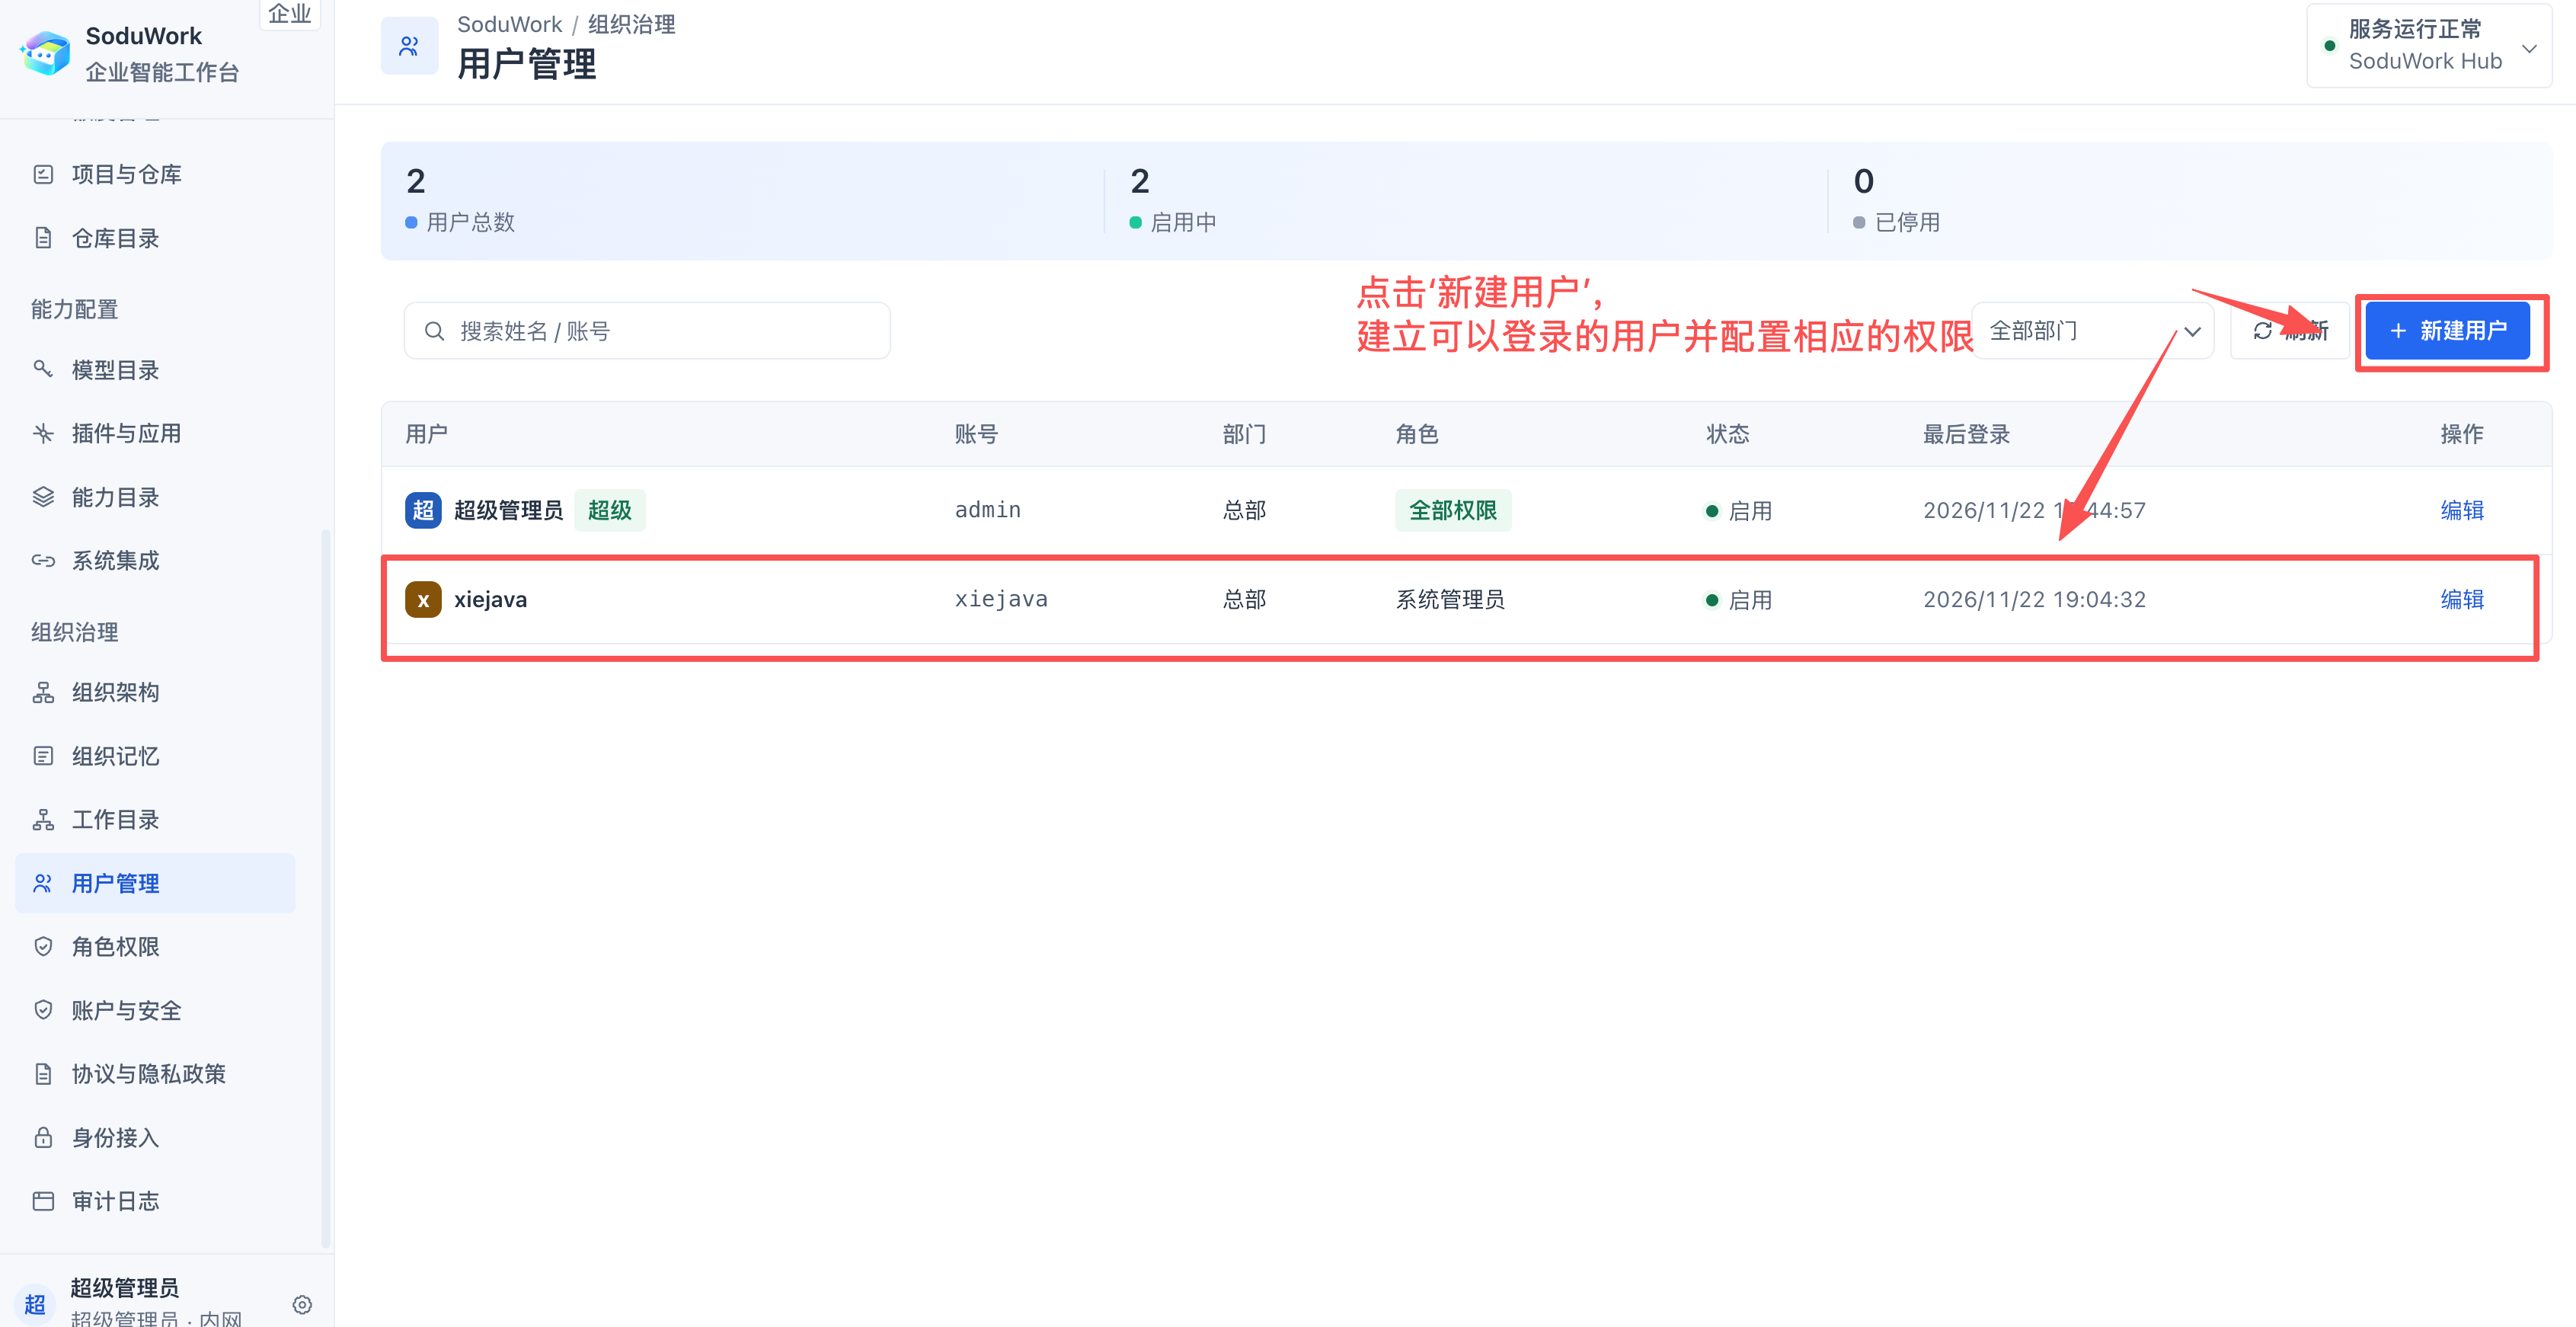
第一步:建用户。 在「组织治理 → 用户管理」里新建用户、配好权限,客户端就能用这个账号登录——不是谁连上都能用。
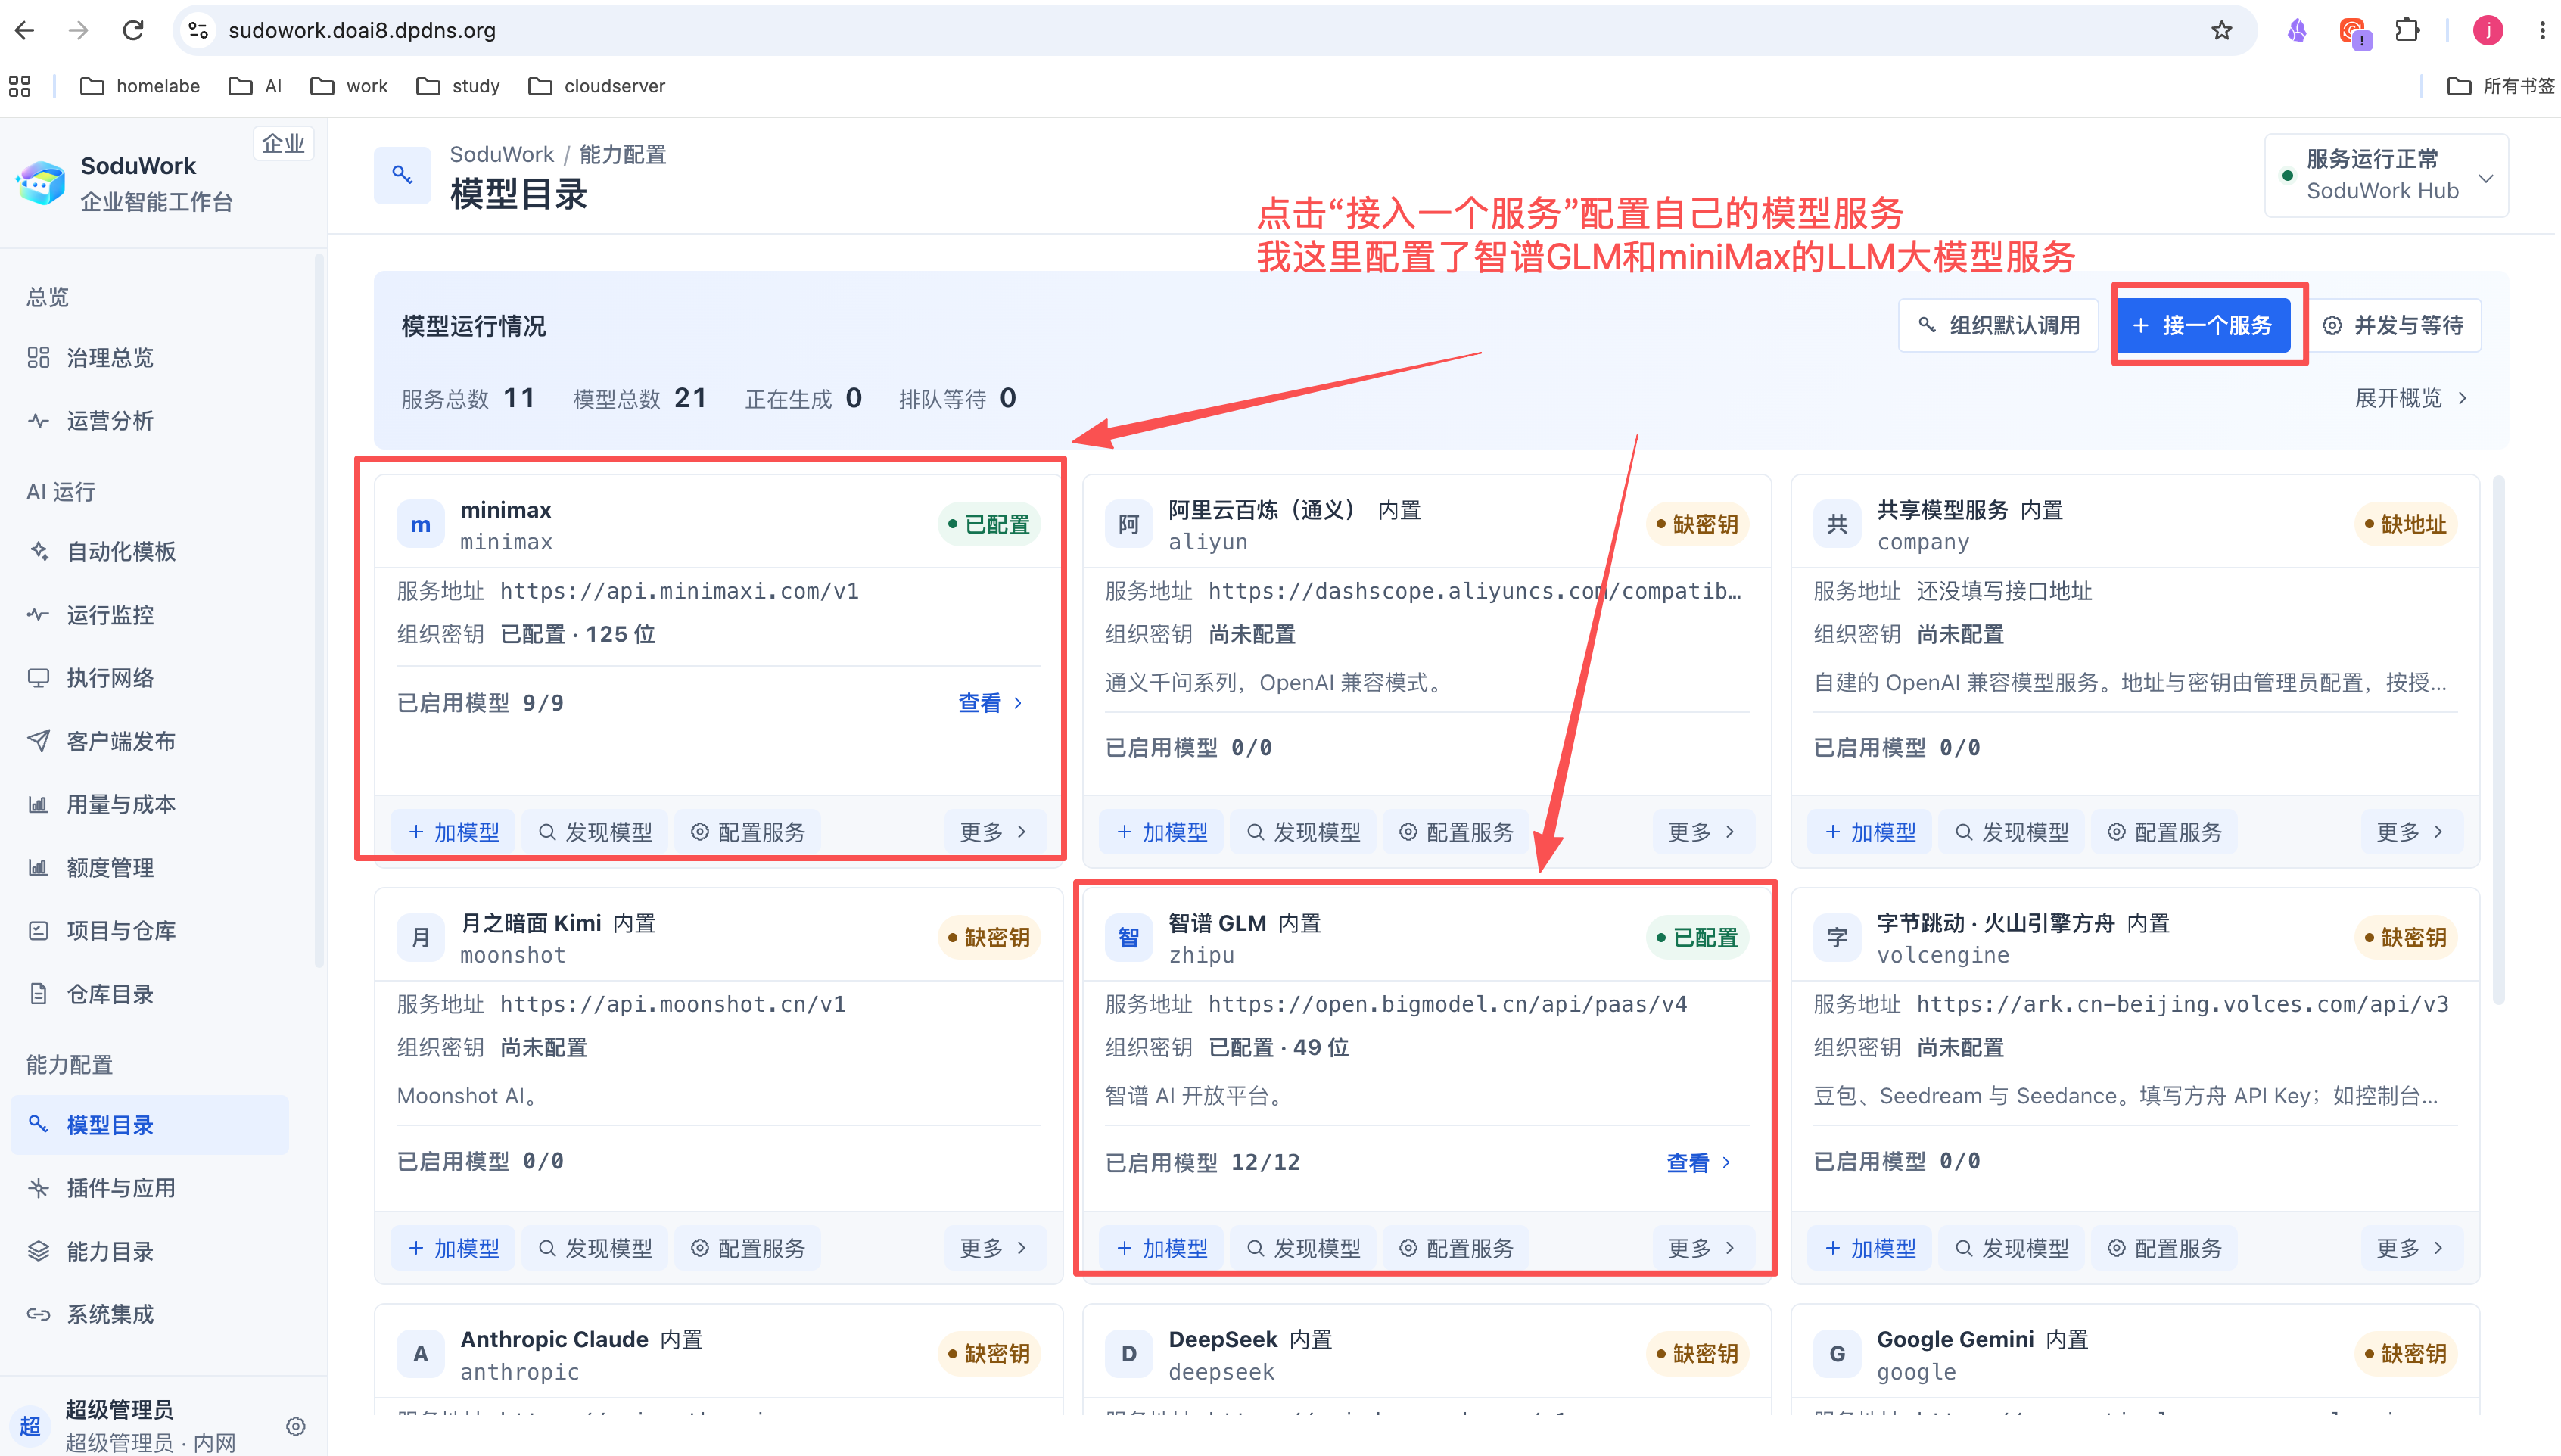
第二步:配模型。 在「模型目录」里点「接入一个服务」,填服务地址和组织密钥。我接了智谱 GLM和 MiniMax 两家;密钥保存后只显示「已配置 · N 位」,不回显明文。配置一次,所有客户端共用,不用每台机器各自填 key。
第三步:建项目。 在「项目与仓库」里新建项目,我把自己的开源项目 AI-miniSOC 配了进去——后面第二部分的实测需求,都挂在这个项目下流转。
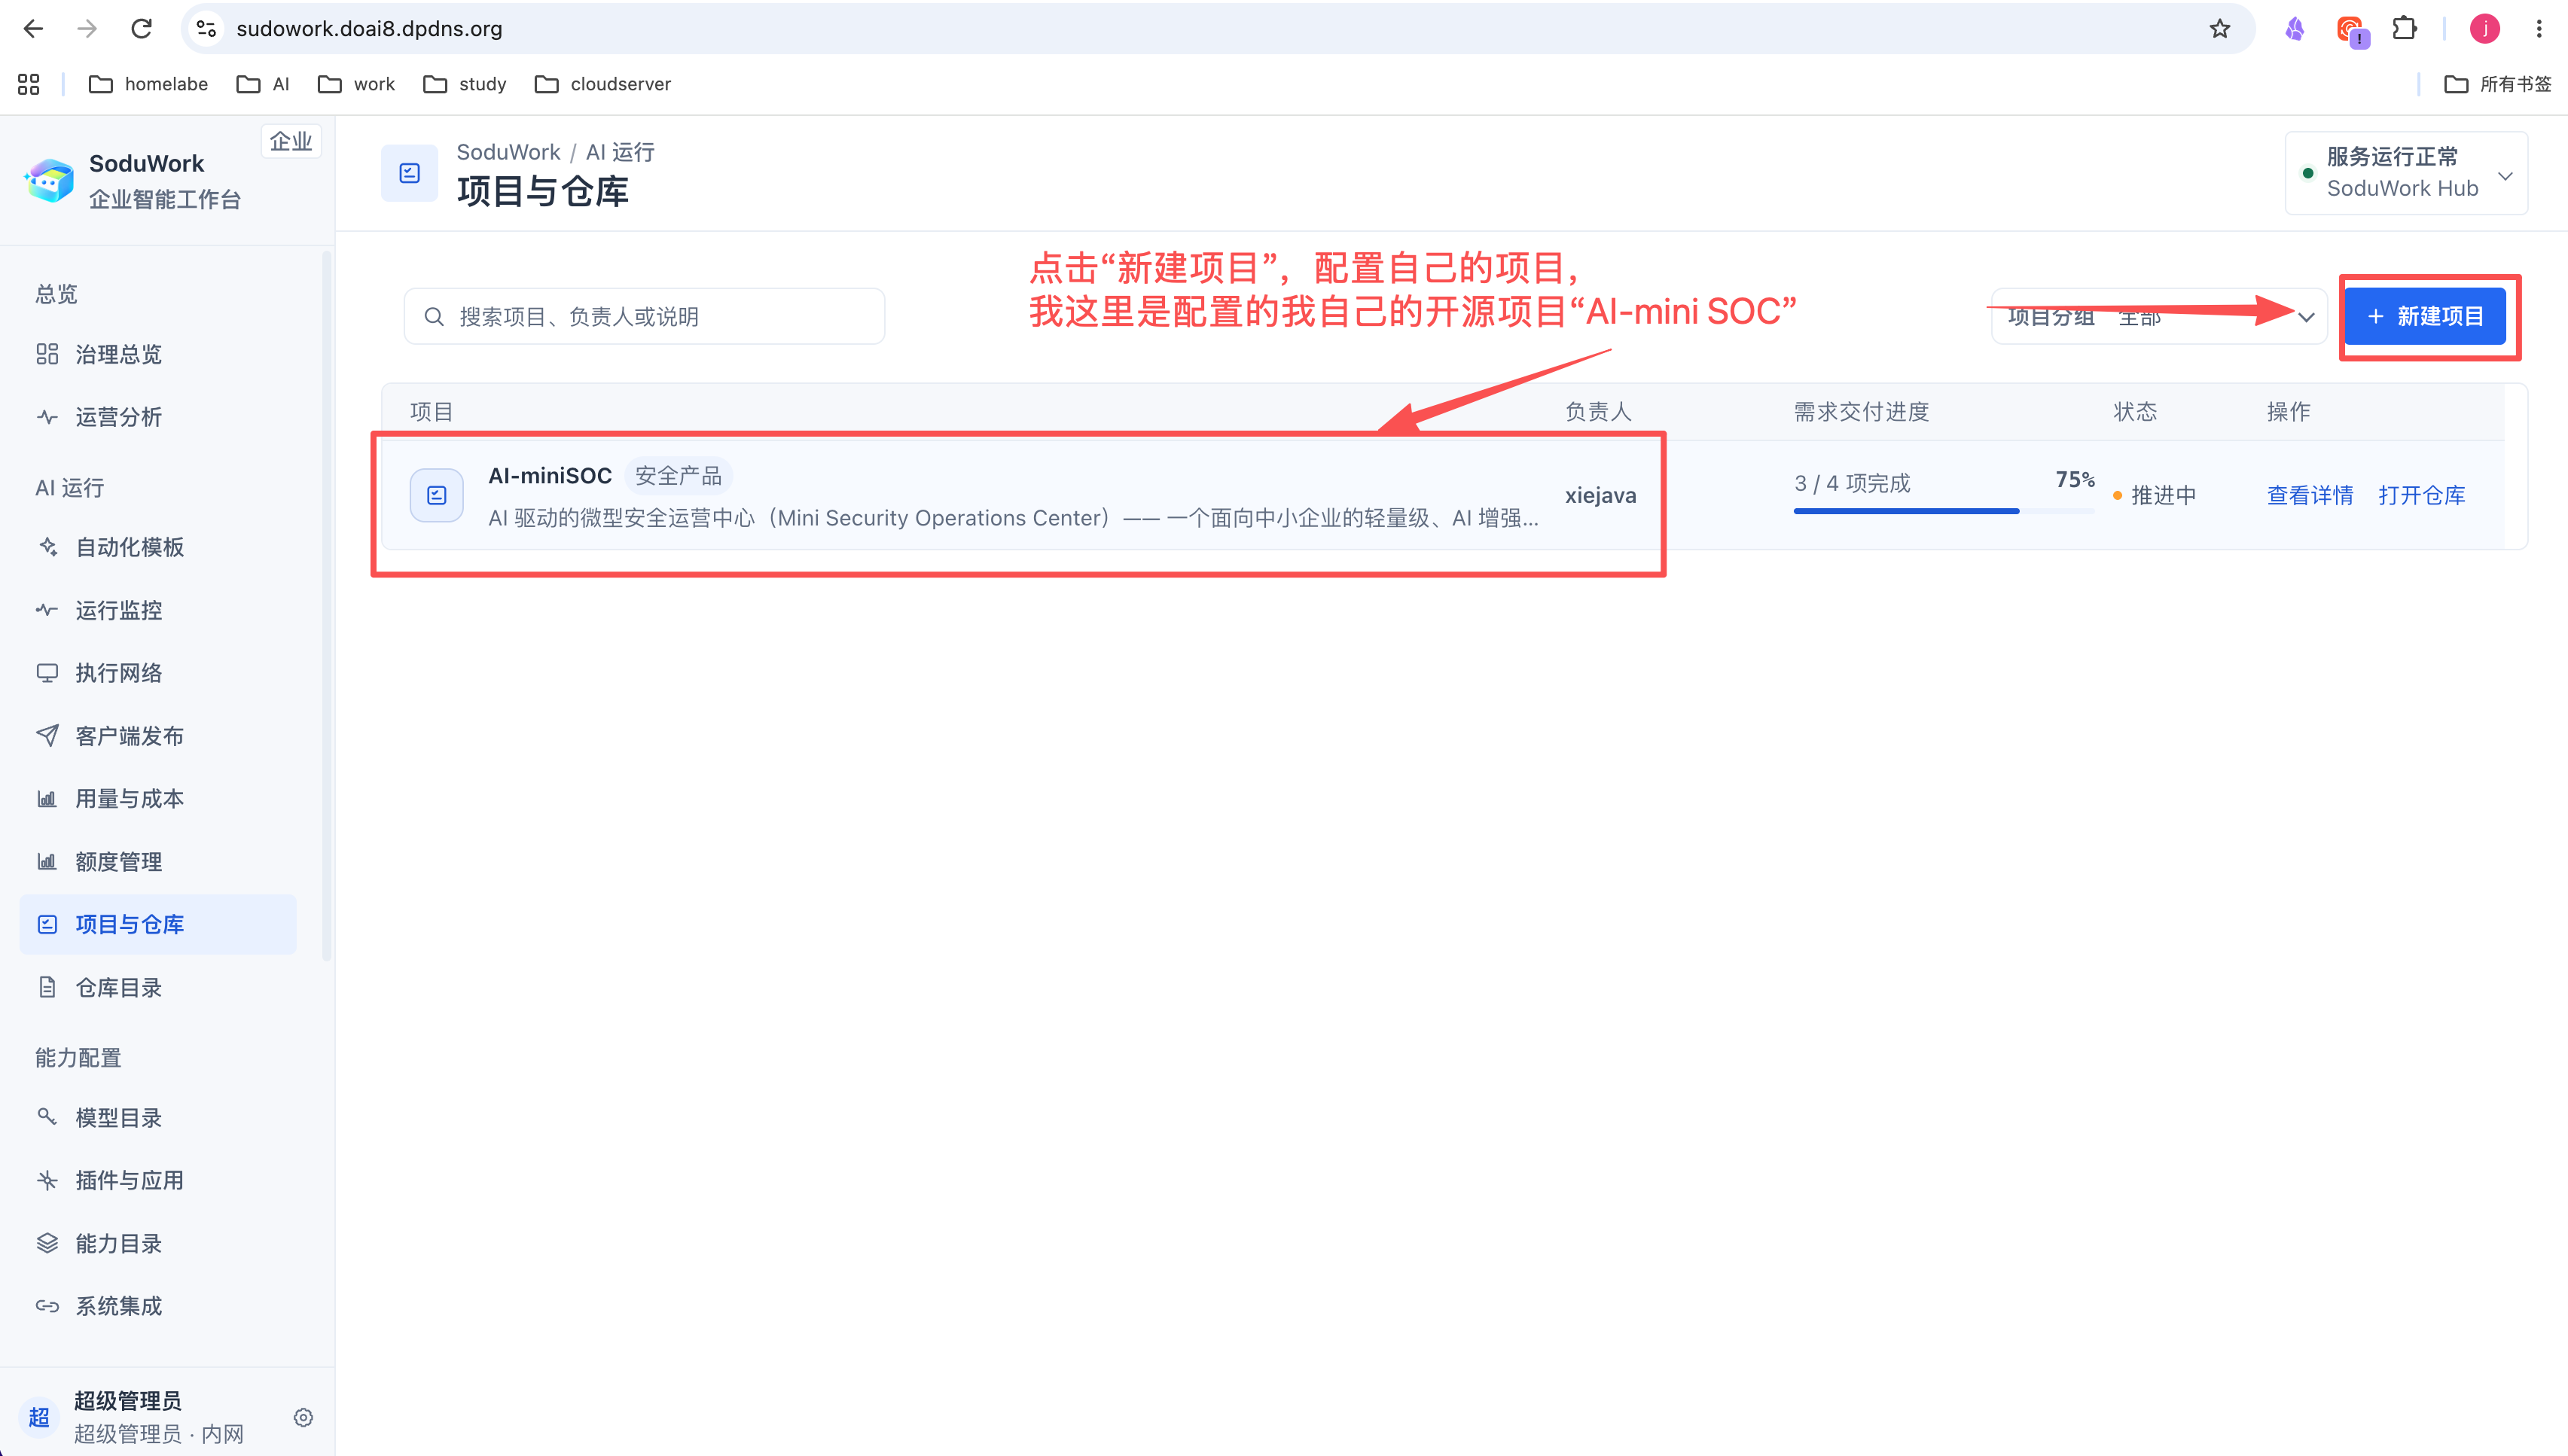
三步配完,服务端就绪。
拓扑:两个入口,同一个实例
我把客户端、Hub 宿主机、Cloudflare 边缘三块和实测数字画在一张图里:
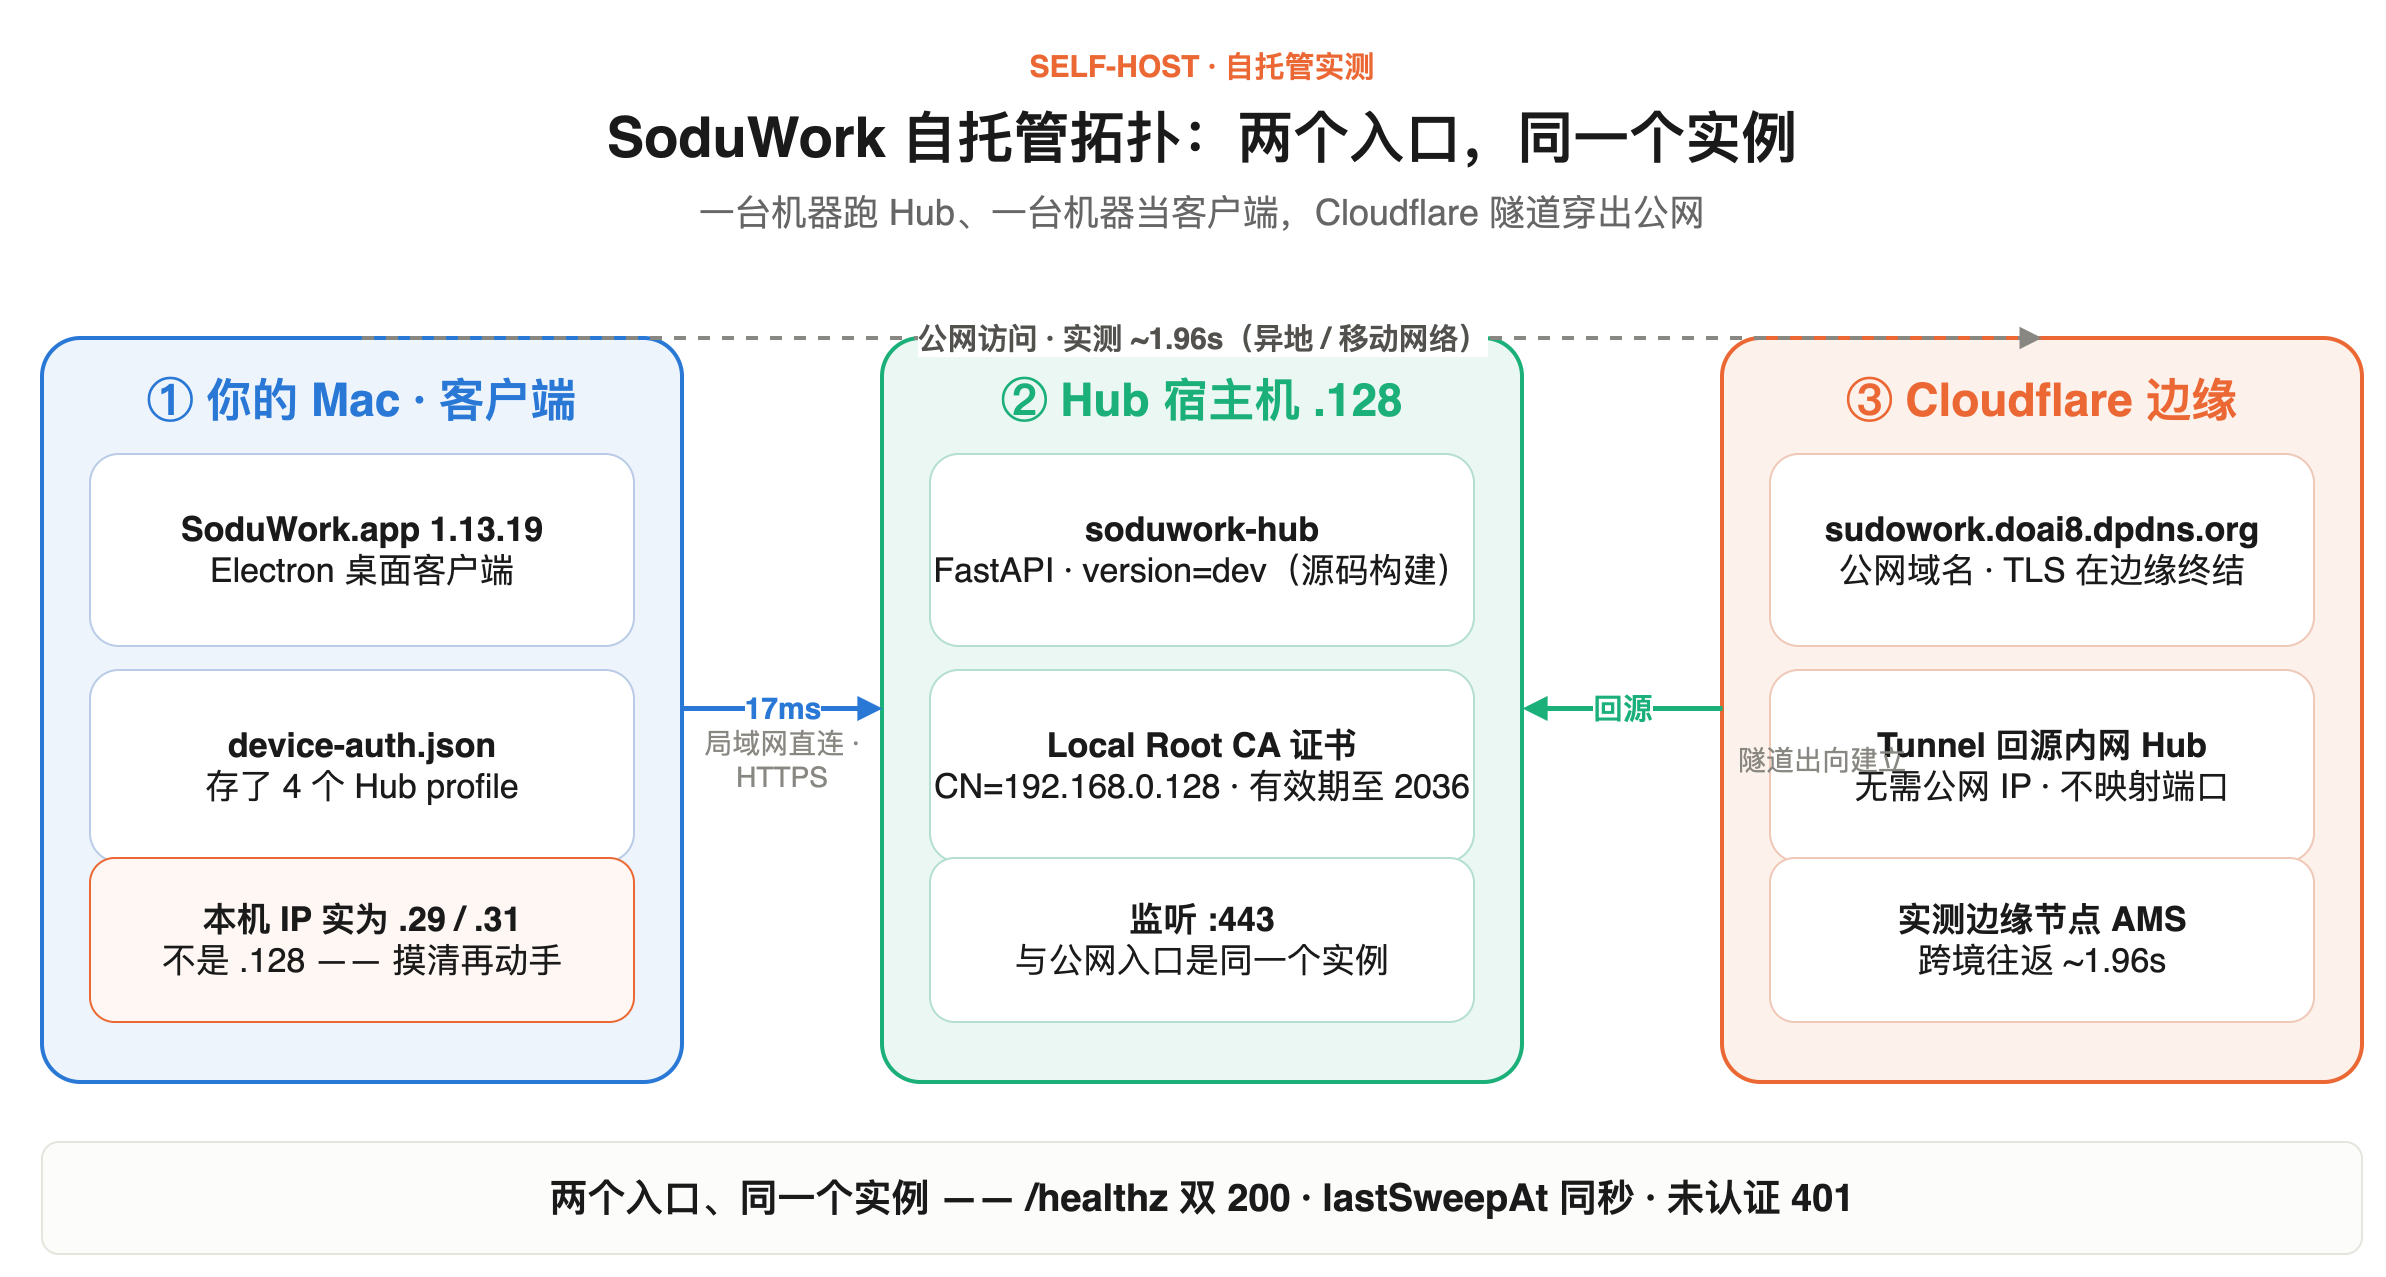
三条链路,一句话说清各自的角色:
| 链路 | 用途 | 实测 |
|---|---|---|
| Mac → Hub 局域网直连 | 日常主力 | 17ms,走 HTTPS |
| Mac → Cloudflare → Hub | 异地 / 移动网络 | 约 1962ms,无需公网 IP |
| Cloudflare → Hub 回源 | 公网入口落到内网 | 隧道出向建立,不映射端口 |
两个关于信任的细节:
- 局域网端用 Local Root CA 签的自签名证书,客户端第一次连它必然要处理一次证书信任——这不是配置错误,是本地自托管的正常代价;
- 公网端由 Cloudflare 在边缘终结 TLS,你从外网访问看到的是公网证书。最妙的是 Cloudflare Tunnel 是出向建立的:宿主机不需要公网 IP、不需要在路由器上映射任何端口,这让它可以藏在内网深处。
怎么证明它真的通:四条验收标准
装完不算完。我把目标压到一个边界非常清楚的范围内——验证自建 Hub 的「双入口可用且一致」,验收标准事先定好四条,缺一条就算失败:
- 局域网入口
GET /healthz返回 200; - 公网入口
GET /healthz返回 200; - 两个入口返回的是同一个实例——用
rework.lastSweepAt时间戳比对,相同才算同实例; - 未认证访问受保护端点
/api/v1/runners,两个入口都必须返回 401,不能有任何一个是 200。
为什么第 3、4 条这么定?因为前两条太容易被假象满足:一个反向代理可以让两个地址都返回 200,但后面接的完全是两套东西;一个配置宽松的部署也可以让两个地址都 200,但把谁都能读的东西当成了「能用」。只有第 3 条证明「是同一个」,只有第 4 条证明「不该进的进不去」。
Agent 的五步验证
这次验证本身就是交给 Agent 的第一个任务。它没有直接开工,而是先摸环境再动手:
- 确认安装事实:读
Info.plist拿到客户端版本1.13.19,同时发现本机127.0.0.1:18989上还有一个源码启动器起的开发实例; - 发现拓扑和预期不同:查
ifconfig发现本机 IP 是192.168.0.29 / .31——不是.128,于是把「Hub 在本机」的假设纠正为「跨机器 + 隧道」。如果跳过这步直接测 localhost,整个实验从第一步就错了; - 读出真实接入痕迹:客户端
device-auth.json里存着 4 个 Hub profile,创建时间依次是127.0.0.1:18989→https://192.168.0.128→https://sodowork.doai8.dpdns.org→ 官方云https://service.soduwork.ai——正好是「本地 → 局域网 → 公网 → 也想试试官方」的真实探索路径; - 写可复现的验证脚本:把四条验收标准落成
verify-hub.sh,任何人一条命令就能重跑结论; - 执行并留证:跑脚本,输出存成
evidence-verify.txt。证据是文件,不是记忆。
结果依据在哪里
下面每一条都能被你自己重跑验证(原文输出摘自 evidence-verify.txt)。
健康检查——两个入口都通:
== 1. 健康检查 ==
https://192.168.0.128/healthz            200|0.017560
https://sodowork.doai8.dpdns.org/healthz 200|1.962542
局域网 17ms,公网 1962ms,差 115 倍,但完全合理:公网那 1.9 秒里含 Cloudflare 边缘节点(cf-ray 显示走了 AMS 阿姆斯特丹)的跨境往返,响应头里的 server-timing: app;dur=… 显示 Hub 自己的处理在 10ms 量级。延迟几乎全部来自那趟跨境往返,不是 Hub 慢。
顺带一个坑:/healthz 用 HEAD 请求会返回 404。如果你用 curl -I 探活,会误判成服务挂了。要用 GET。
实例一致性——确认是同一个:
== 2. 实例一致性 ==
LAN=2026-11-22T08:05:42+00:00
PUB=2026-11-22T08:05:42+00:00
结论: 同一实例
rework.lastSweepAt 是 Hub 后台清理任务的时间戳,两个入口抓到完全相同的一秒——这基本排除了「两个入口后面是两套库」的可能。这一条证伪的是最容易发生的部署错误。
鉴权边界——不该进的进不去:
== 3. 鉴权边界 ==
https://192.168.0.128/api/v1/runners             401
https://sodowork.doai8.dpdns.org/api/v1/runners  401
返回体是 {"detail":"需要有效的 SoduWork 设备会话"}。两侧都是 401,说明公网暴露没有削弱鉴权:Cloudflare 只是转发,鉴权仍然由 Hub 自己做。把内网服务挂到公网,最怕的就是某条路径意外放行——能访问 ≠ 该访问,401 才是好消息。
公共端点——公网入口能给出完整前端:
== 4. 公共端点 ==
https://sodowork.doai8.dpdns.org/readyz                  200
https://sodowork.doai8.dpdns.org/api/v1/auth/providers   200
根路径返回完整的 SoduWork HTML,/readyz 也 200。/api/v1/auth/providers 返回 {"items":[]}——这台 Hub 没接企业身份源,走本地账号登录;想接 SSO 的话这里会是空的,得单独配。
桌面客户端:手动连上自建 Hub
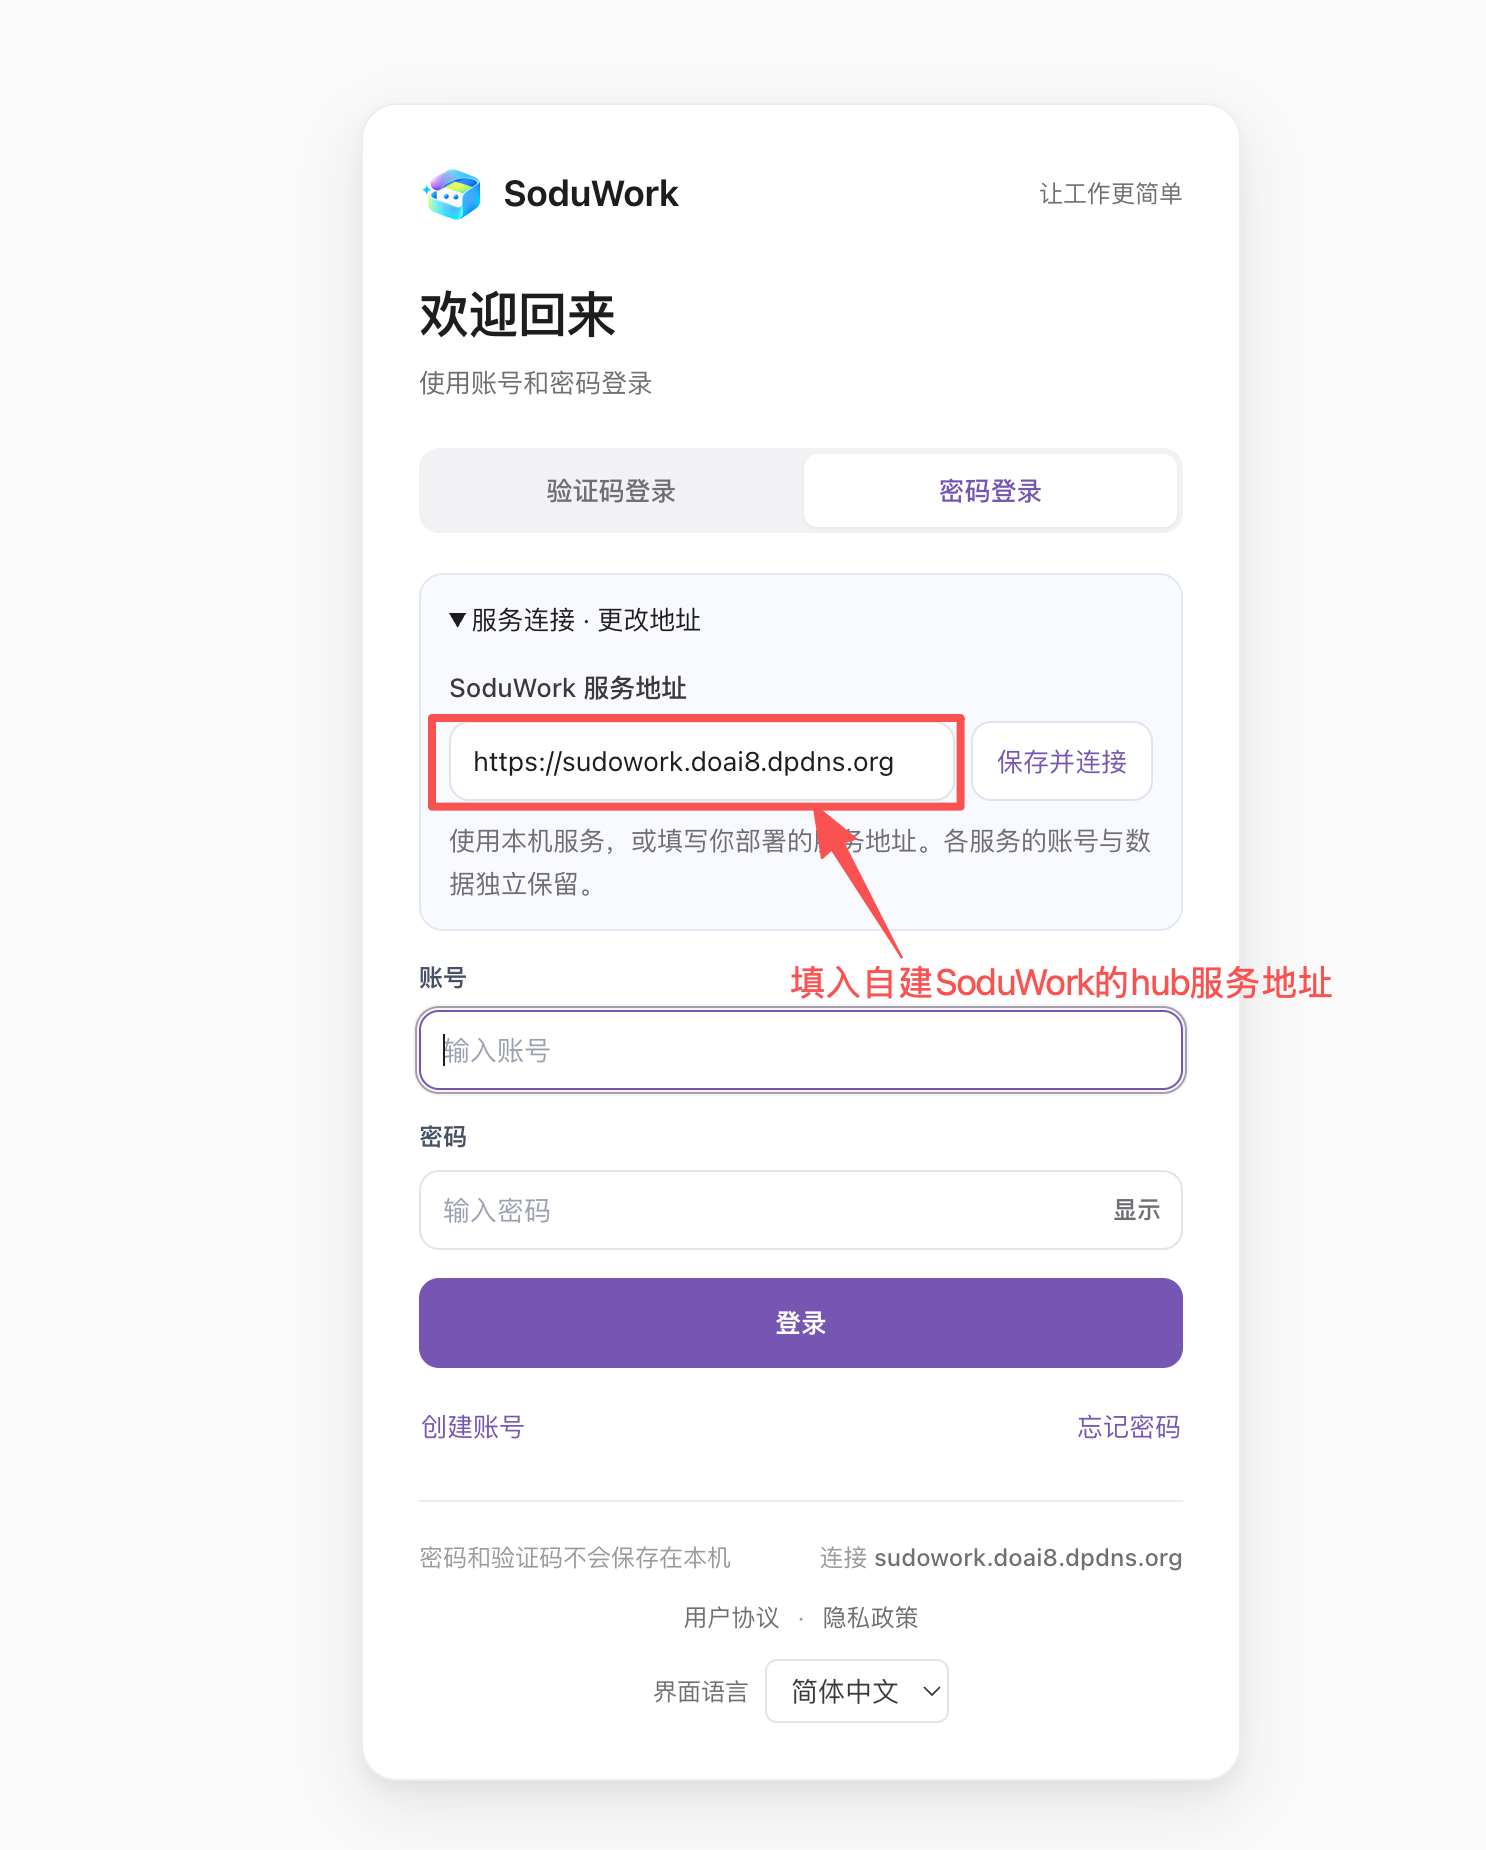
脚本验证的是服务端,最后补上「客户端 ↔ 自建 Hub」的端到端一环——在桌面客户端的登录页展开「服务连接」,填入自建服务地址 https://sudowork.doai8.dpdns.org,点「保存并连接」:
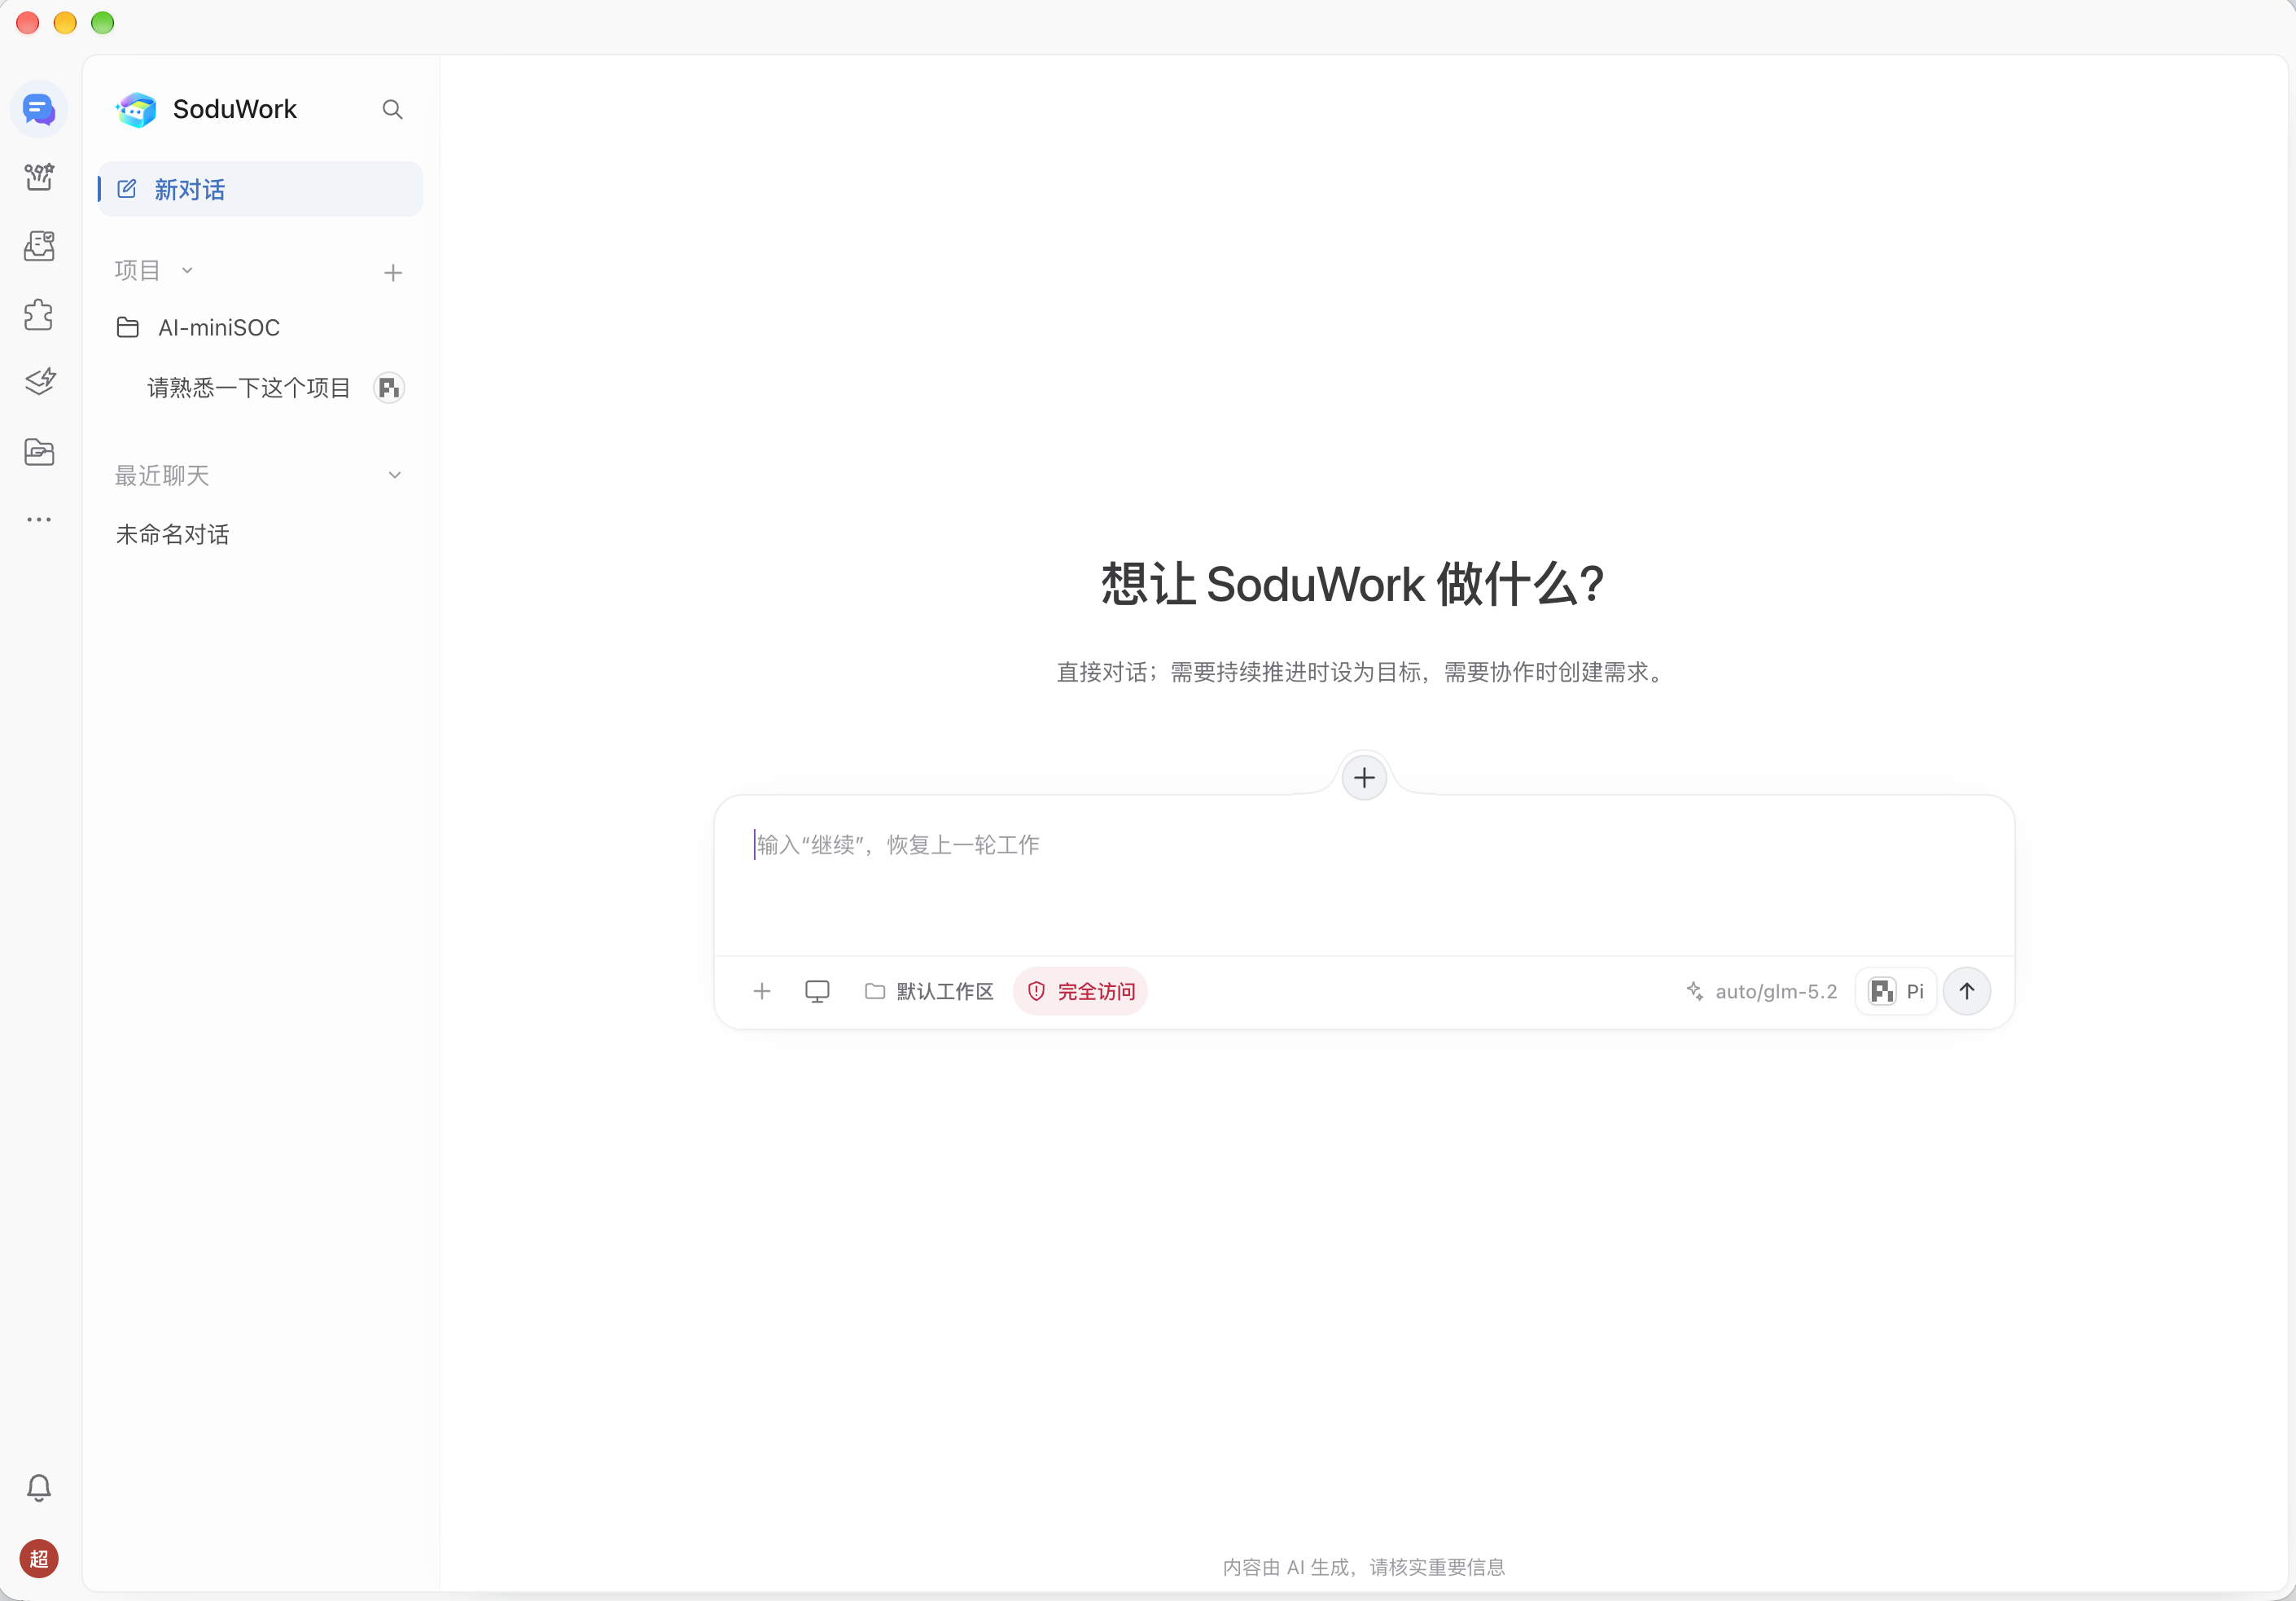
输入管理端建好的用户名密码,登录进来就是主界面——左侧已经有项目「AI-miniSOC」和它的会话:
接着配置干活的 Agent。客户端内置了 Pi(轻快,原生支持 Agent Skills,和 Claude Code 同一套标准),也可一键安装 Codex、Kimi Code、Qwen Code、OpenCode 等一排开源 Agent:
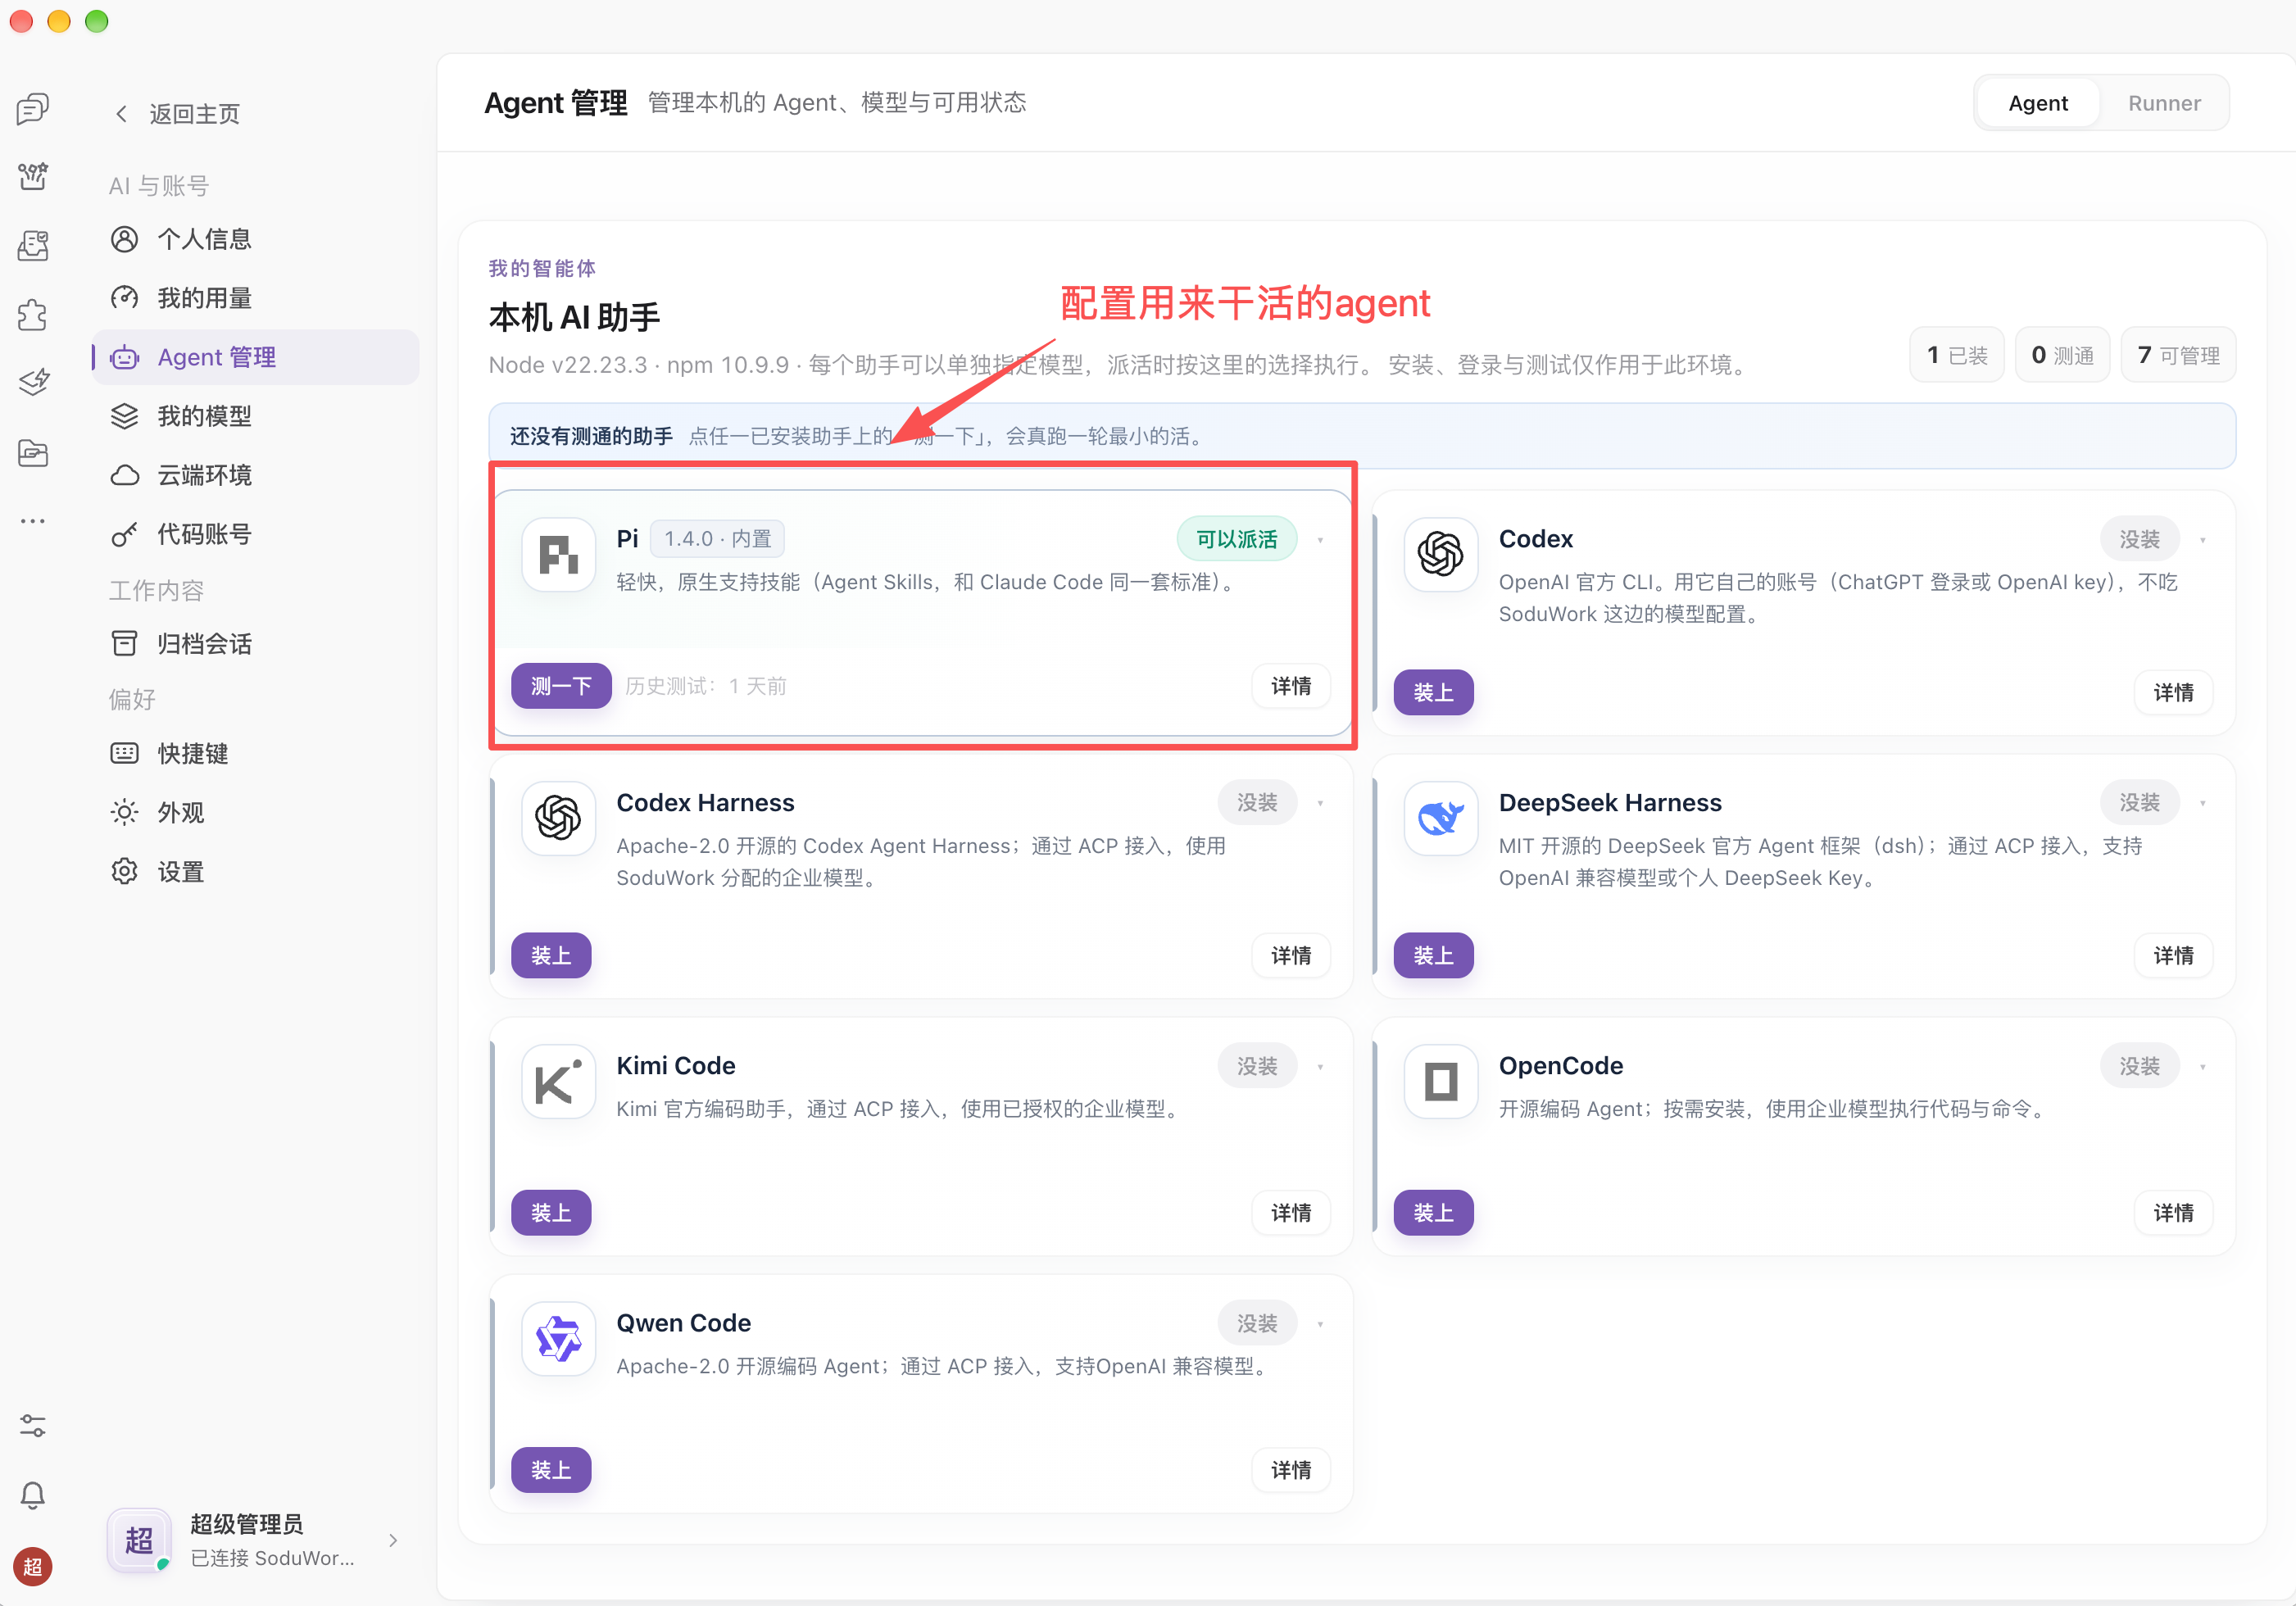
给 Agent 选模型并「测一下」——测试是真跑一轮最小的活,不是 ping 一下。Pi 用的是 Hub 上配好的智谱 GLM;顺手验证了它的说明:模型配置写到 ~/.pi/agent/models.json,密钥只写变量名,明文不落盘:
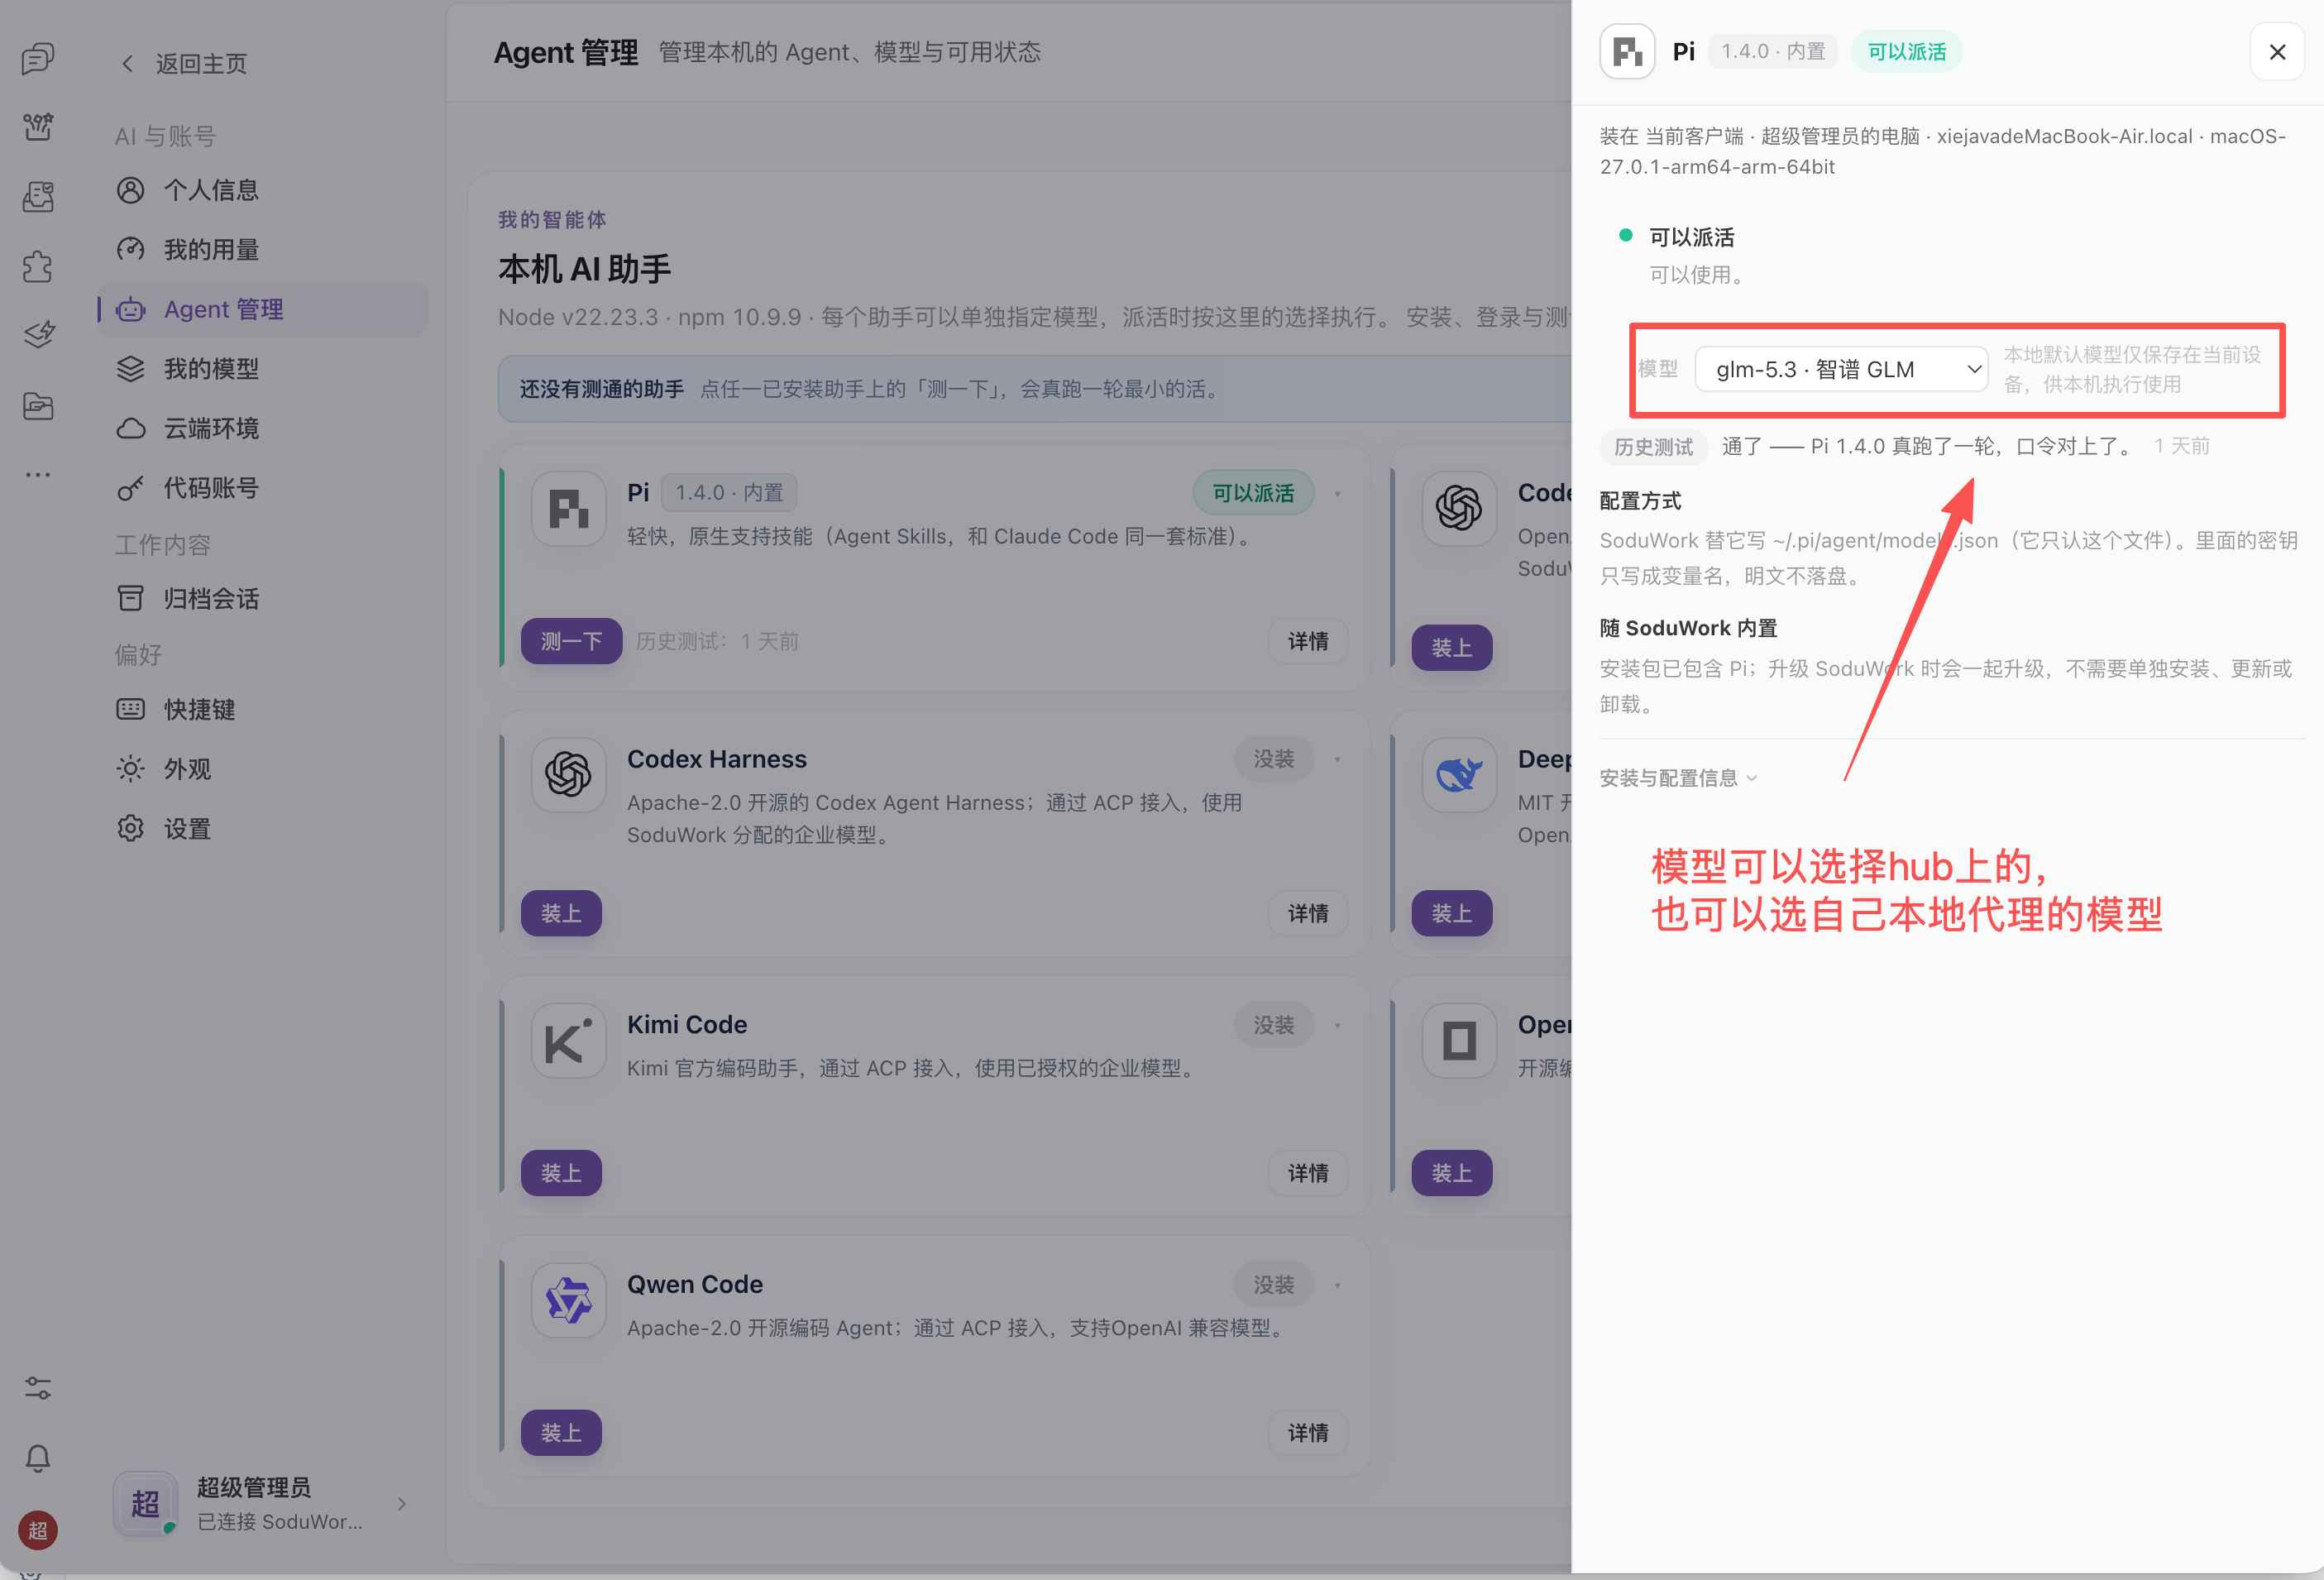
模型这块的设计很务实:客户端会自动获取 Hub 上配好的模型服务(智谱 GLM、MiniMax 直接出现),也可以配自己本地代理的服务——我本机有个 127.0.0.1 的代理挂了 29 个模型,一样能用:
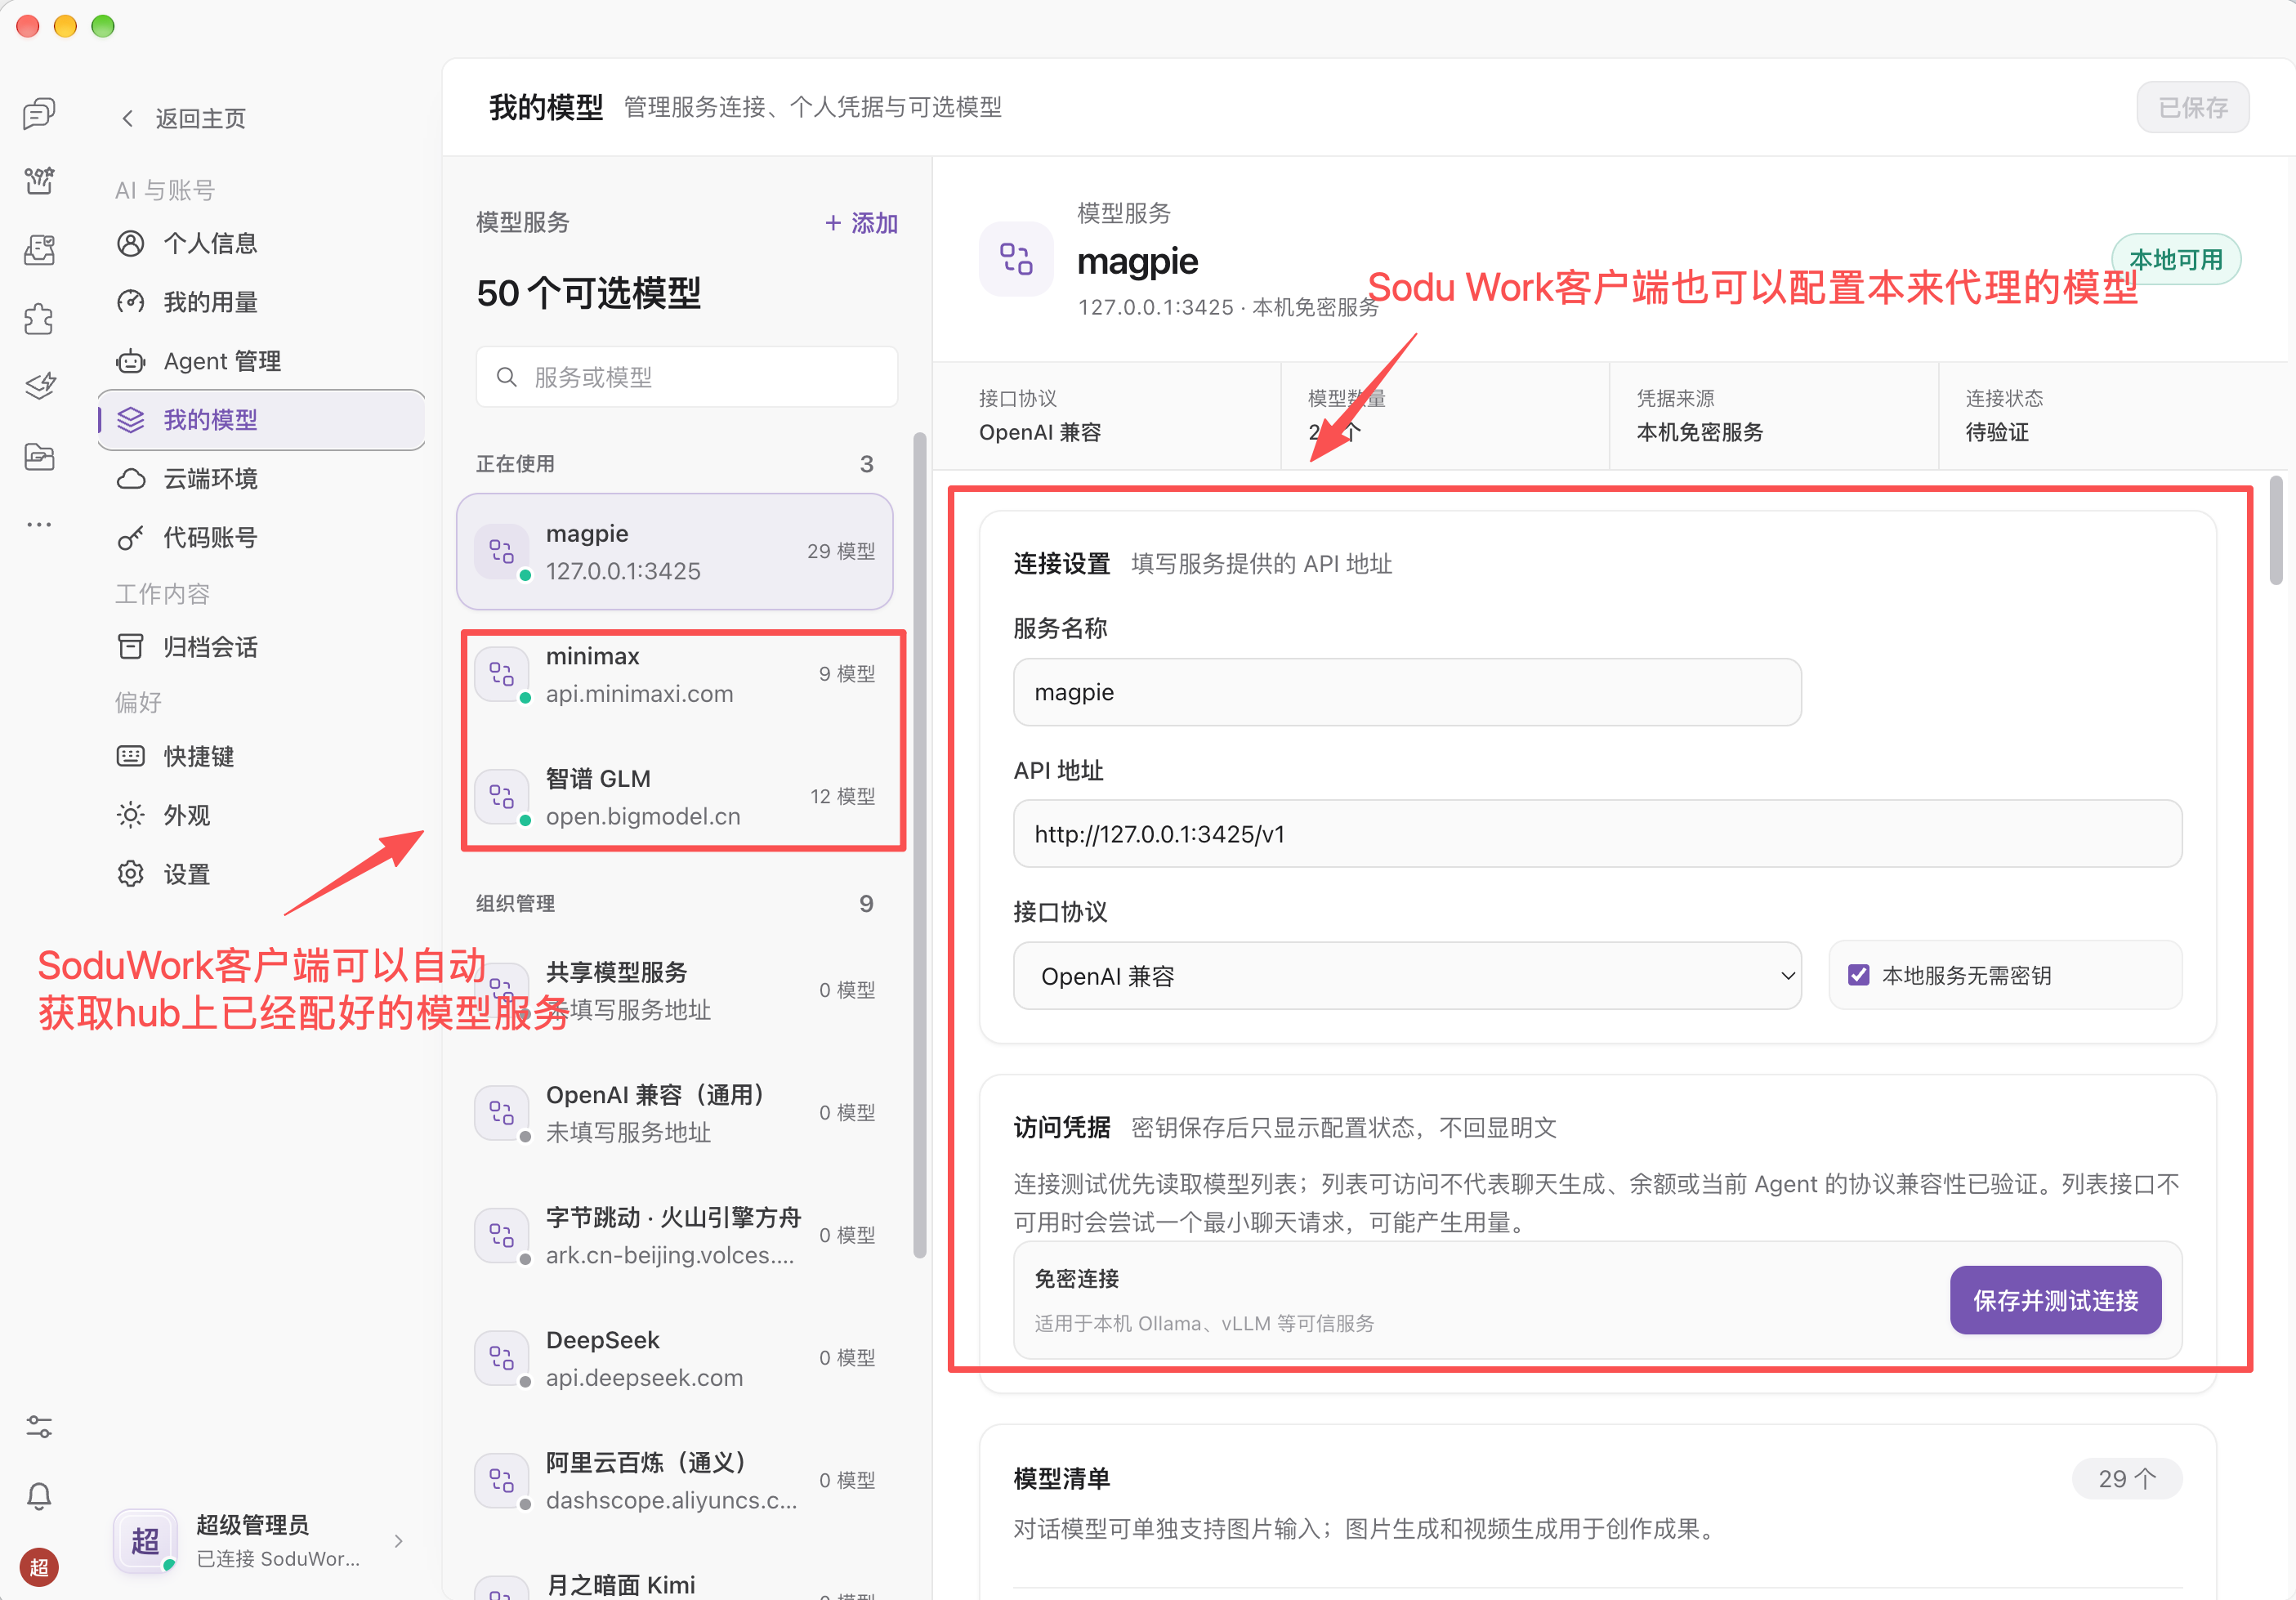
回到 Hub 管理端的「运行监控」,能看到各个客户端的连接情况——我有两台机器装了客户端,都连上来了,状态「可接活」,顺带还能看到服务请求的 P95:
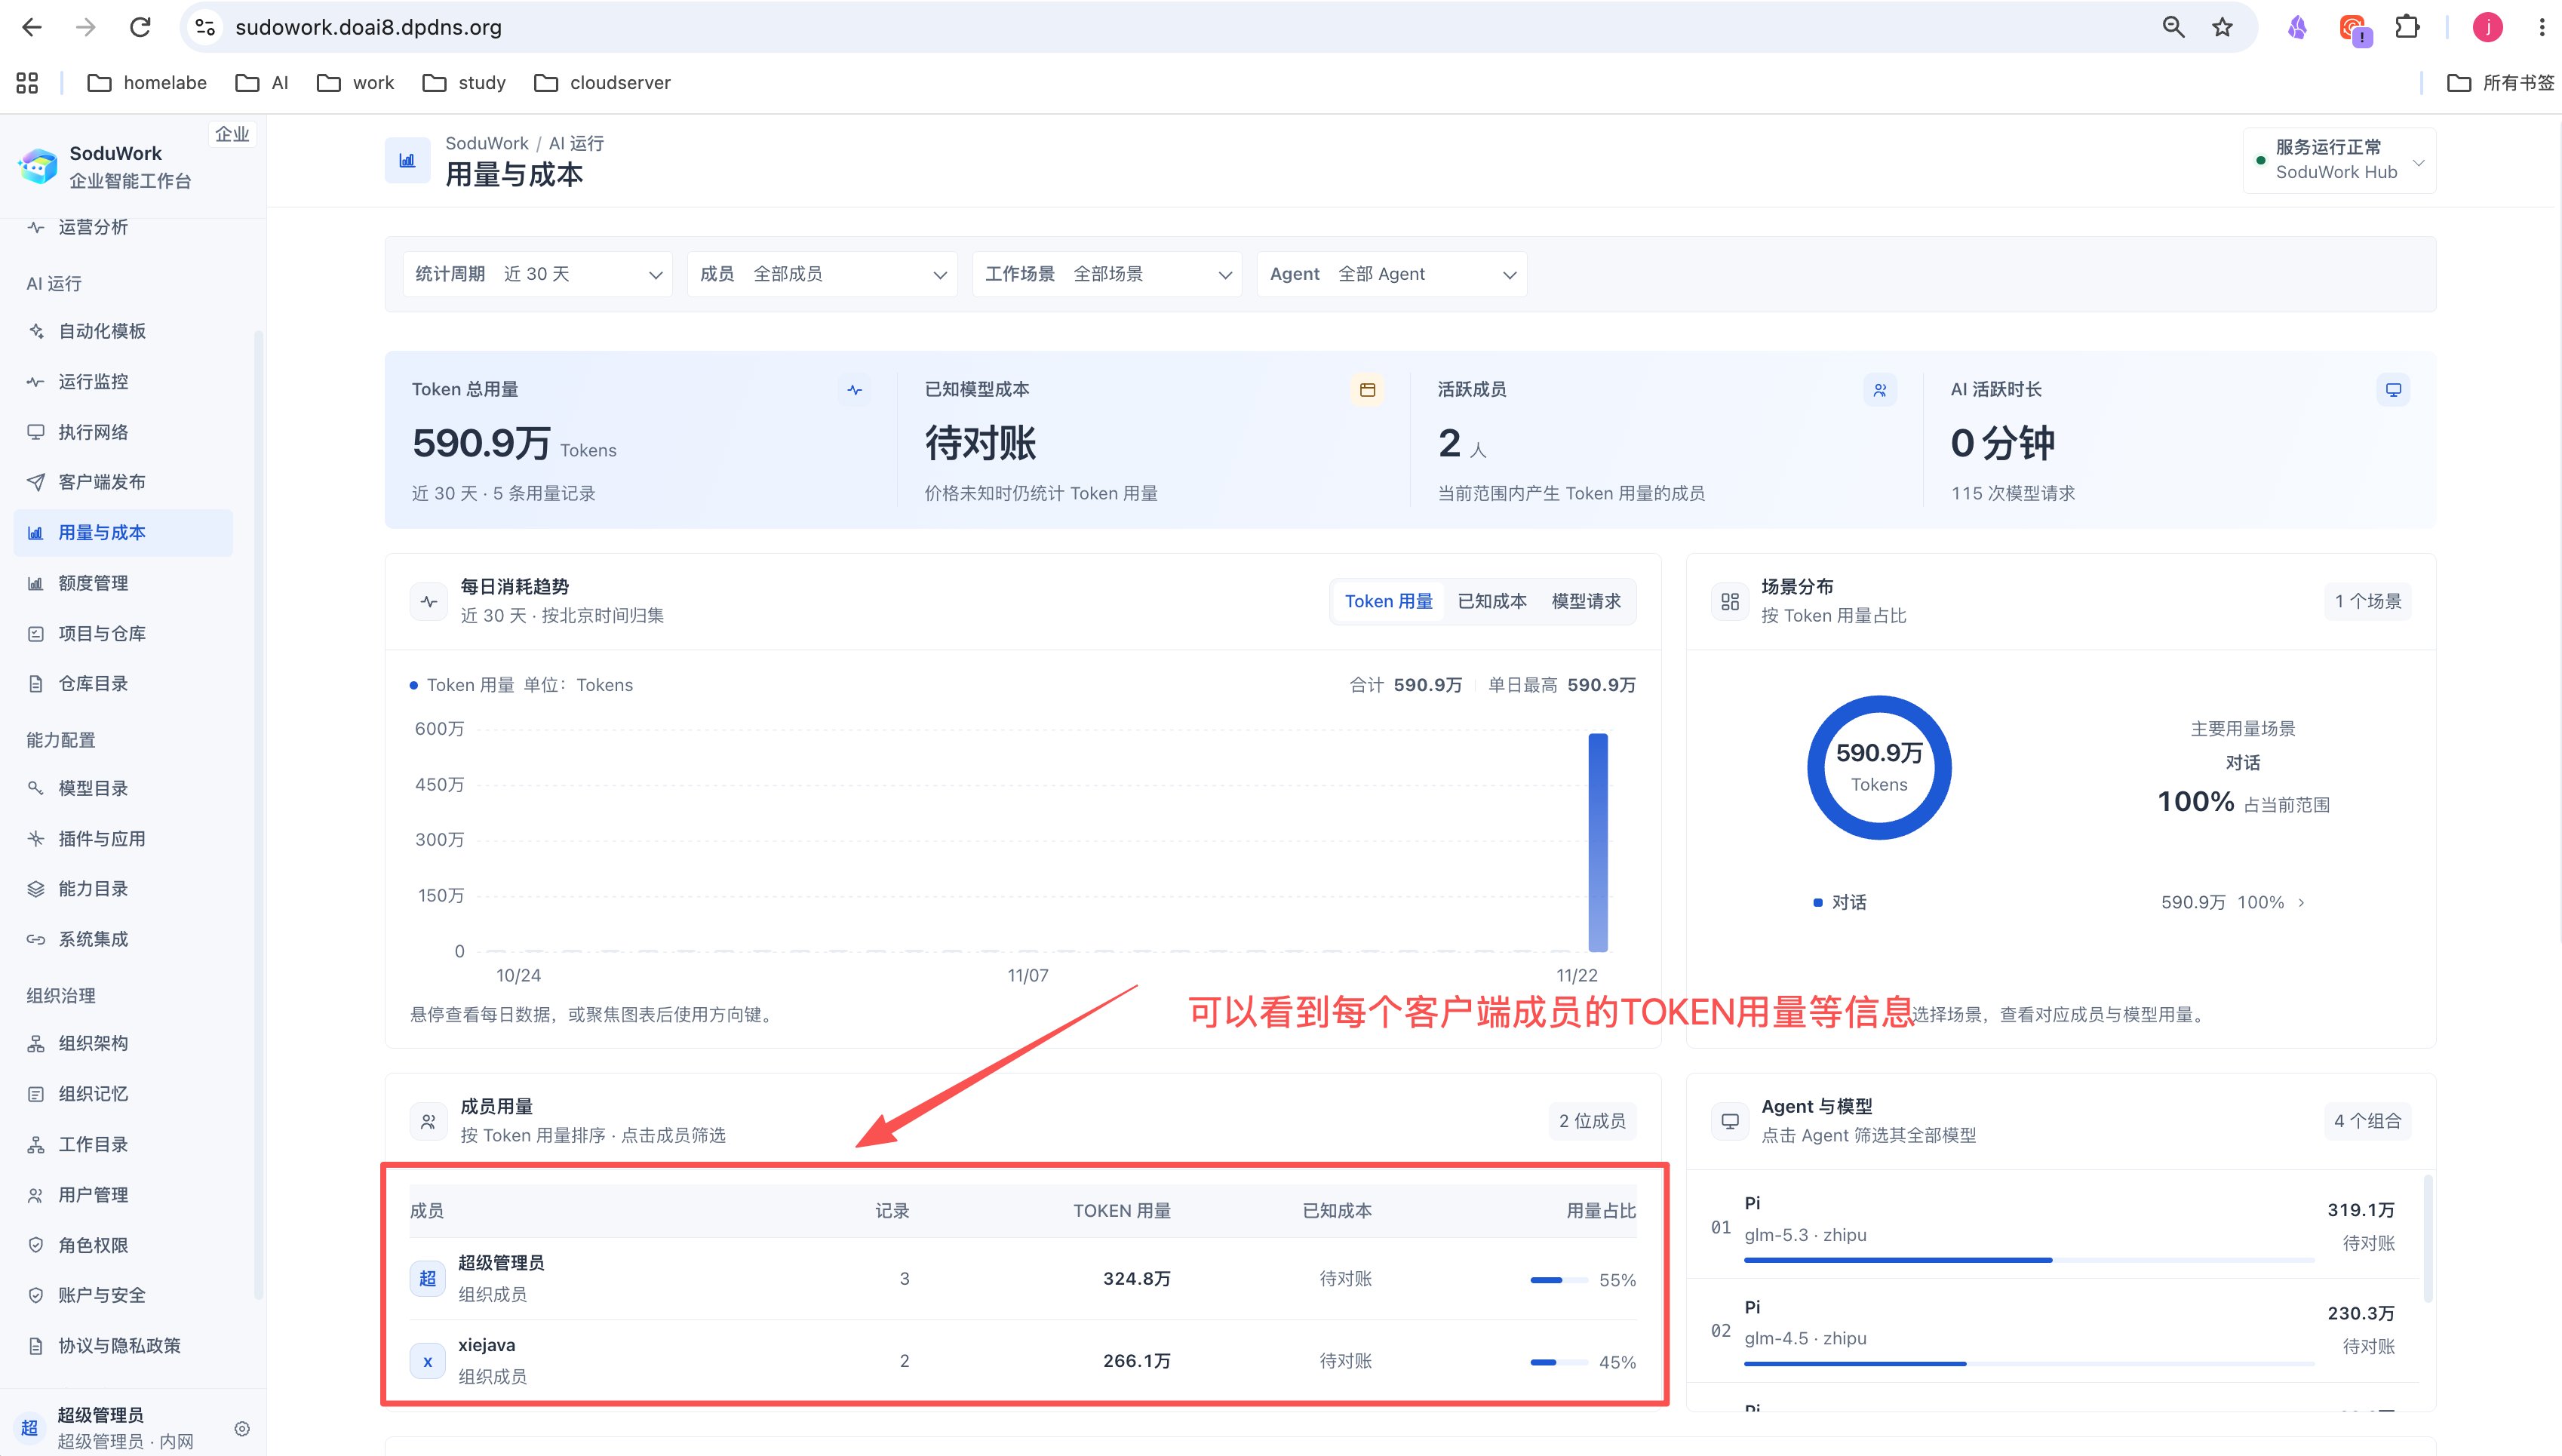
「用量与成本」里按成员看 Token 用量:两个成员、近 30 天 590.9 万 Tokens,谁用了多少一清二楚——团队再大一点,这就是 AI 开销的账本:
至此部署侧全部收口:服务在自己机器上、入口验证过、客户端连着、Agent 就位。才轮到真正有意思的部分。
第二部分:实测——让 Agent 在 AI-miniSOC 上干一个真需求
靶子就选我一直在写的 AI-miniSOC。
需求从哪来:一个真实的使用痛点
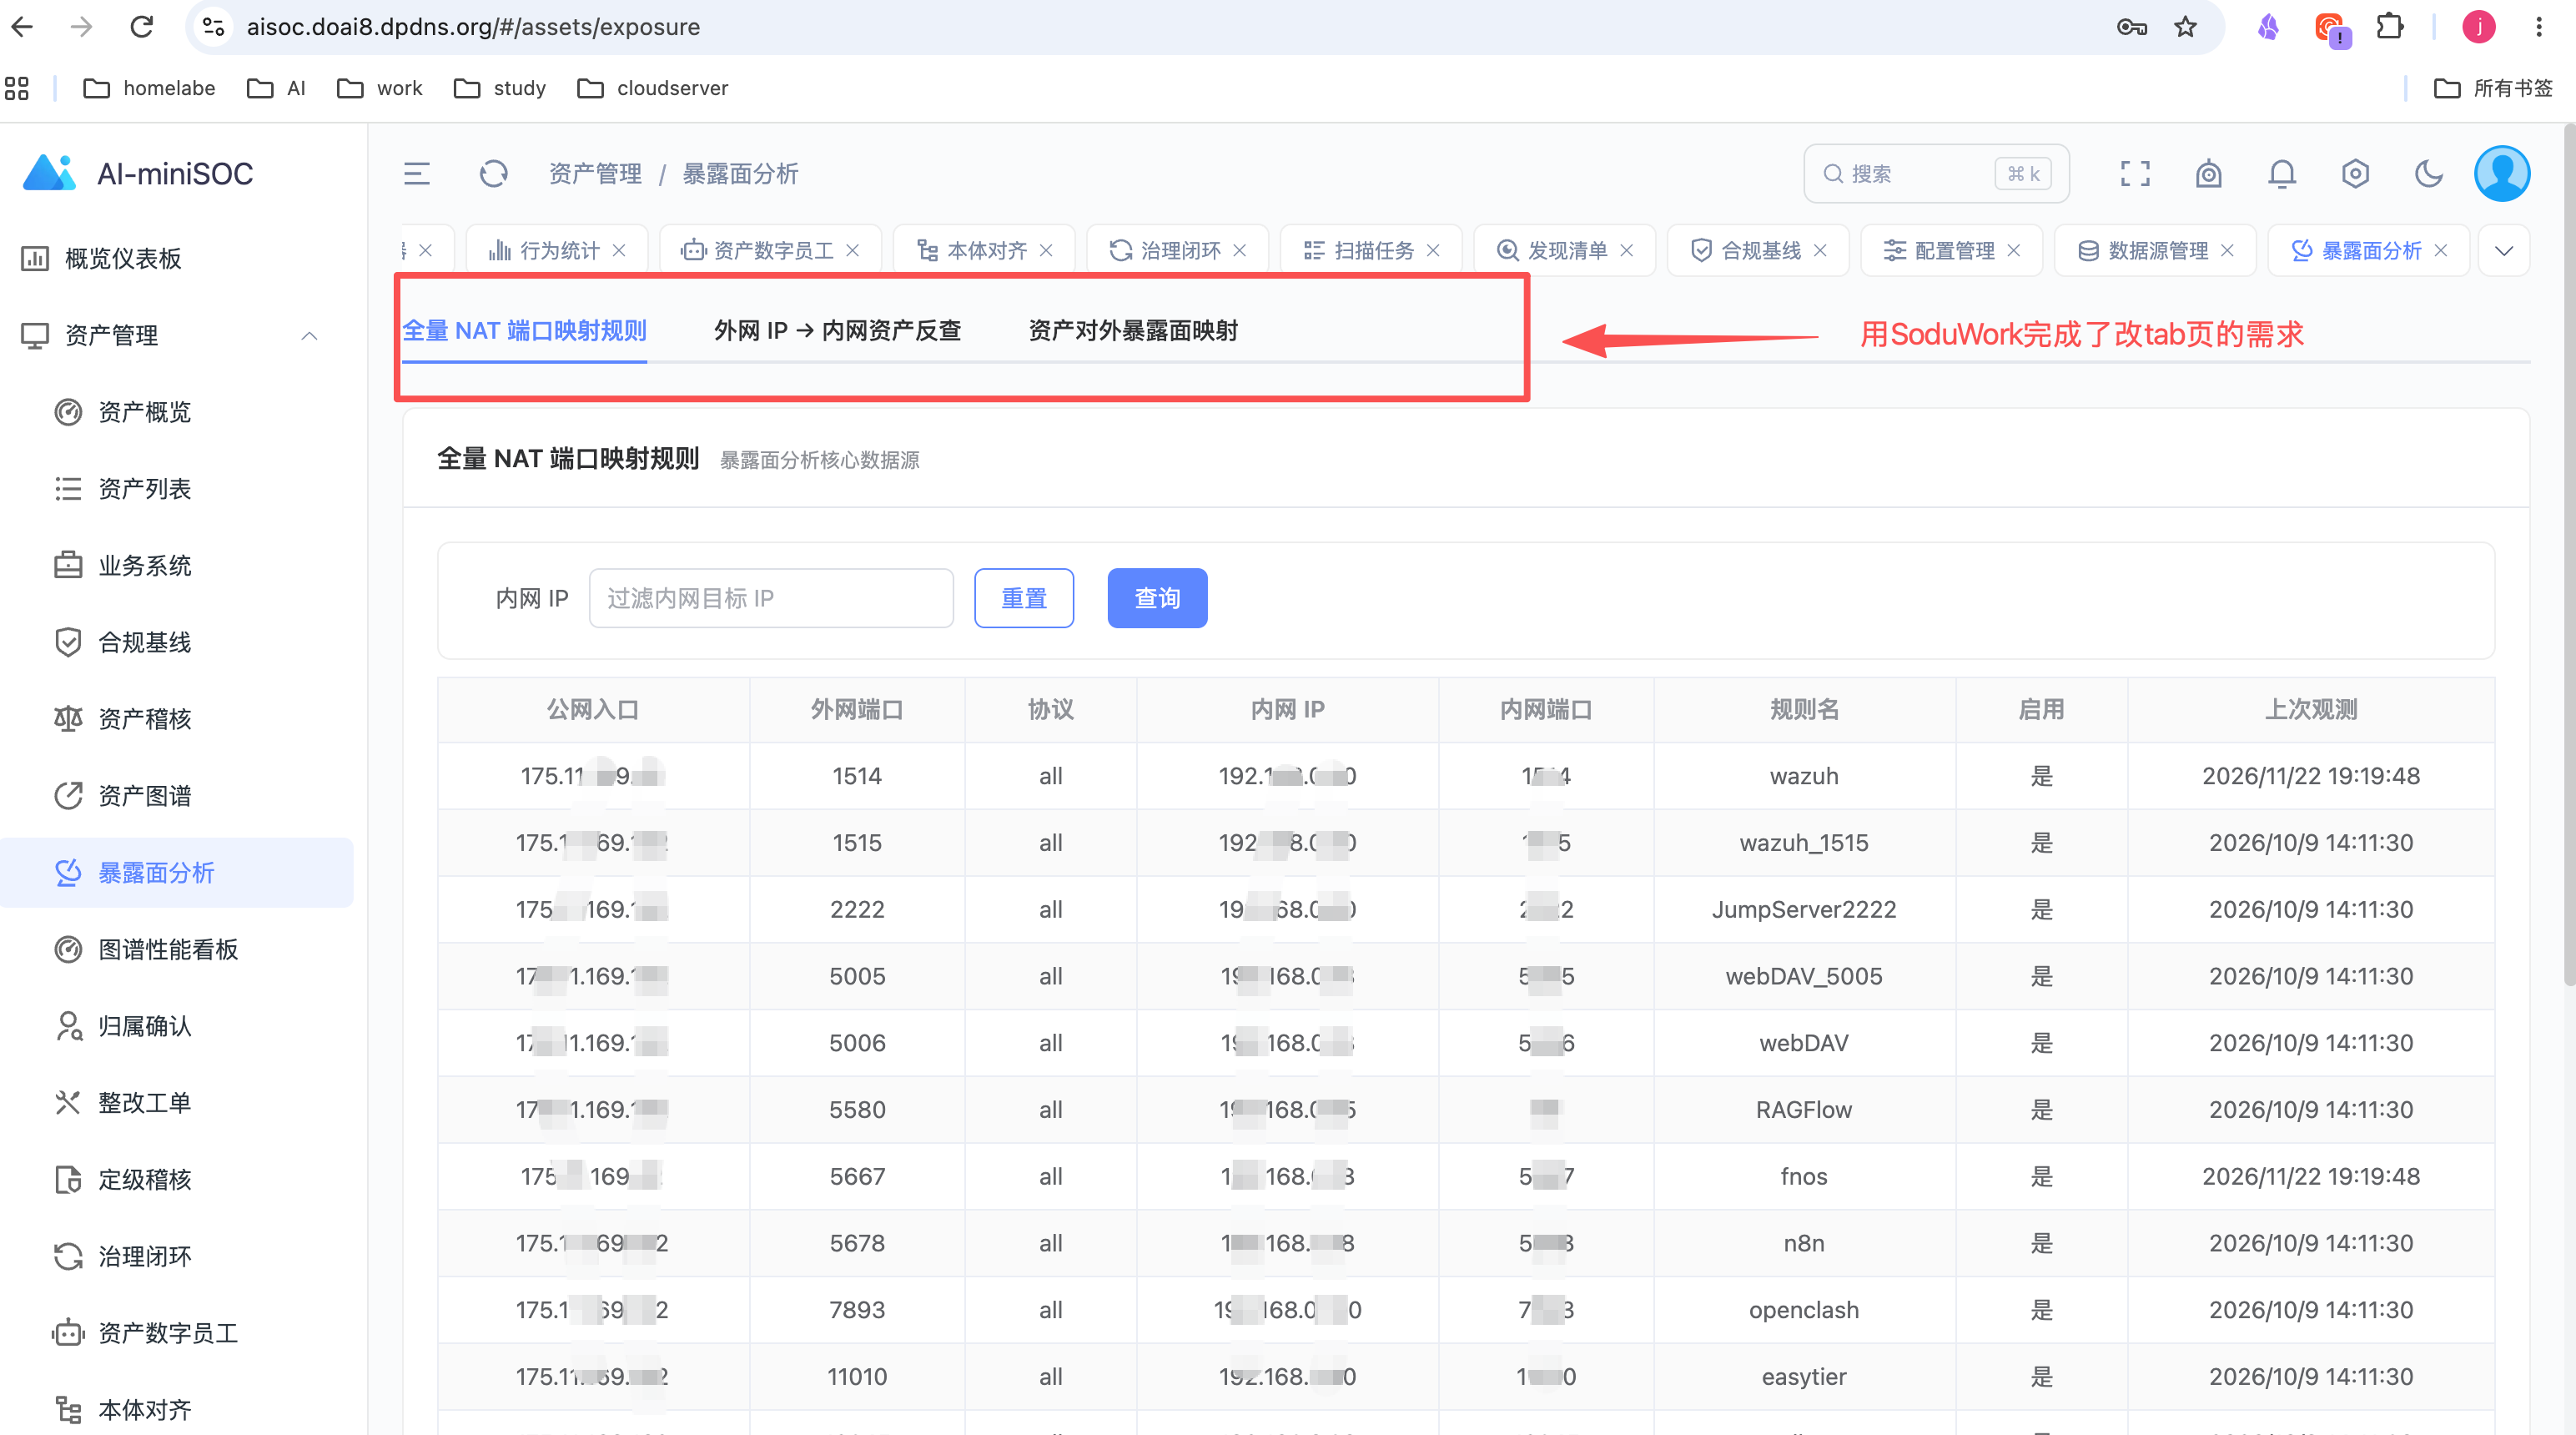
不是编造的测试题,是我自己用 AI-miniSOC 时真实碰到的不顺手:暴露面分析页面把「NAT 规则、外网 IP 反查、资产映射」三个区块堆在同一页里,内容一多就挤成一团,列表显示不全,来回滚才能看全。
需求本身很小:改成 Tab 布局,每个区块一个页签,点切换不挤;页签顺序按使用频率重排。小到能验收,真到有价值——这正是拿来做第一次闭环演练的理想尺寸。这个上午我在需求池里先后提了三条相关需求:三个区块改 Tab 切换、界面细节优化、Tab 顺序调整,都挂在 AI-miniSOC 项目下。
SoduWork 的需求生命周期
先把 SoduWork 的主张画出来。一个需求在需求池里的完整流转长这样:
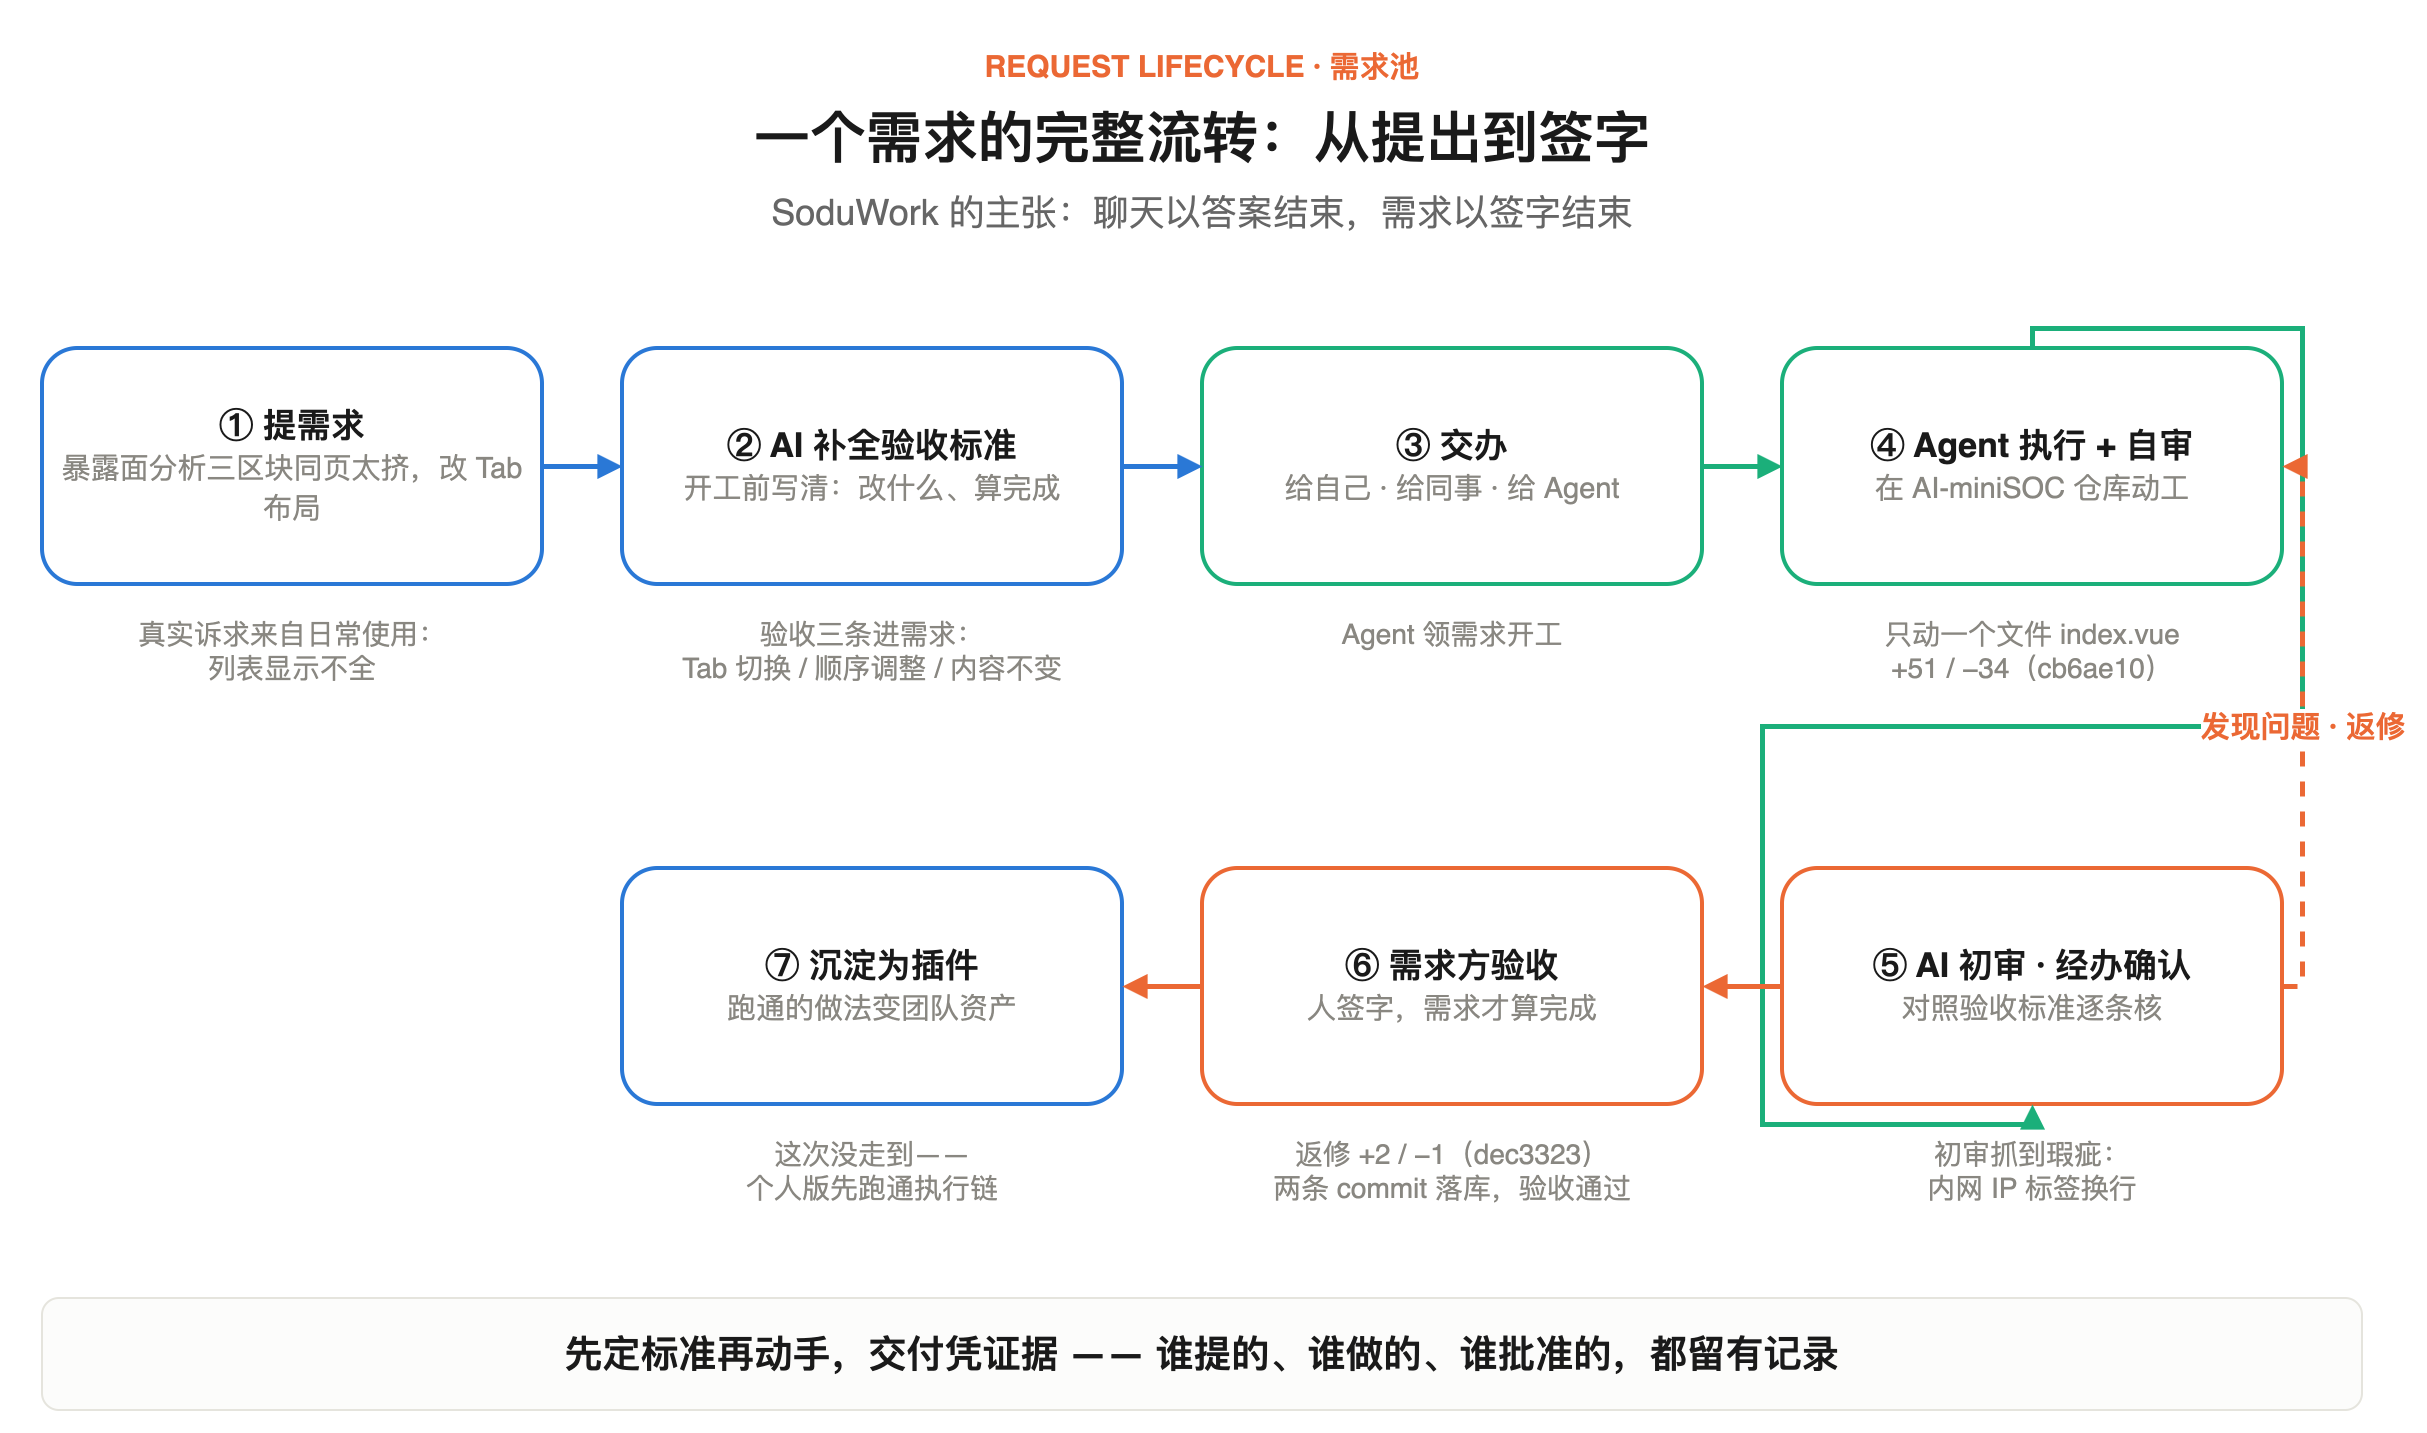
七个步骤,下面灰字是这次实测对应发生的真事。核心设计就一句话:先定标准再动手,交付凭证据——开工前把「改什么、算完成」写进需求,验收时逐条对,谁提的、谁做的、谁批准的,都留有记录。
开工前:AI 帮我把验收标准写清楚
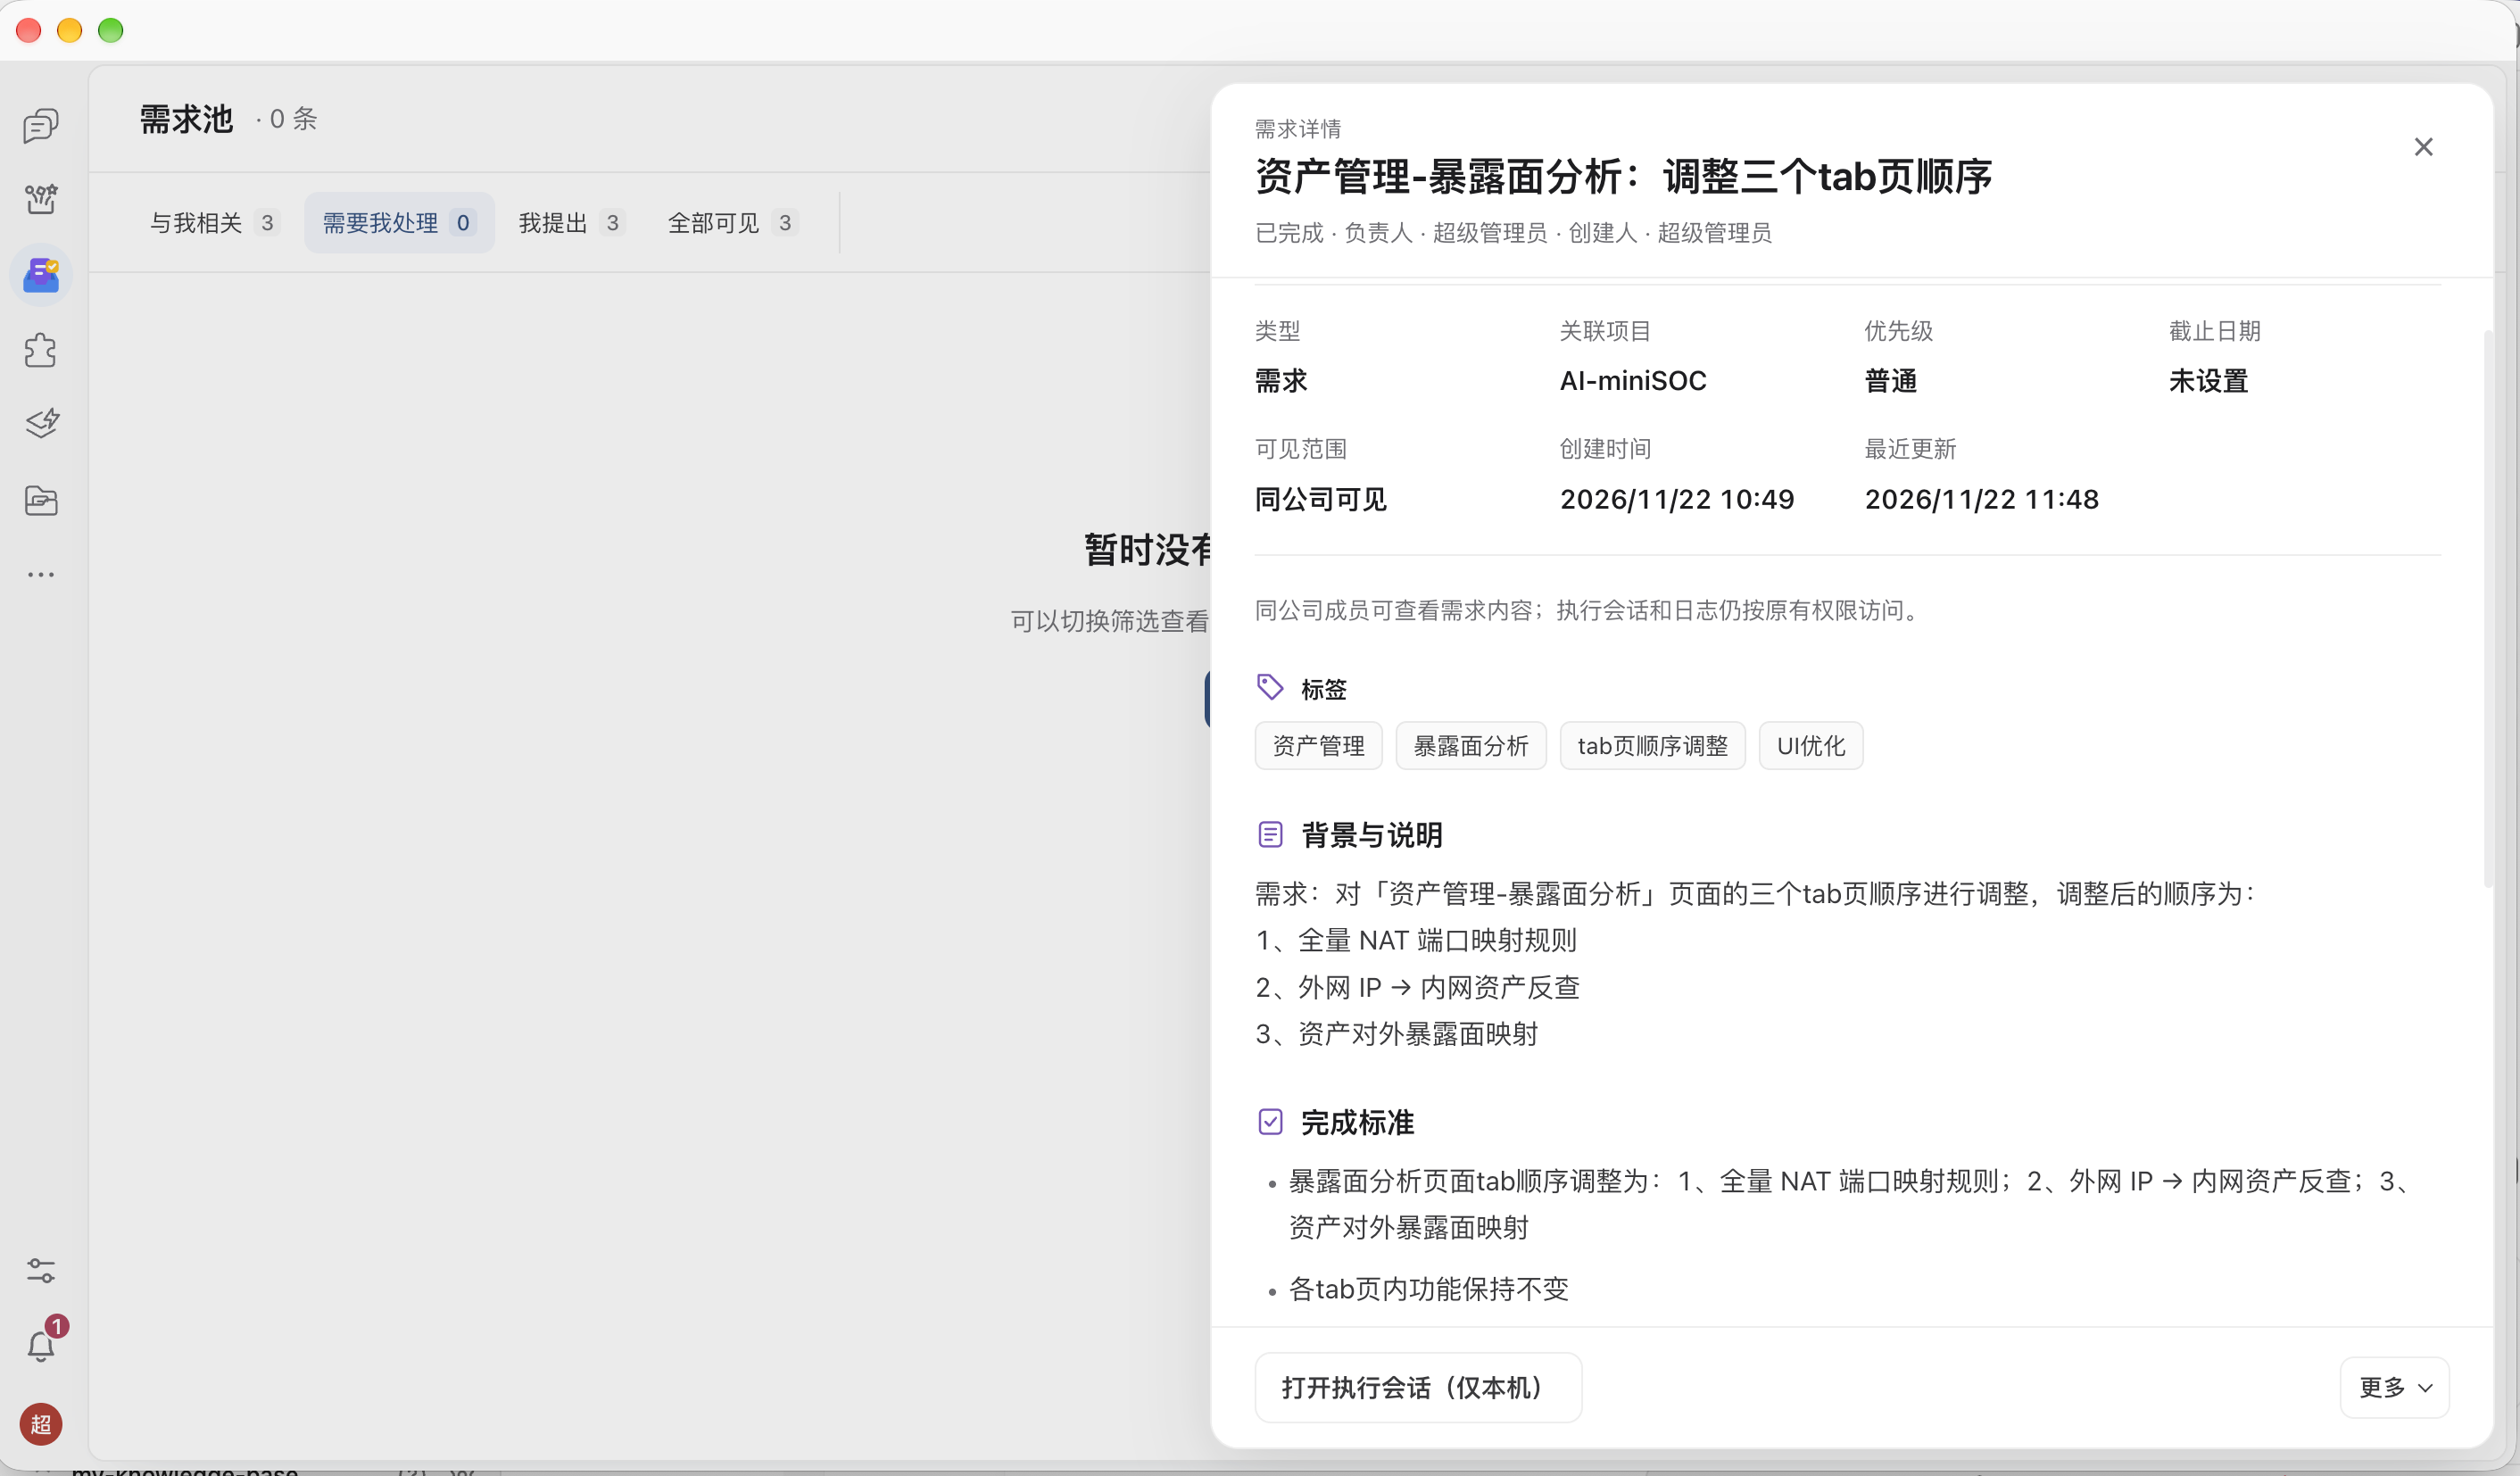
以「调整三个 tab 页顺序」这条需求为例,看它在 SoduWork 里的样子——AI 先把我的口语诉求补全成结构化需求:背景与说明写清改什么,完成标准写成可逐条勾对的条目,标签自动打好:
- 顺序调整为:①全量 NAT 端口映射规则 → ②外网 IP → 内网资产反查 → ③资产对外暴露面映射;
- 各 tab 页内功能保持不变。
加上前一条「三个显示区域改为 Tab 页切换」需求里的标准(改 Tab 切换、功能不变),整个需求系列的验收边界在开工前就写清了。这些条目现在看平平无奇,但它们是后面初审能「抓到瑕疵」的前提——没有写进需求的标准,初审就没有抓手。
然后交办:需求交给 Agent,Pi 领单开工,在 AI-miniSOC 仓库里动工。
Agent 执行:一个文件,+51/−34
Agent 交付的改动干净得有点意外:只动了一个文件 src/frontend/src/views/asset/exposure/index.vue,+51/−34,一条 commit 落库:
cb6ae10  2026-11-22 11:21
✨ feat(asset): 暴露面分析改为 Tab 布局并调整顺序为 NAT规则/外网IP反查/资产映射

1 file changed, 51 insertions(+), 34 deletions(-)
commit 正文里它自己列了三点:用 ElTabs 页签切换解决三区块同页拥挤;Tab 顺序按 ①②③ 调整;各区块内容与名称不动。和验收标准逐条对得上。
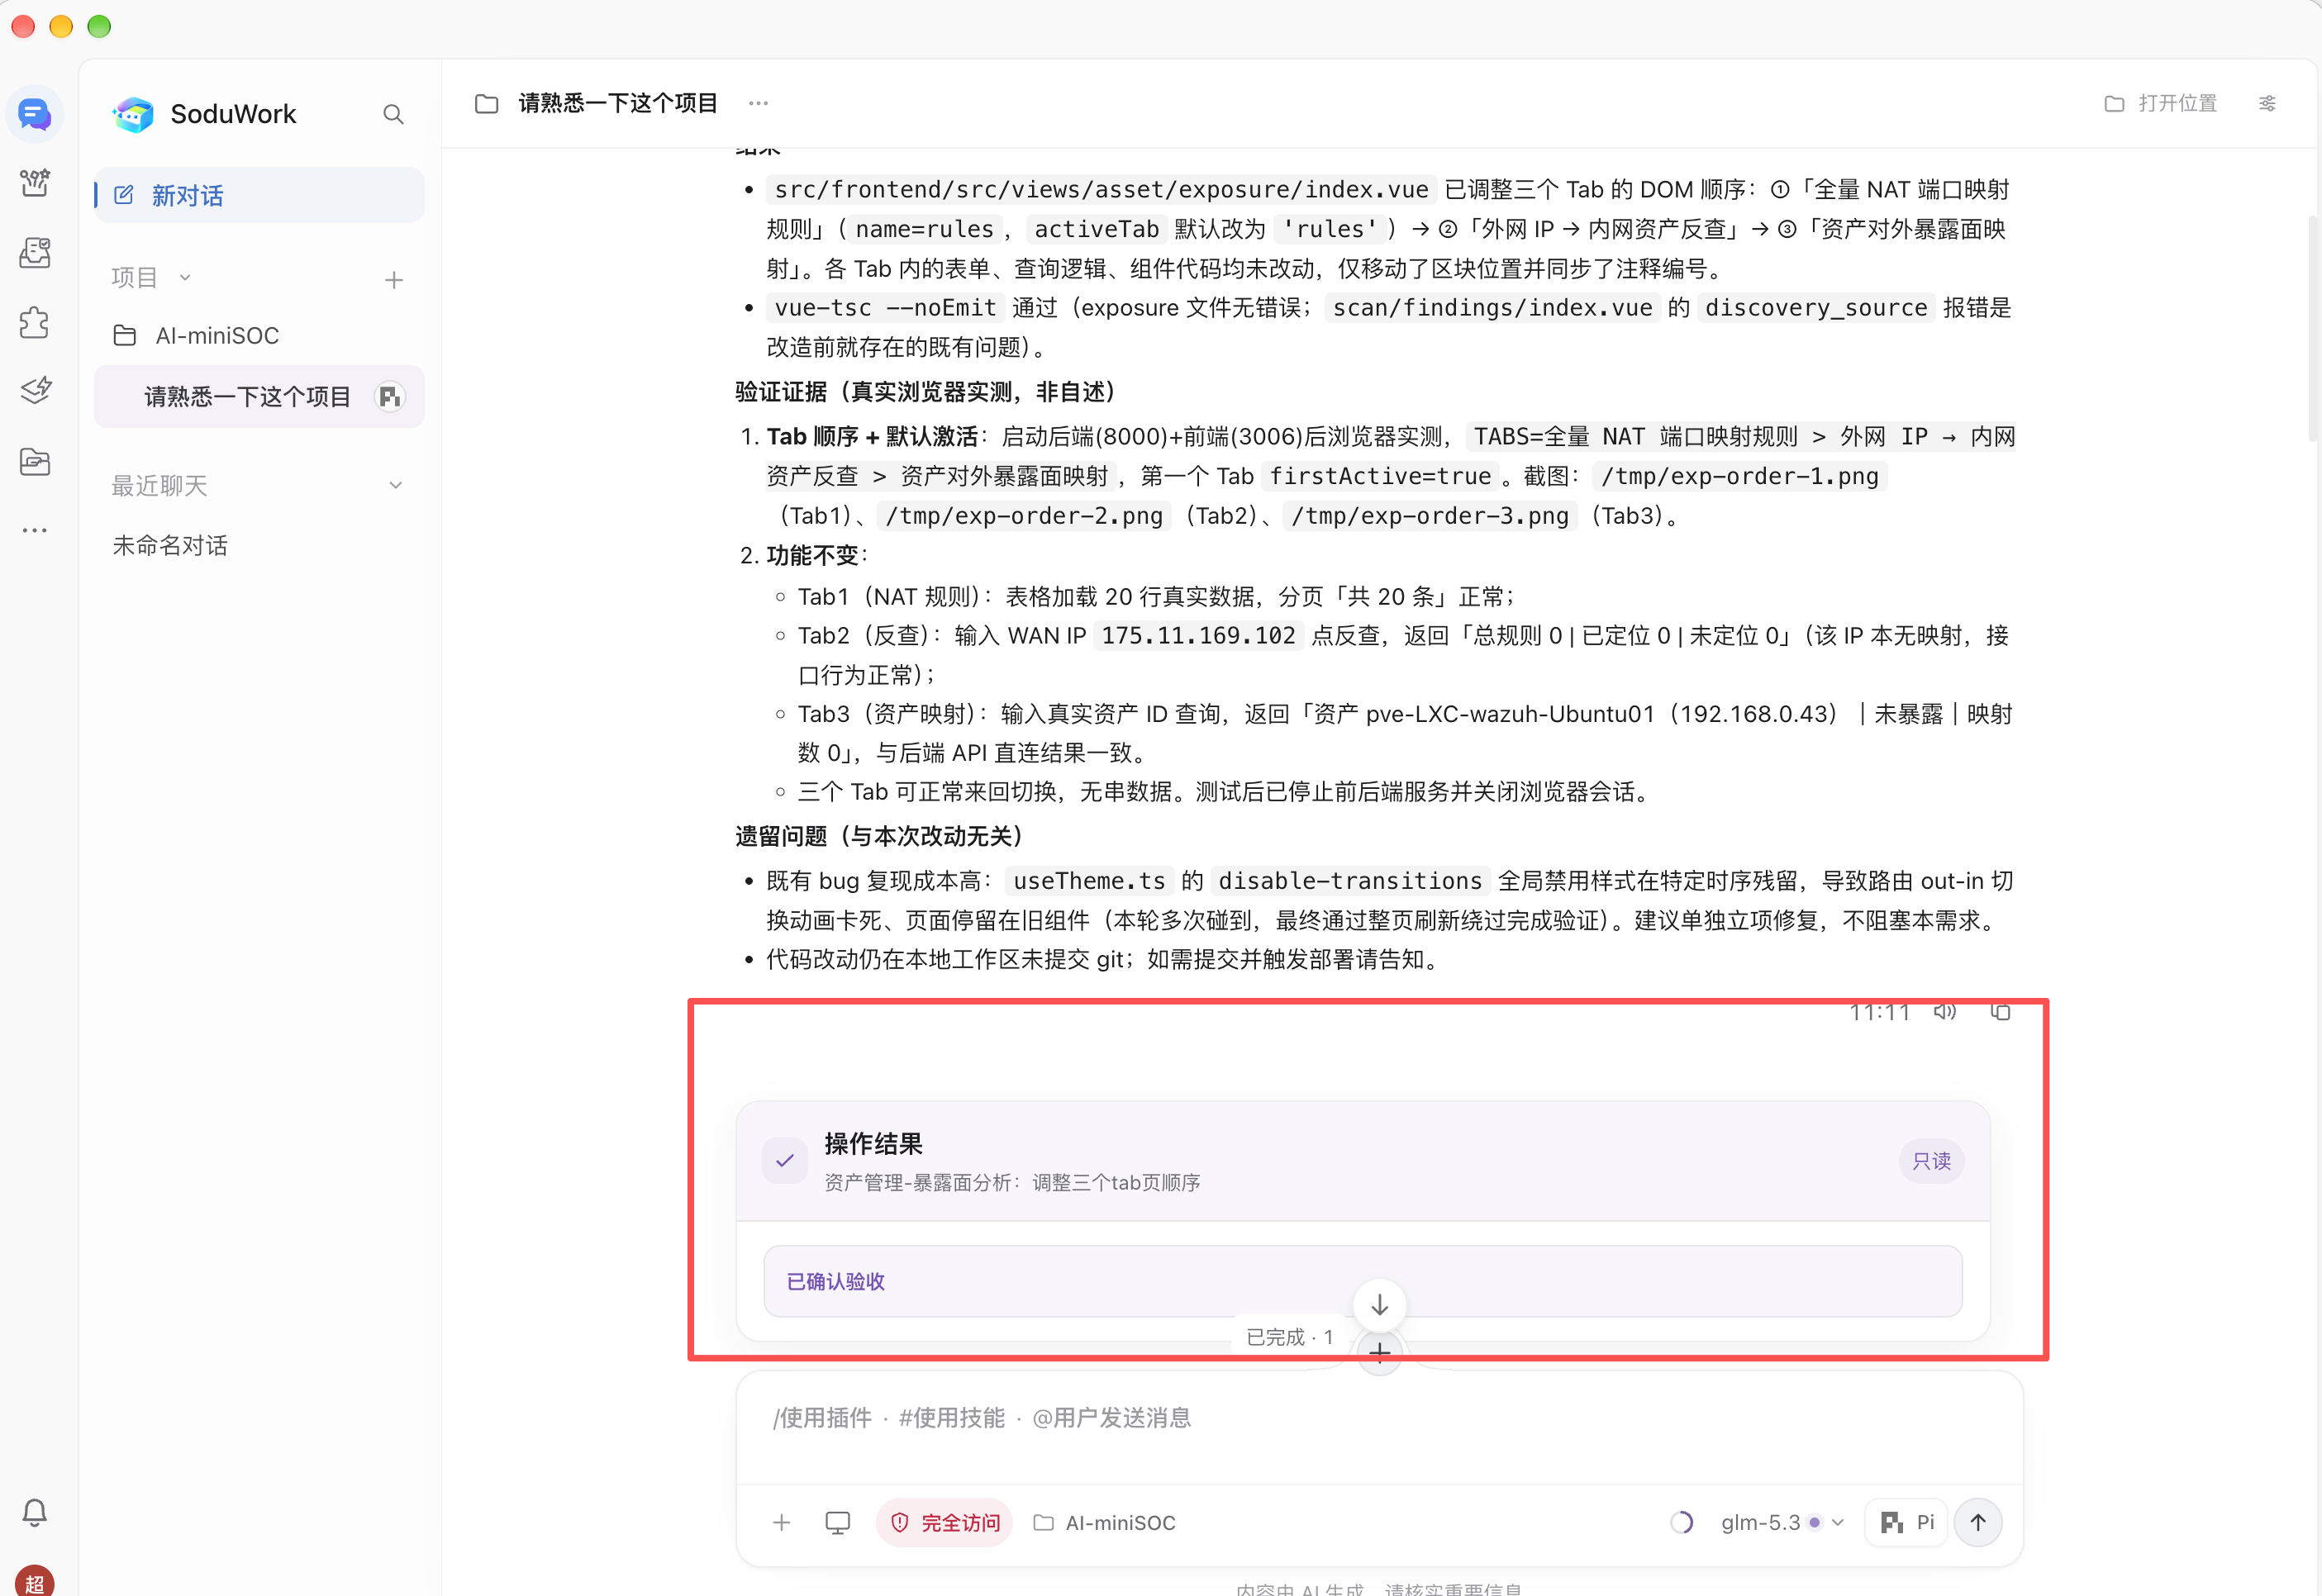
比 commit 更值得看的是它在 SoduWork 里的交付报告。有一节标题起得很直白——「验证证据(真实浏览器实测,非自述)」:起后端、起前端,浏览器里三个 Tab 逐个点过去,Tab1 加载 20 行真实数据分页正常,Tab2 拿真实公网 IP 反查,Tab3 拿真实资产 ID 查询且与后端 API 直连结果一致,三个 Tab 来回切换无串数据;vue-tsc --noEmit 类型检查通过。末尾还诚实地列了两条遗留问题:一个改造前就存在的既有 bug(注明与本需求无关、建议单独立项),以及「代码改动仍在本地工作区未提交 git,如需提交请告知」——提交时机留给需求方掌握。
改造后的页面长这样,三个页签各管一摊:
初审与返修:抓到一个换行瑕疵
Agent 自审通过后进入 AI 初审,初审对照验收标准逐条核——真抓到了一个瑕疵:某个内网 IP 的标签在页签里发生了换行,显示不完整。打回,返修。
Agent 的返修同样克制,还是那个文件,+2/−1,第二条 commit:
dec3323  2026-11-22 12:32
🐛 fix(asset): 修复暴露面分析内网 IP 标签换行

1 file changed, 2 insertions(+), 1 deletion(-)
11:21 交付,12:32 返修完成,一小时内走完「执行 → 初审 → 返修」一个来回。这个环节是我这次实测里觉得最有含金量的部分:初审不是橡皮图章,它真的在按验收标准挑毛病;返修不是重写,是精确到一行的修补。
验收:两条 commit 落库
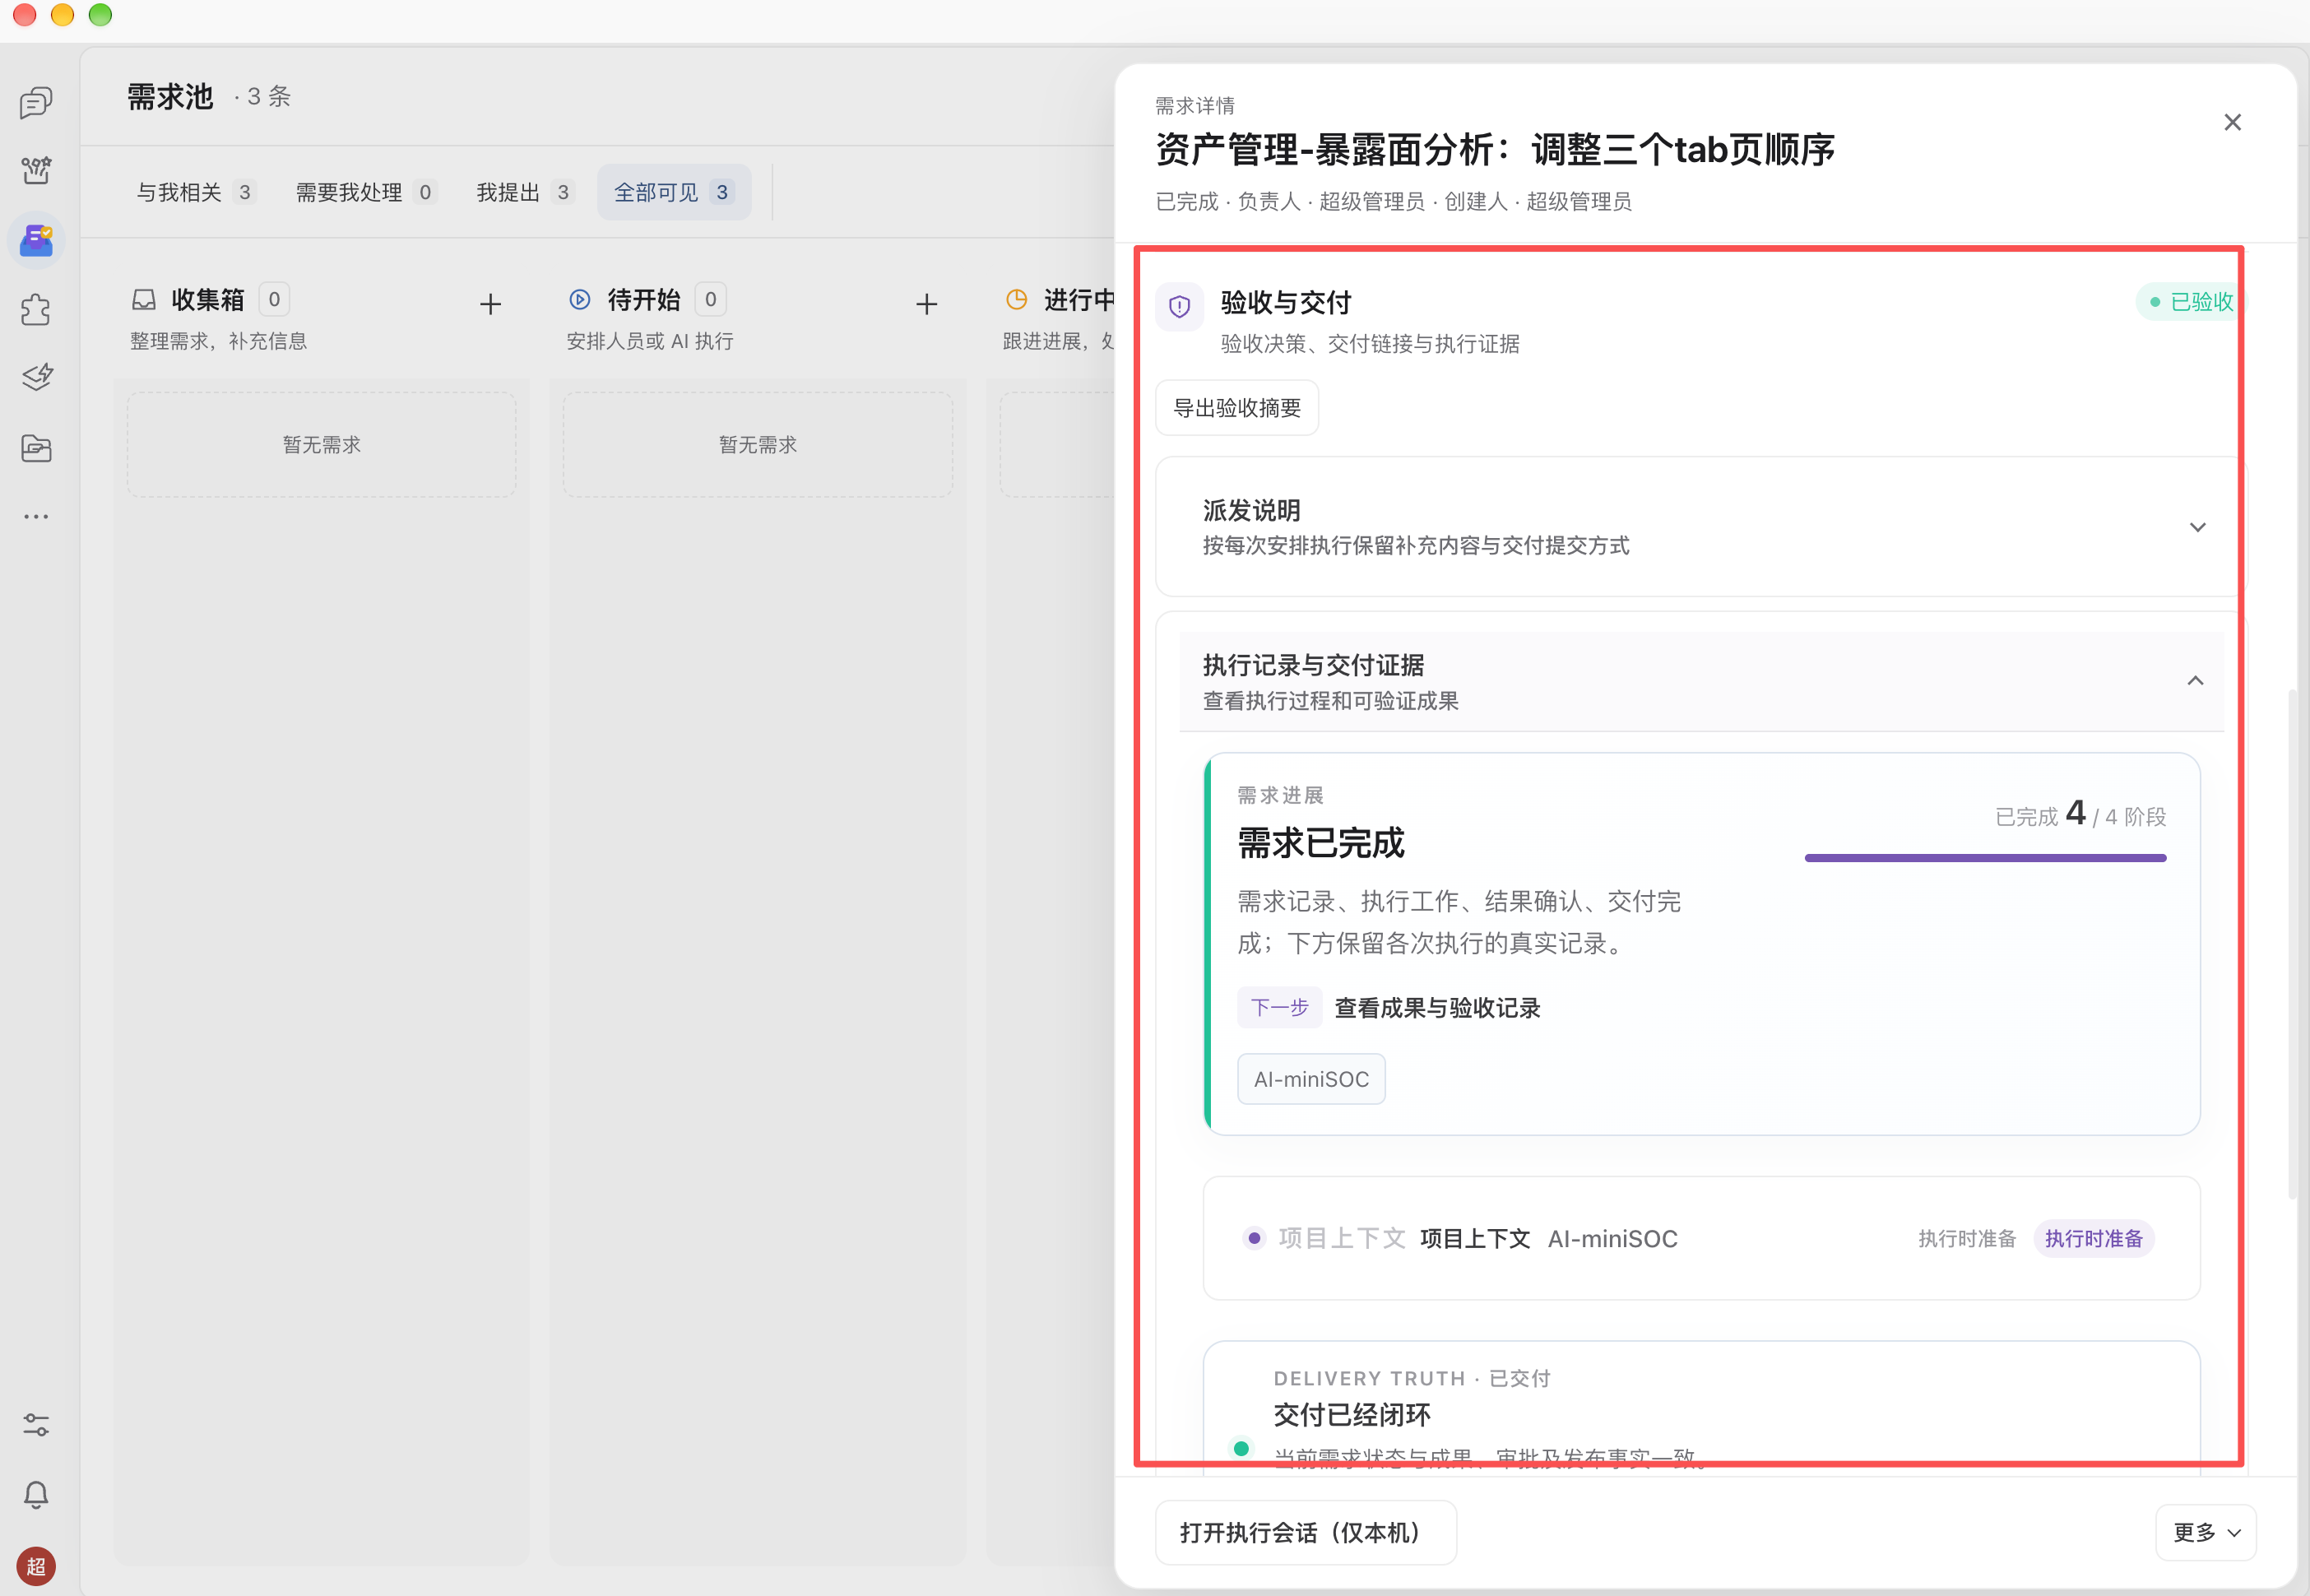
最终验收:完成标准逐条核对——顺序 ✓、各 tab 功能不变 ✓,外加换行瑕疵已修 ✓。需求方的「验收与交付」卡上,状态亮起绿色「已验收」,进度 4/4 阶段走满,交付闭环:
整个交付的证据链就是仓库里两条 commit:
| commit | 时间 | 内容 | 规模 |
|---|---|---|---|
cb6ae10 | 11-22 11:21 | 改 Tab 布局 + 调整顺序 | 1 文件 +51/−34 |
dec3323 | 11-22 12:32 | 修复内网 IP 标签换行 | 1 文件 +2/−1 |
谁提的(我)、谁做的(Agent)、谁批准的(我),在 Hub 里都有记录;做了什么,在 git 里都有 diff。聊天以答案结束,需求以签字结束——这句话我算是实测到了前半句的完整含义。
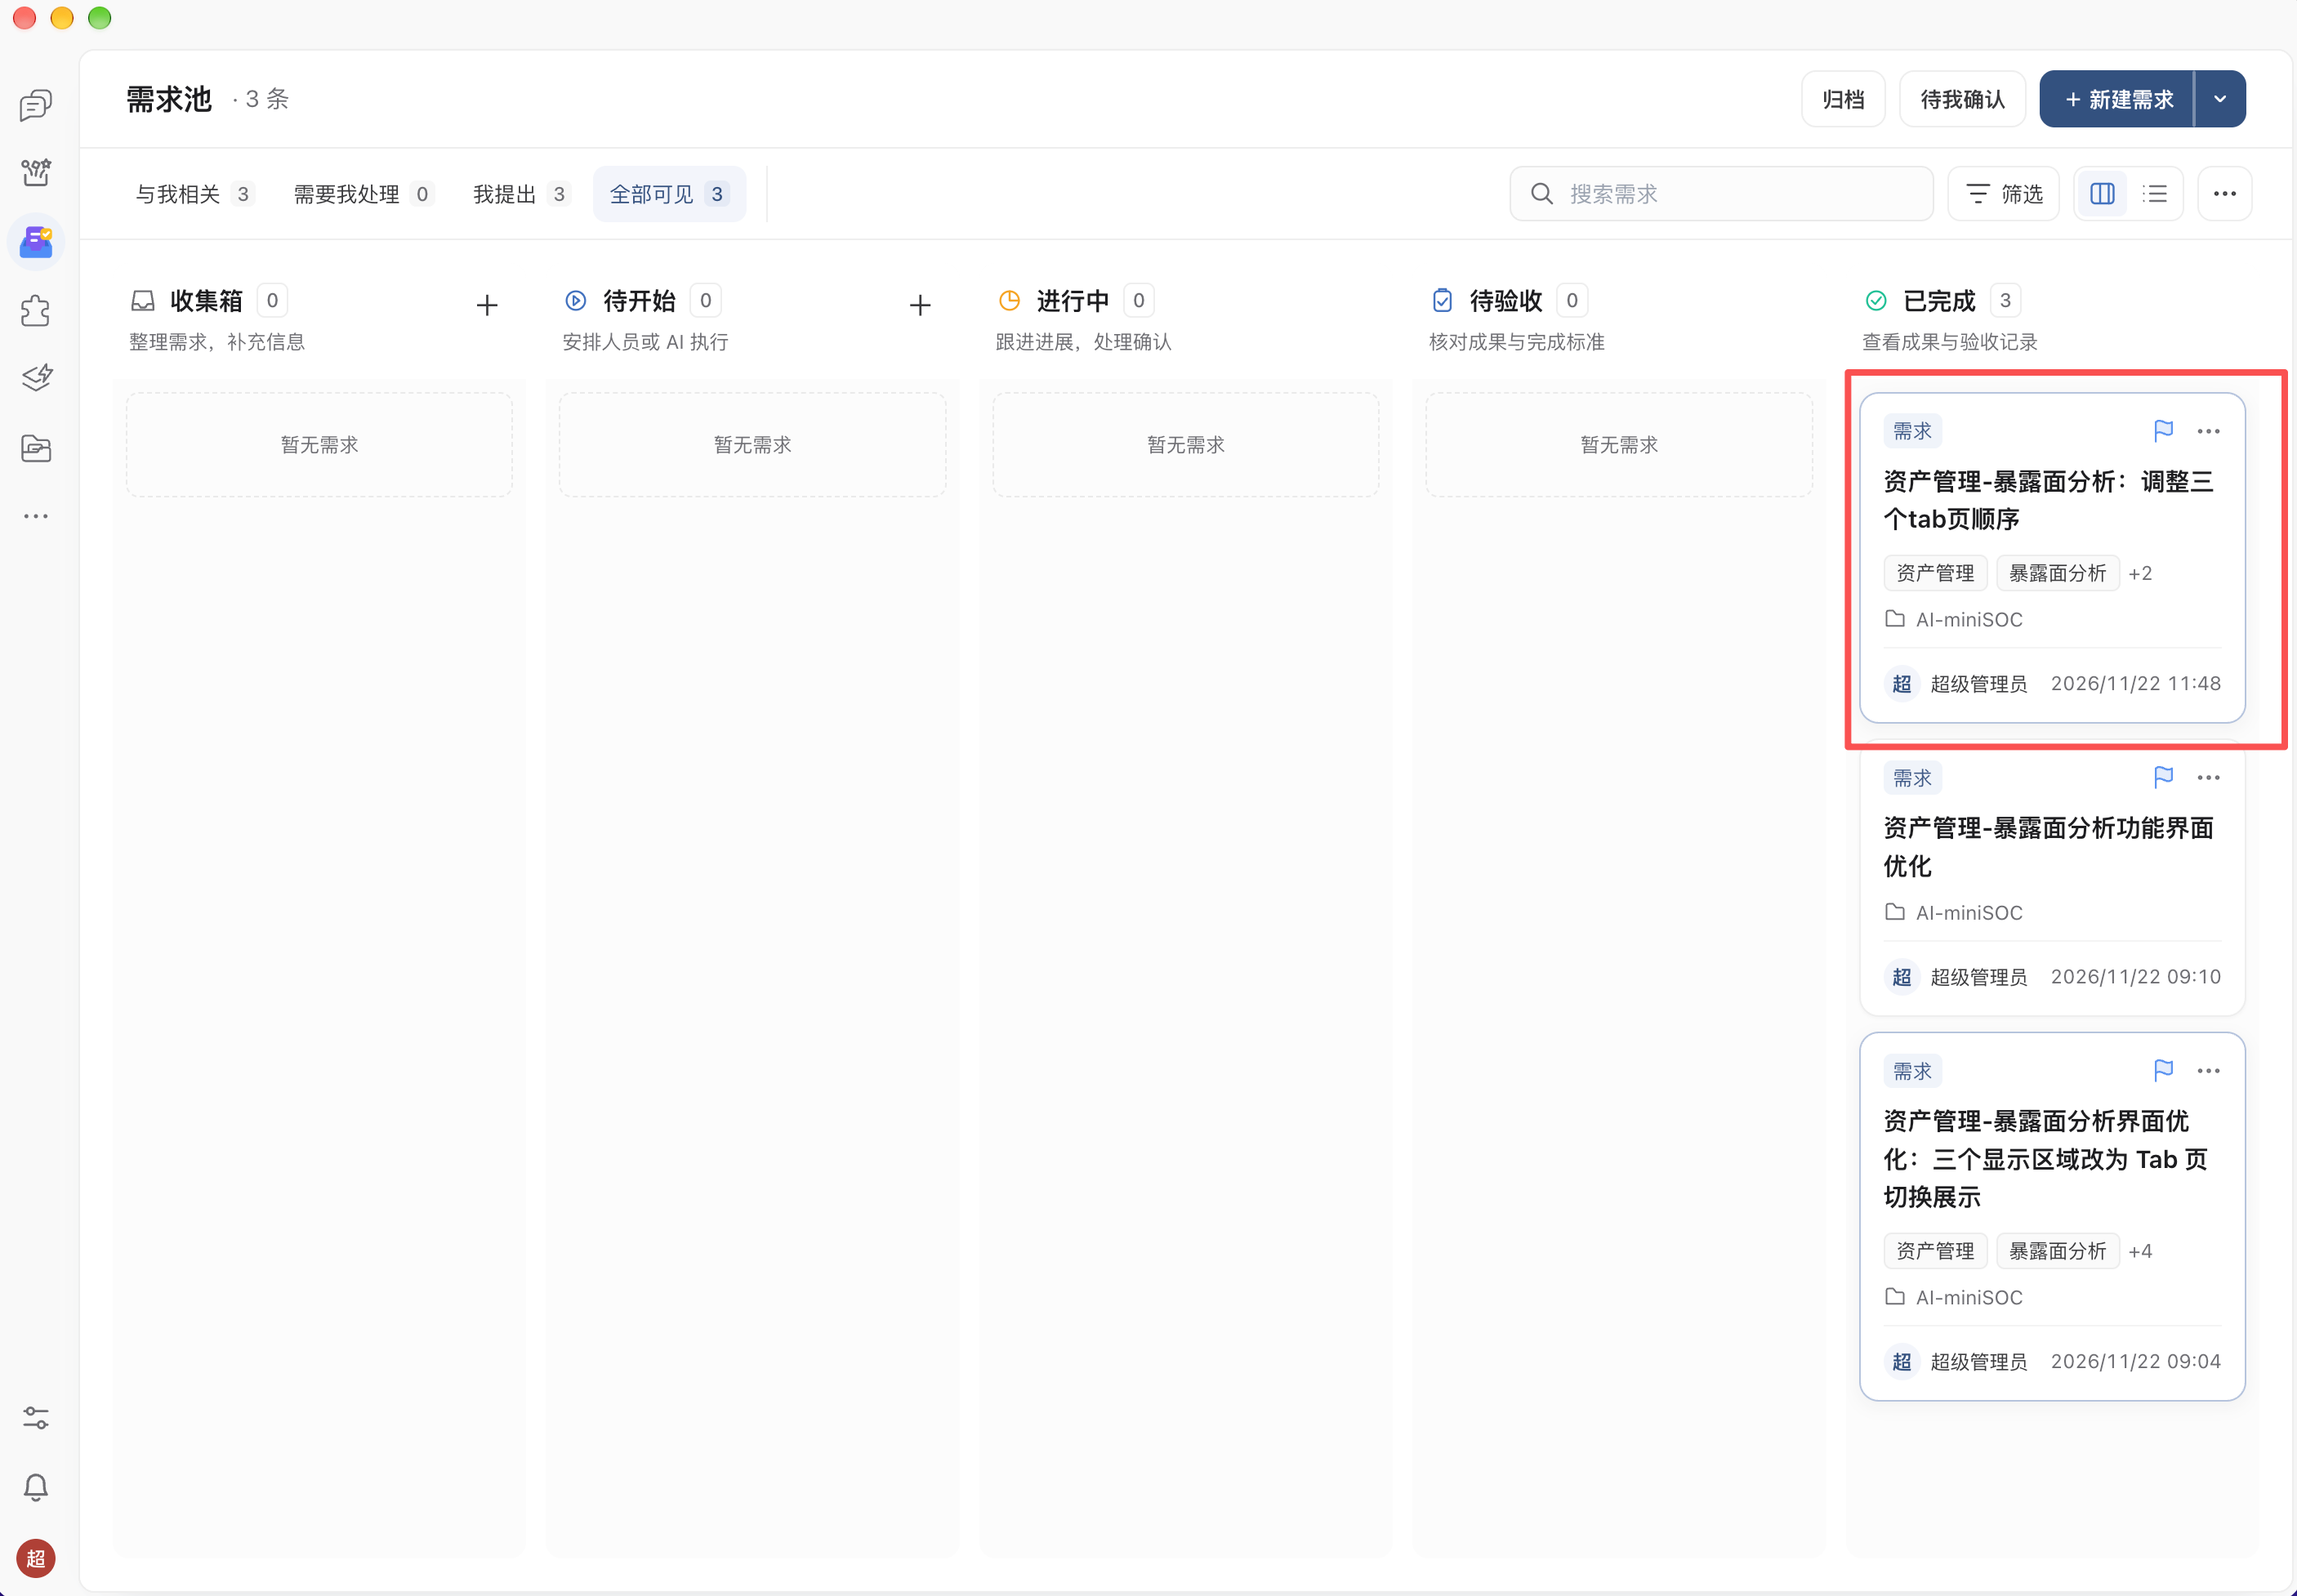
回到需求池看板,这一组需求全部流转完毕:三条需求当天关闭,整条「提出 → 执行 → 初审返修 → 验收」的流程走完;第四条「修复 NAT 映射分页异常」还在进行中——需求池不是演示完就空的,它是持续在转的:
没走到的一步:沉淀为插件
生命周期第七步「沉淀为插件」这次没走到:把这次跑通的做法沉淀成团队可复用的插件,需要的是多次同类需求跑通后的模式提炼,一次实测还不够格。个人版先把执行链跑通,沉淀留给下一次——诚实地说出来,比硬凑一个「全流程通关」更有价值。
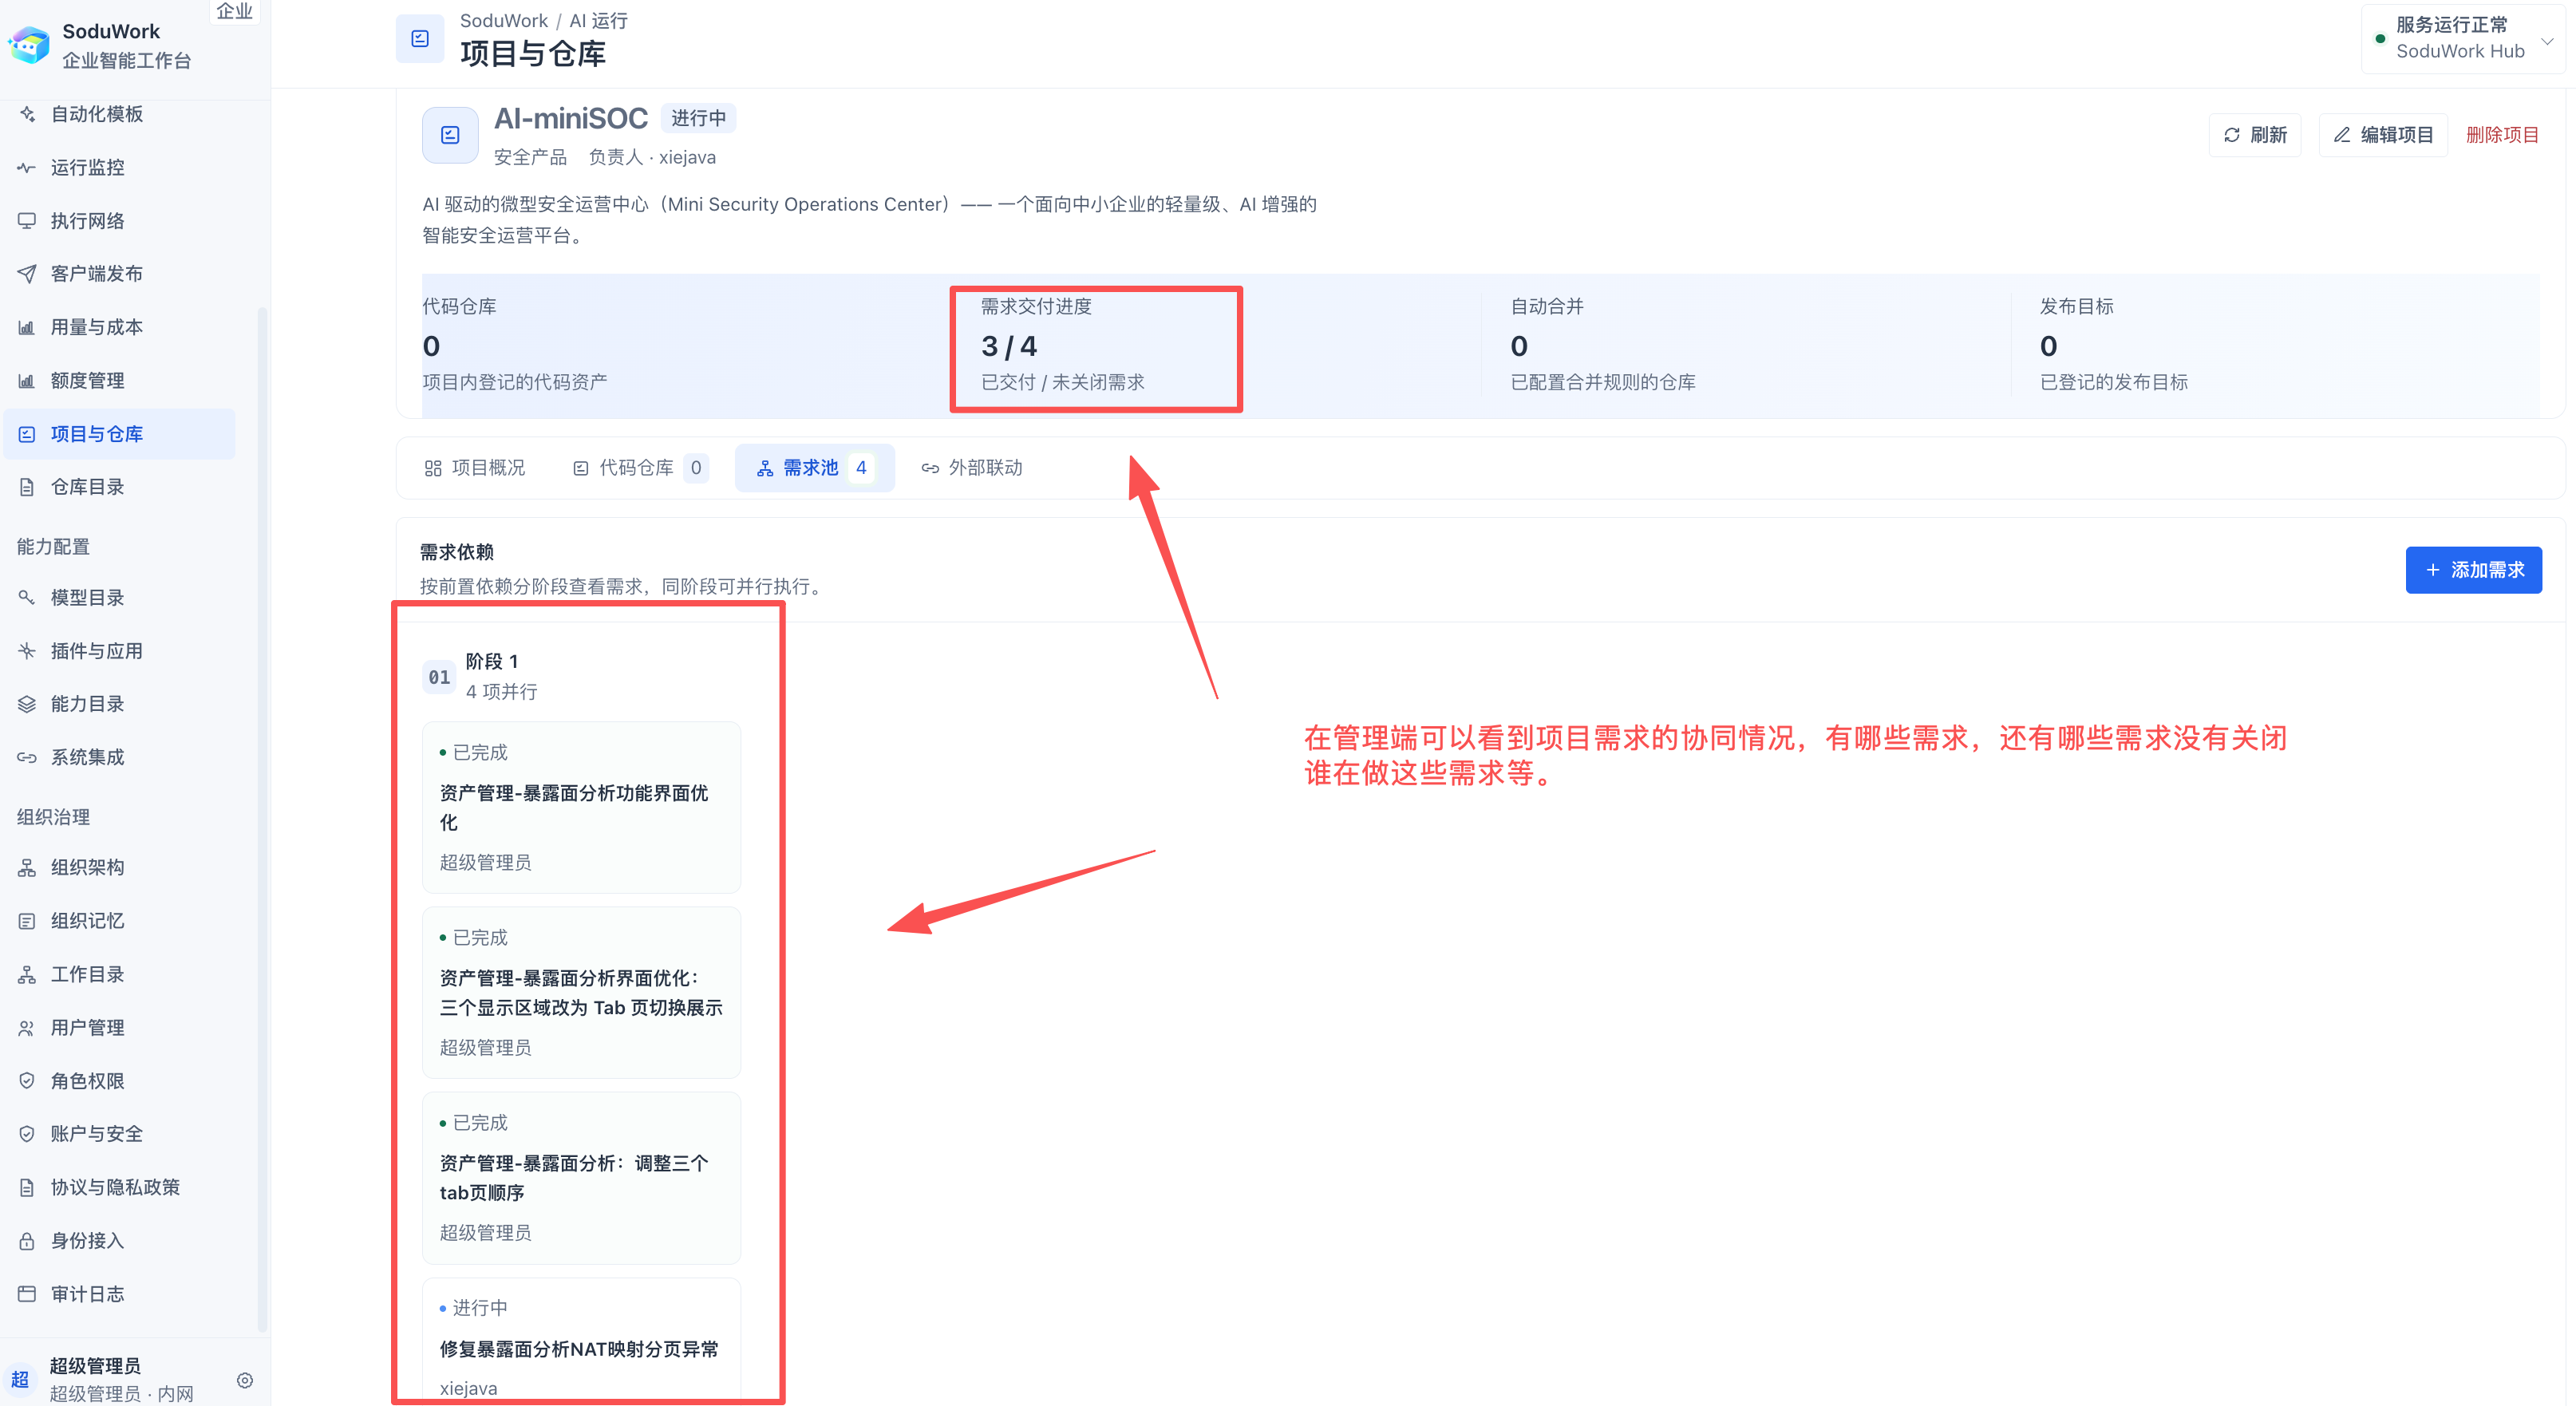
倒是管理端给了个意外之喜:在「项目与仓库」里打开 AI-miniSOC,项目需求池 4 条、交付进度 3/4、谁在做什么,整个协同情况一屏看全。管理者视角和执行者视角,是同一个需求池的两面:
踩坑清单,直接抄
部署部分:
curl -I探活会骗你:/healthz对 HEAD 返回 404,必须用 GET;- 先确认自己在哪台机器上:
ifconfig一遍再动手,别假设 Hub 在 localhost——我的客户端 IP 和 Hub IP 就不是一个; - 别只测「通」,要测「是同一个」:反向代理能让两个地址都 200,只有比时间戳才能证伪;
- 公网暴露后要测鉴权:能访问 ≠ 该访问,401 才是好消息;
- 注意
activeHub指向:切错 profile,你测的是官方云,会得出完全错误的乐观结论; - 自签名证书是预期内的:本地 CA 签发,第一次连接处理信任即可。
实测部分:
- 第一次跑闭环,需求要小:小到能验收,真到有价值——「改 Tab 布局」这种尺寸刚好;
- 验收标准要开工前写:初审的抓手全在需求里的完成标准,没有它们初审只能走过场;
- 返修看 diff 规模:
+2/−1的返修说明 Agent 真的在精确修补,而不是推倒重来; - 要「验证证据」,不要「自述」:好的交付报告会自带实测证据——浏览器实测、类型检查、真实查询,连「代码还没提交 git」都写明。验收时先看证据区,再看结论。
下一步
这次跑通的是单需求的执行链。接下来想验证的:
- 签字是不是真的卡得住——不签字,需求能不能停在半路;
- 沉淀为插件——同类需求多跑几次后,做法能不能真的变成团队资产;
- 多 Agent 协作——一个需求拆给多个 Agent,需求池还能不能保持秩序。
那个才是 SoduWork 这个「AI 原生需求引擎」真正的野心所在。下次实测再来。
延伸阅读:
- 《一个人的 SOC》系列导航(18 篇) —— 本文第二部分的靶子 AI-miniSOC,完整来龙去脉在这里
- 人人都有 AI 之后,你的"目标函数"是什么? —— 工具平权之后,差距出在哪:会定验收标准的人
- SoduWork 开源仓库 —— MIT 协议,自托管文档在
ops/self-host/
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!