12 篇讲完"报告自动出、异常主动来",这一篇把镜头调转 180 度——
之前的所有篇章里,AI 都是你打开系统时它才工作:你查资产它翻译、你看告警它研判。但真正的安全运营不是你坐在屏幕前的时候才发生的。晚上十一点,你在 Claude 的对话框里敲一句:
“帮我看下今天的高危告警,重点看那台 k3s 集群。”
Claude 很聪明,但它够不着你的 SOC——它看不到你的资产库、查不了你的告警、更不知道哪台机器在 k3s 集群里。传统解法是你打开 VPN → 登系统 → 人肉复制粘贴。
另一种声音同时存在:“真把 SOC 暴露给 AI Agent?你敢吗?” 模型会幻觉、会误操作、Prompt 会被注入——10 篇测过 5 条注入样本,11 篇讲了一整篇"LLM 干不了坏事的路径压根不存在"。
这一篇就是这两个问题的合答案:MCP(Model Context Protocol)让 Claude 能操作你的 SOC,而治理设计让你敢让它操作。
核心主张一句话:
给 Agent 最小职权,而不是最大能力。
全景:一张图看懂 Agent 怎么够到 SOC
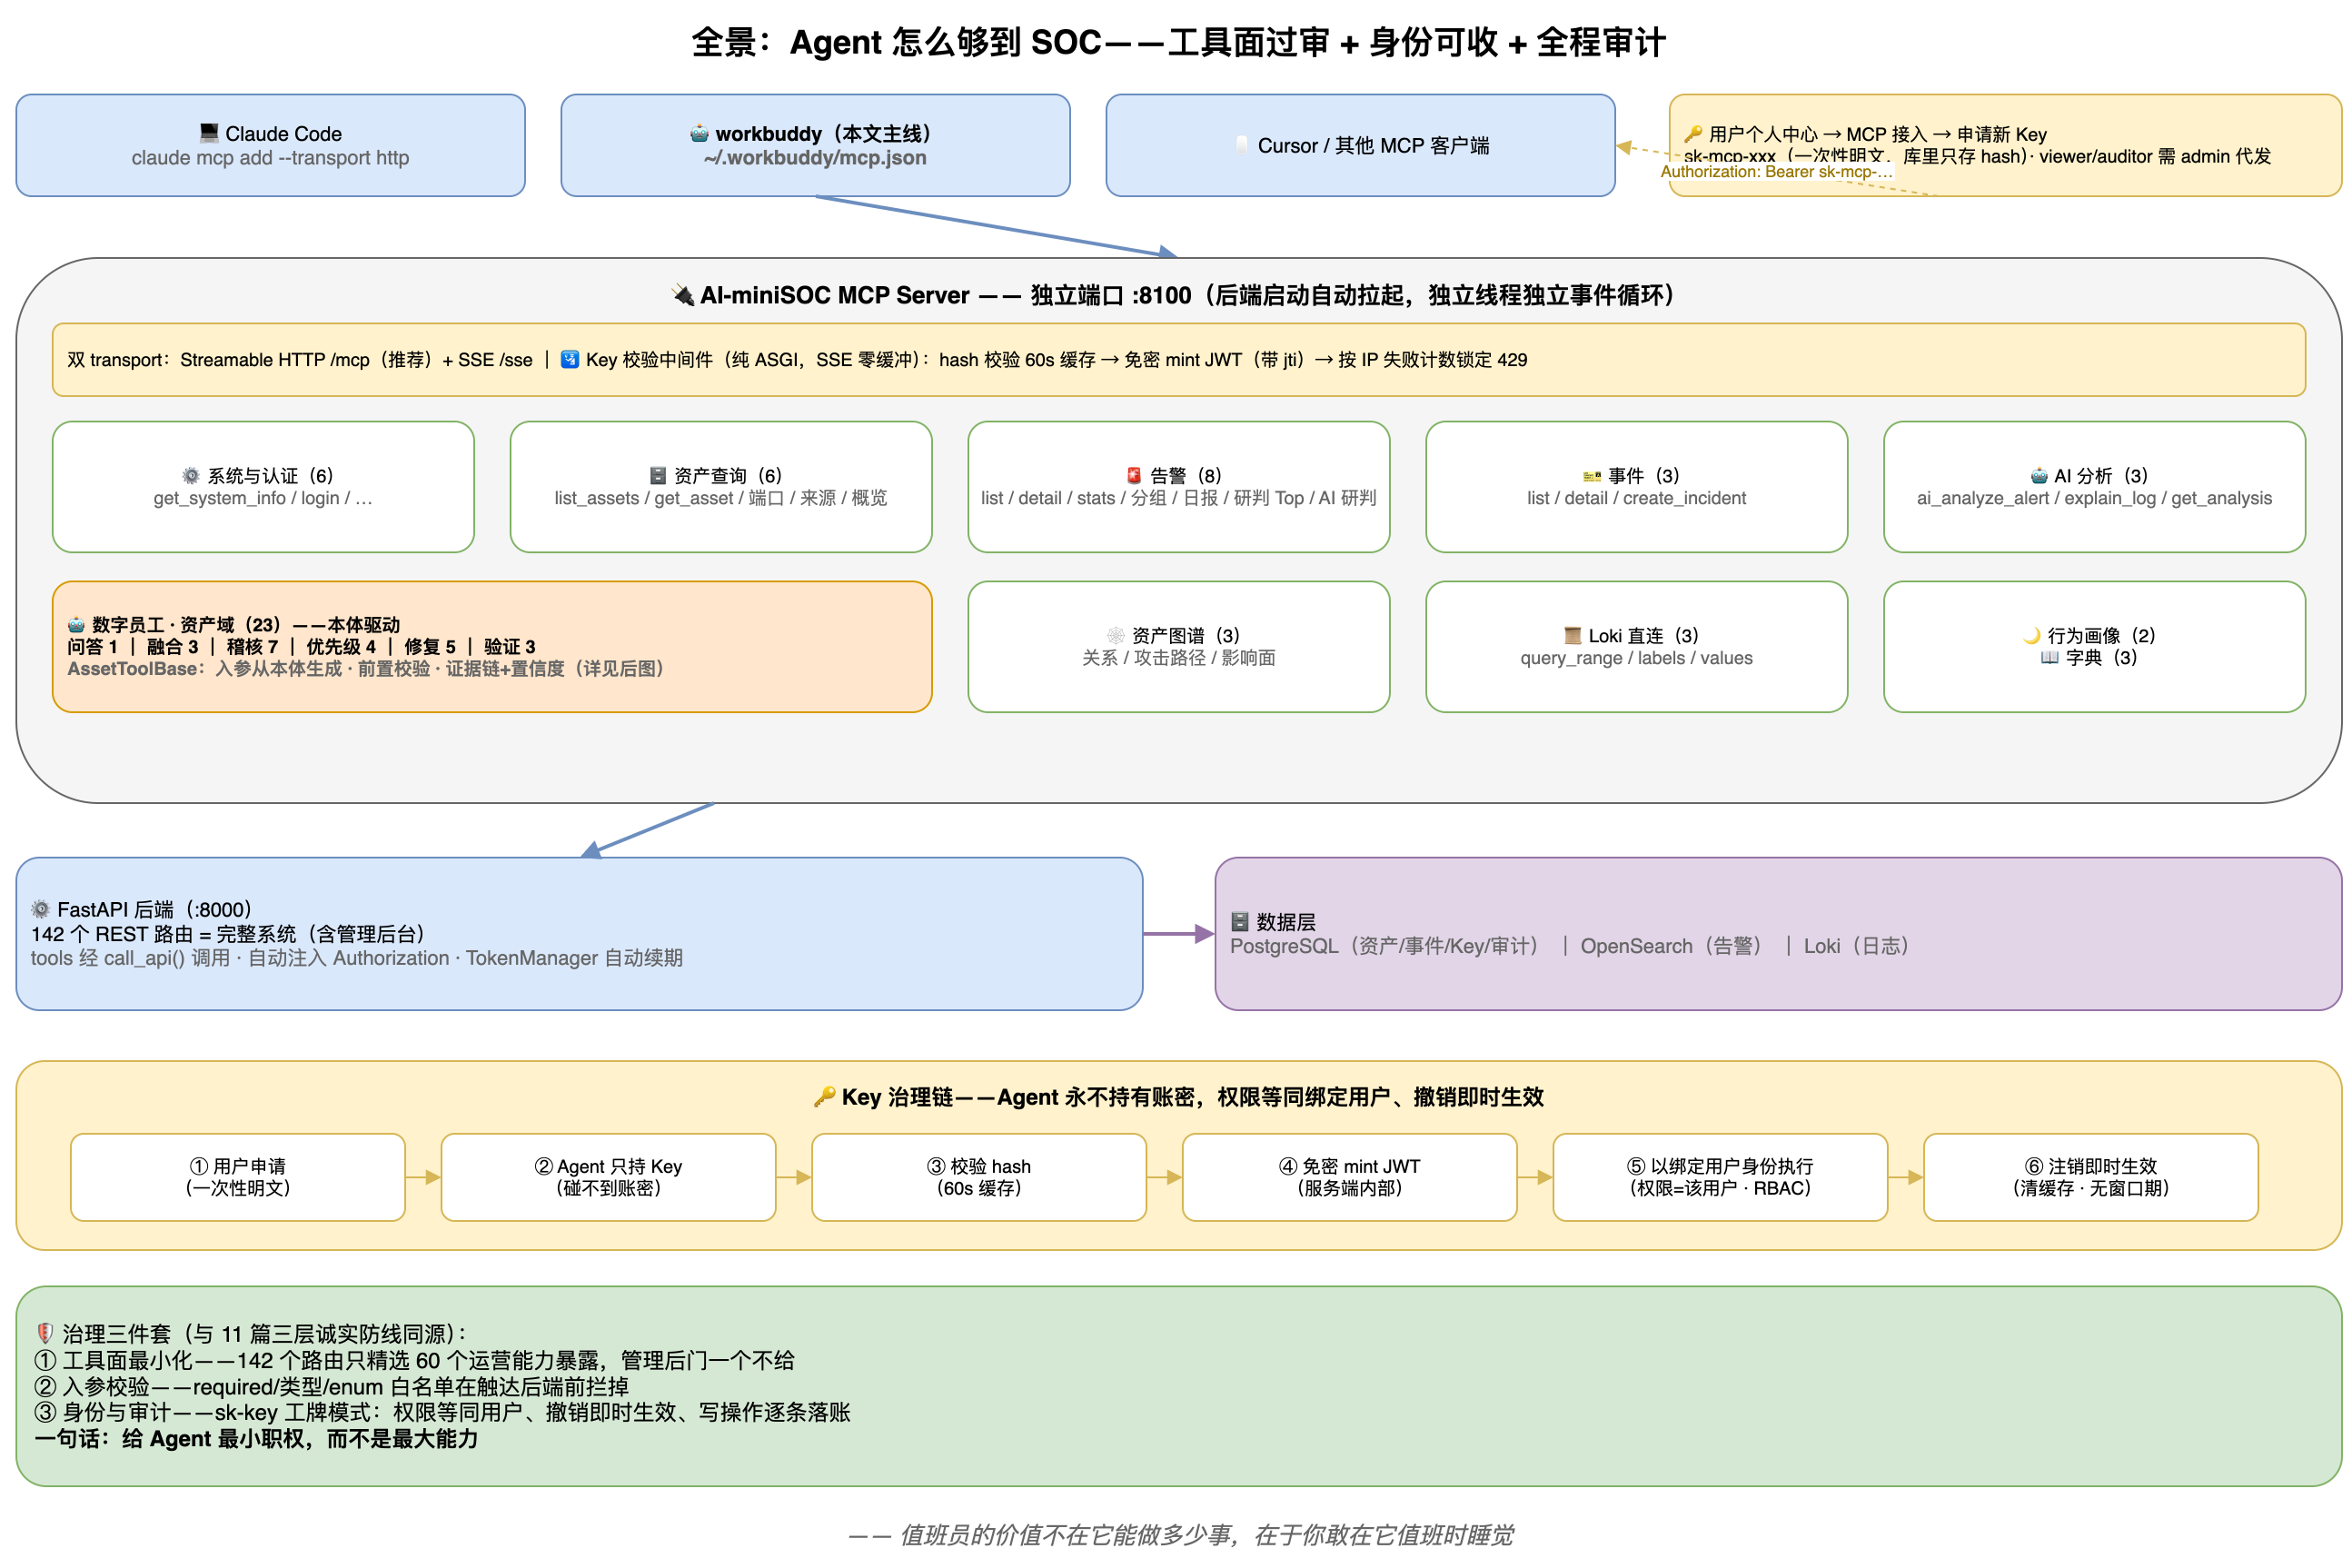
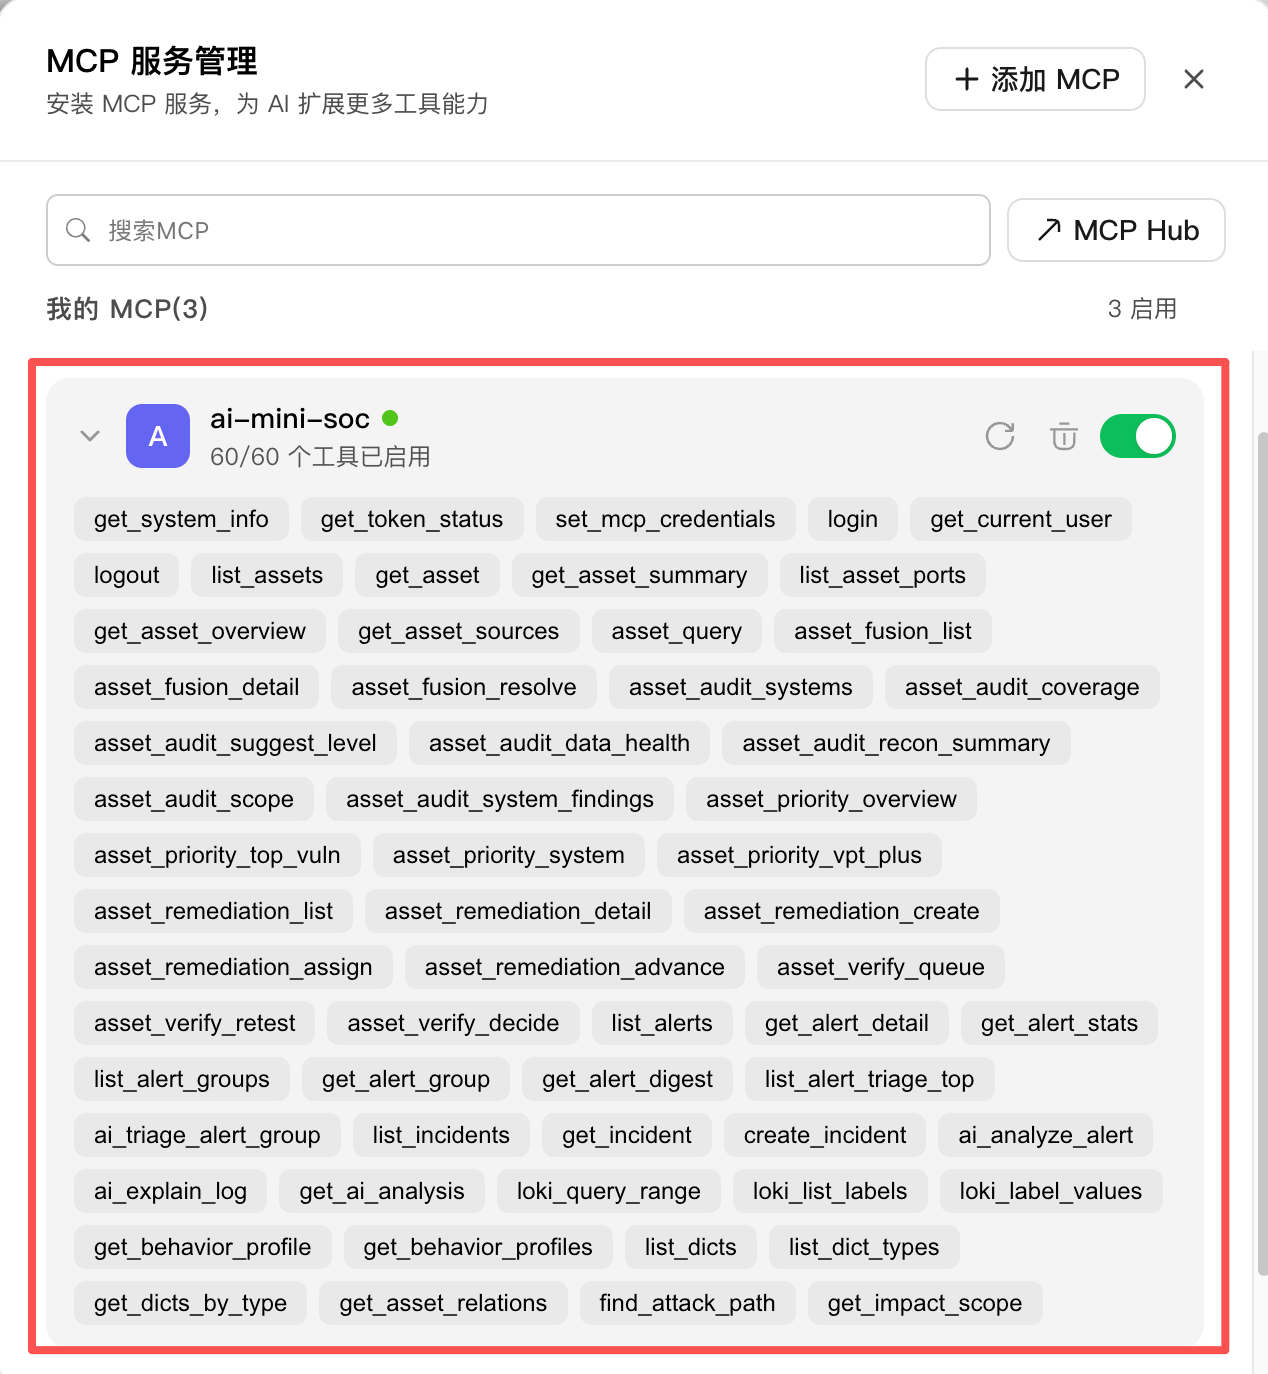
链路很朴素:SOC 后端把能力包装成 MCP Server(独立端口 8100,Streamable HTTP + SSE 双 transport),Claude Code、Cursor、workbuddy 等任何 MCP 客户端连上来,就能像调用本地函数一样调用 SOC 的 60 个工具。
但这条链上真正值钱的不是"通",是三个设计决策——工具面怎么定(下节)、工具怎么写(数字员工节)、身份怎么管(Key 治理节)。
决策一:砍掉自动生成,60 个手写 tool 背后
先讲一段决策史,这是本篇最想讲的部分。
最初的做法是业界常见的"B 路线":用 fastapi-mcp 从 OpenAPI 自动把全部 142 个 REST 路由生成 MCP tools——听起来很美,零手写成本,API 加一个 tool 自动多一个。
2026-08-08,整个 B 路线被砍掉,全部改为手写(“C 路线”)。源码注释里留着五条理由,每条都值得细品:
理由一:Agent 实际只用 7 个。 142 个路由自动生成 23 个 tool 后发现,Agent 真正调用的只有 7 个(资产/字典相关)——剩下全是用户管理、角色管理、菜单管理、审计日志这类后台管理操作。对一个安全运营 Agent 来说,这些不是能力,是无谓的攻击面。
工具面 = 攻击面。暴露给 Agent 的每一个能力,都要像对外开放端口一样过审。
这是全篇最重要的一句话。市面教程教你怎么把全部 API 一股脑喂给 Agent,本篇的答案是反过来:先问 Agent 需要什么,再决定给它什么。
理由二:依赖脆弱。 fastapi-mcp 遇到 OpenAPI 自引用递归 schema 直接崩,升级又和 Server API 版本不兼容——最终方案是打库源码补丁 + monkey-patch。让核心链路依赖一个需要魔改第三方库才能跑的组件,不值。
理由三:上下文省 70%。 自动生成的 tool 名动辄 30+ 字符(OpenAPI 路径拼接),手写的 5-20 字符(list_alerts、get_asset)。Agent 每次连接要加载全部工具清单进上下文——60 个短名字 vs 23 个长名字,token 省约七成,长对话时这是实打实的成本和注意力。
理由四:token 全自动。 手写层内置 TokenManager,access 过期前 5 分钟自动 refresh,Agent 完全不用关心凭证续期。
理由五:写操作可控。 手写 tool 可以直连 service 层绕过前端 schema 的历史包袱,写路径完全在自己手里。
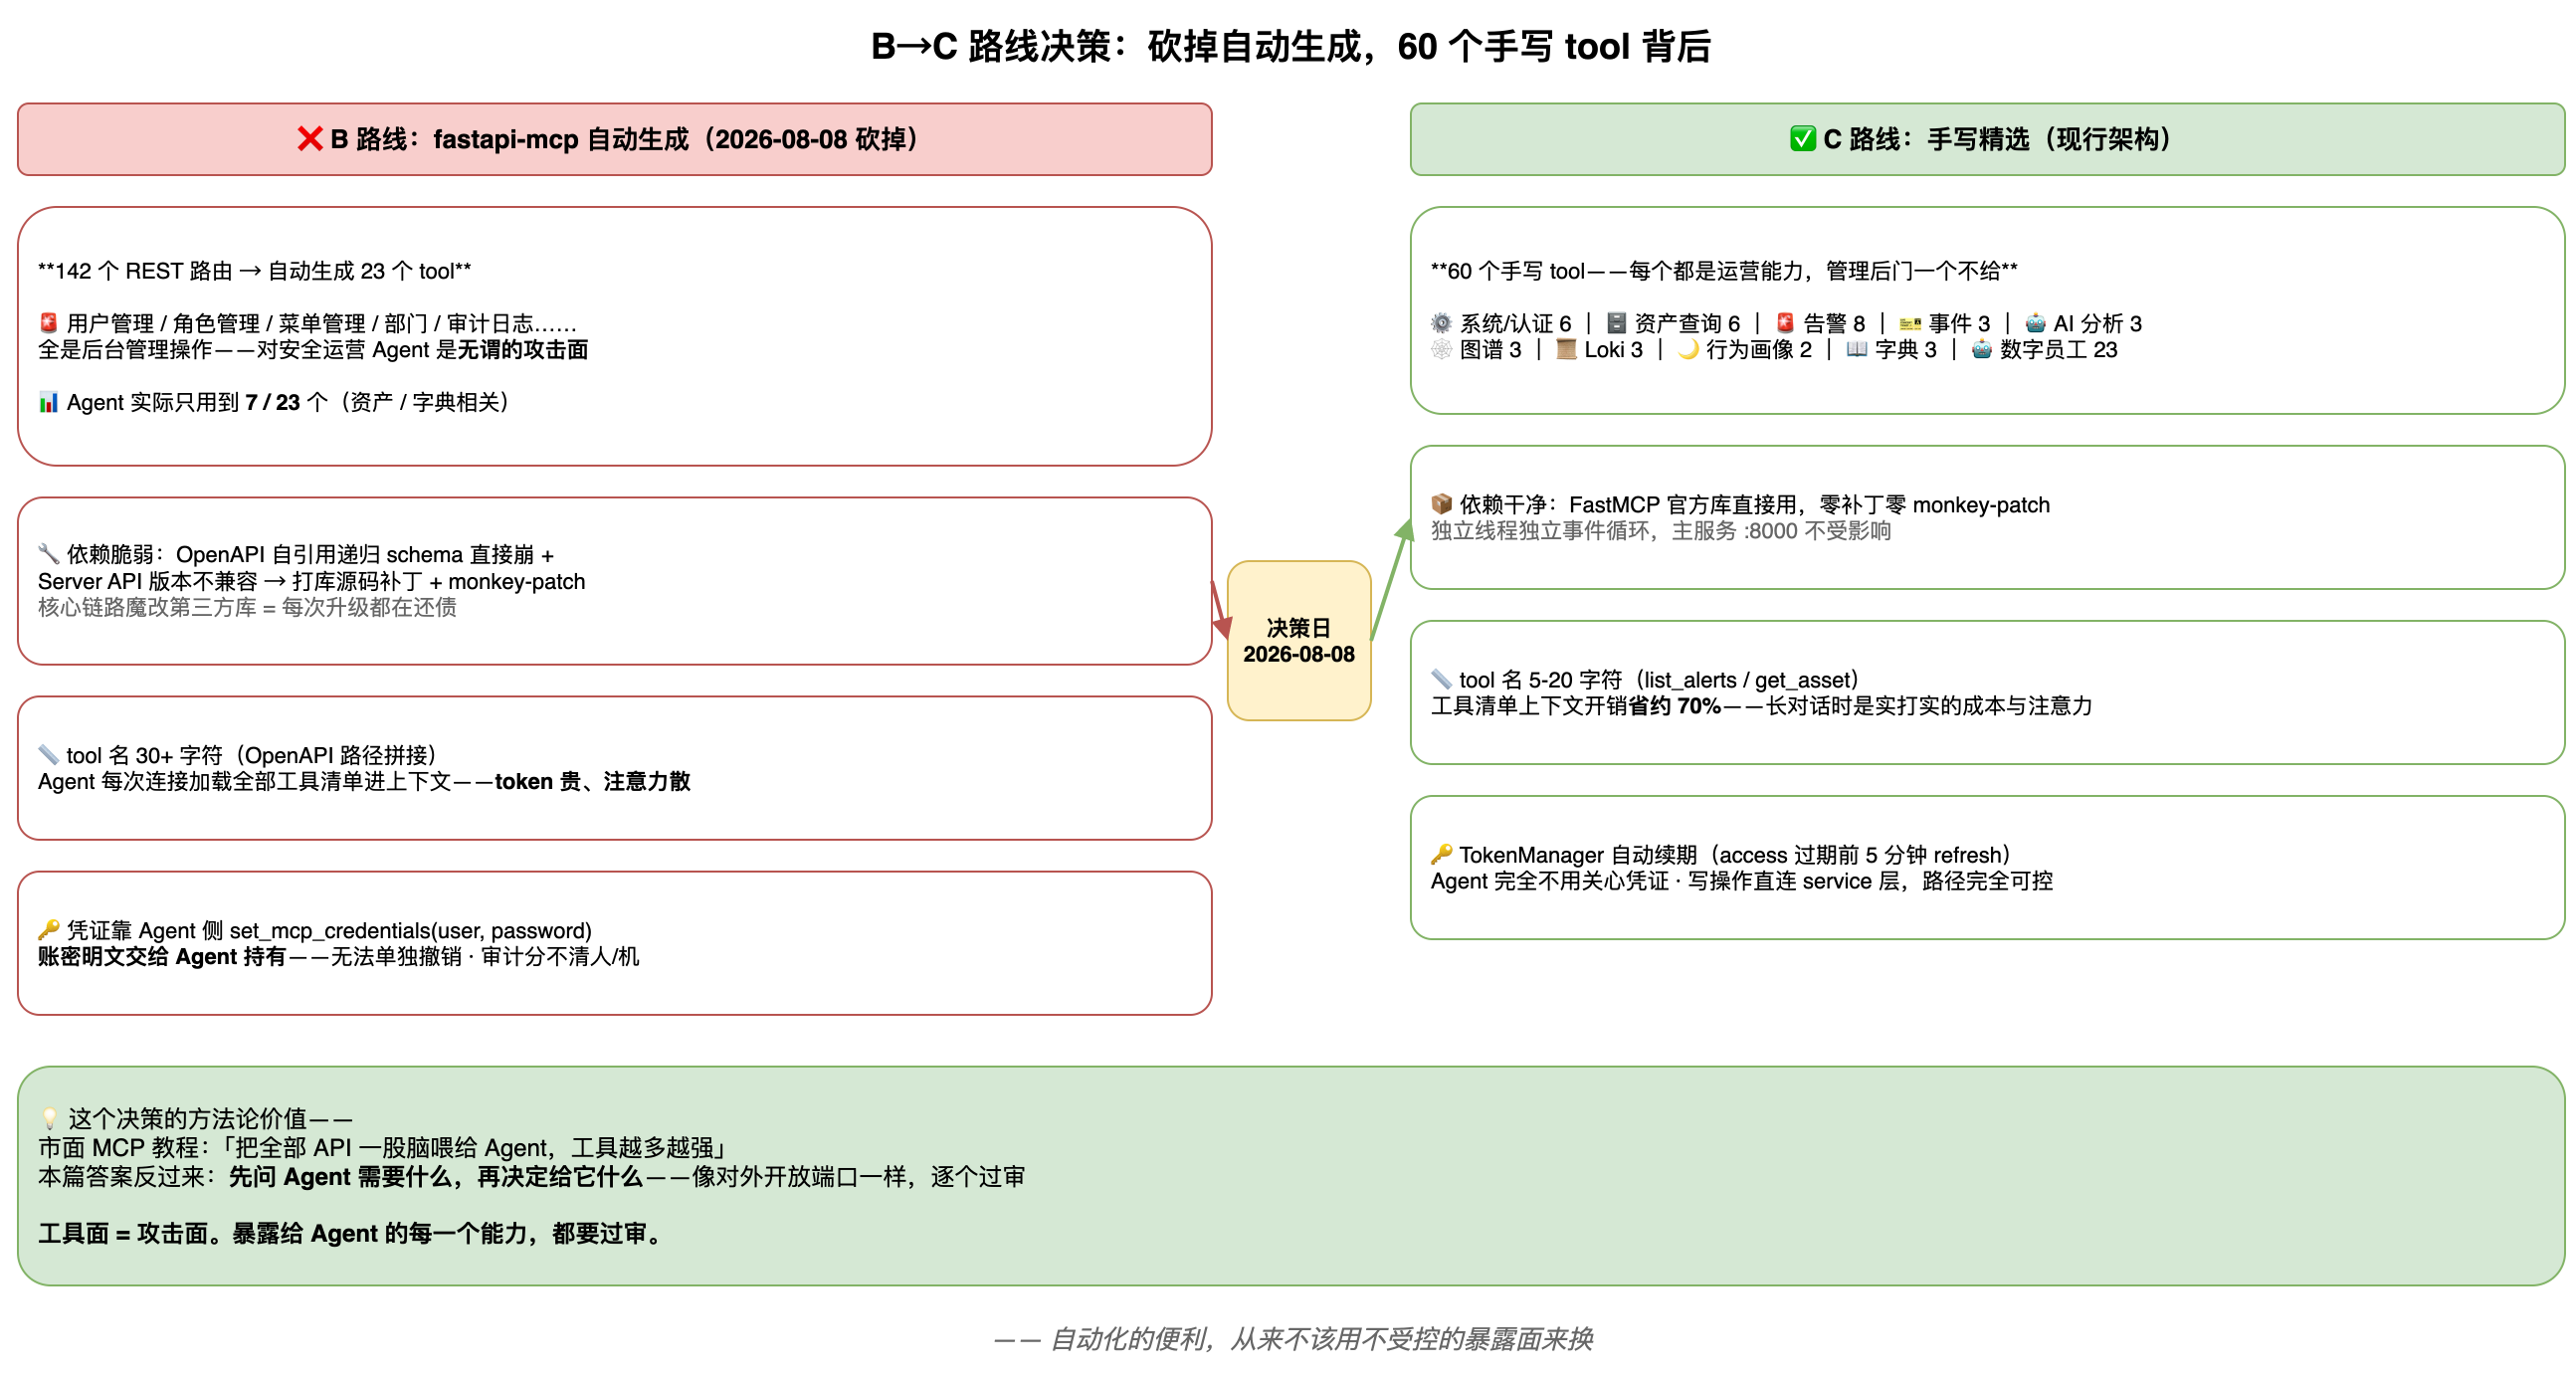
最终的 60 个工具按域组织:系统与认证(5)、资产(30:基础查询 + 端口/来源/概览 + 23 个数字员工工具)、告警(8,含 AI 研判)、事件(3,含创建)、AI 分析(3)、Loki 直连(3)、行为画像(2)、字典(3)、图谱关系(3:关系/攻击路径/影响面)。每一个都是运营动作,没有一个管理后门。
决策二:数字员工——23 个资产域工具的"本体驱动"写法
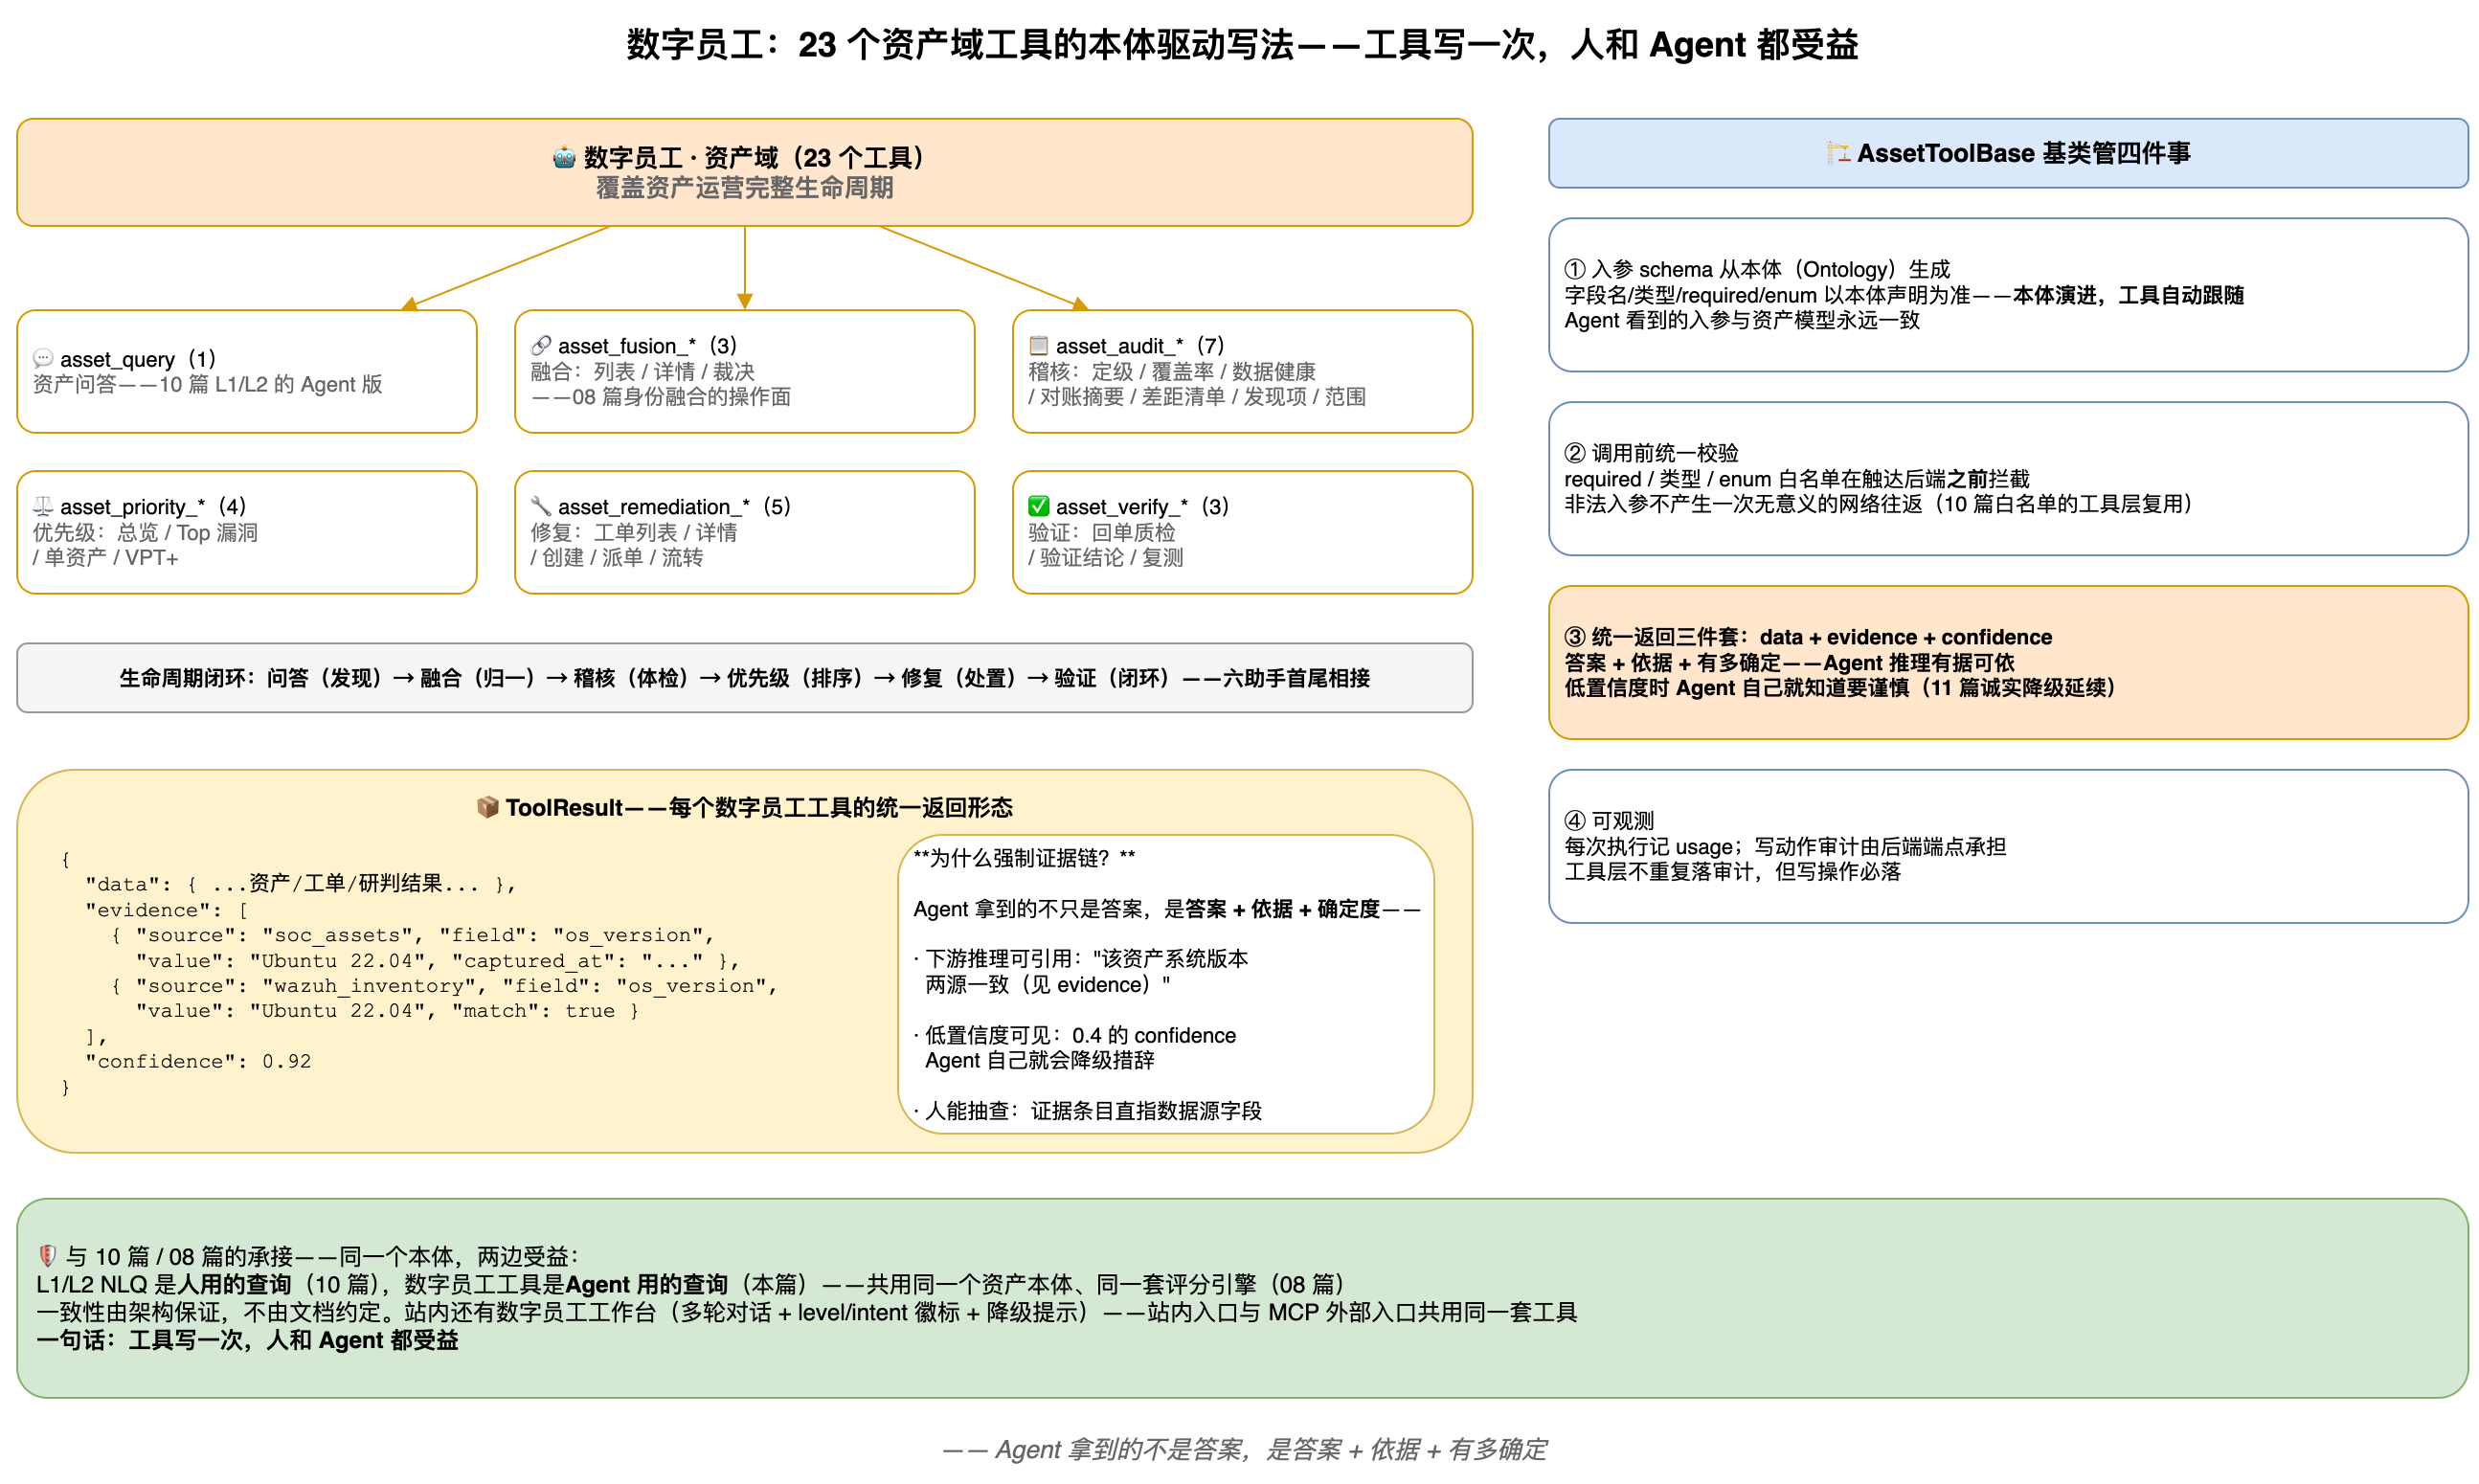
60 个工具里最年轻的一批,是资产域的 23 个"数字员工"工具(2026-09 方案落地)。它们不是简单的 API 包装,而是一套有纪律的写法。
六个助手覆盖资产运营的完整生命周期:
asset_query          资产问答(10 篇 L1/L2 的 Agent 版)
asset_fusion_*       融合助手(列表/详情/裁决)——08 篇身份融合的操作面
asset_audit_*        稽核助手(定级/覆盖率/数据健康/对账摘要/差距清单)
asset_priority_*     优先级助手(总览/Top 漏洞/单资产/VPT+)
asset_remediation_*  修复助手(工单查/建/派/流转)
asset_verify_*       验证助手(回单质检/验证结论/复测)
所有工具继承同一个基类 AssetToolBase,基类管四件事:
1. 入参 schema 从本体生成。 工具参数不是各写各的散字段,而是从资产本体(Ontology)的类声明自动生成——字段名、类型、required、enum 全部以本体为准。本体演进,工具自动跟随;Agent 看到的入参永远和系统里的资产模型一致。
2. 调用前统一校验。 required / 类型 / enum 白名单在调后端之前拦截——非法入参不产生一次无意义的网络往返。这是 10 篇"参数白名单"在工具层的复用。
3. 统一返回三件套:data + evidence + confidence。 每个工具的输出都带证据链和置信度——Agent 拿到的不只是一个答案,是答案 + 依据 + 有多确定。这让 Agent 的下游推理有据可依,也和 11 篇"降级必须可见"一脉相承:置信度低时 Agent 自己就知道要谨慎。
4. 可观测。 每次执行记 usage,写动作的审计由后端端点侧承担——工具层不重复落审计,但写操作必落。
这套设计的意义在于:10 篇的 L1/L2 是"人用的查询",这里的工具是"Agent 用的查询",两边共用同一个本体、同一套评分引擎。同一个资产模型,人看是表格,Agent 看是工具——一致性由架构保证,不由文档约定。
顺带一提:系统里还有一个站内的"数字员工工作台"页面——多轮对话、每条回答展示 level/intent 徽标、参数回显和降级提示,不把 unsupported 包装成成功答案:
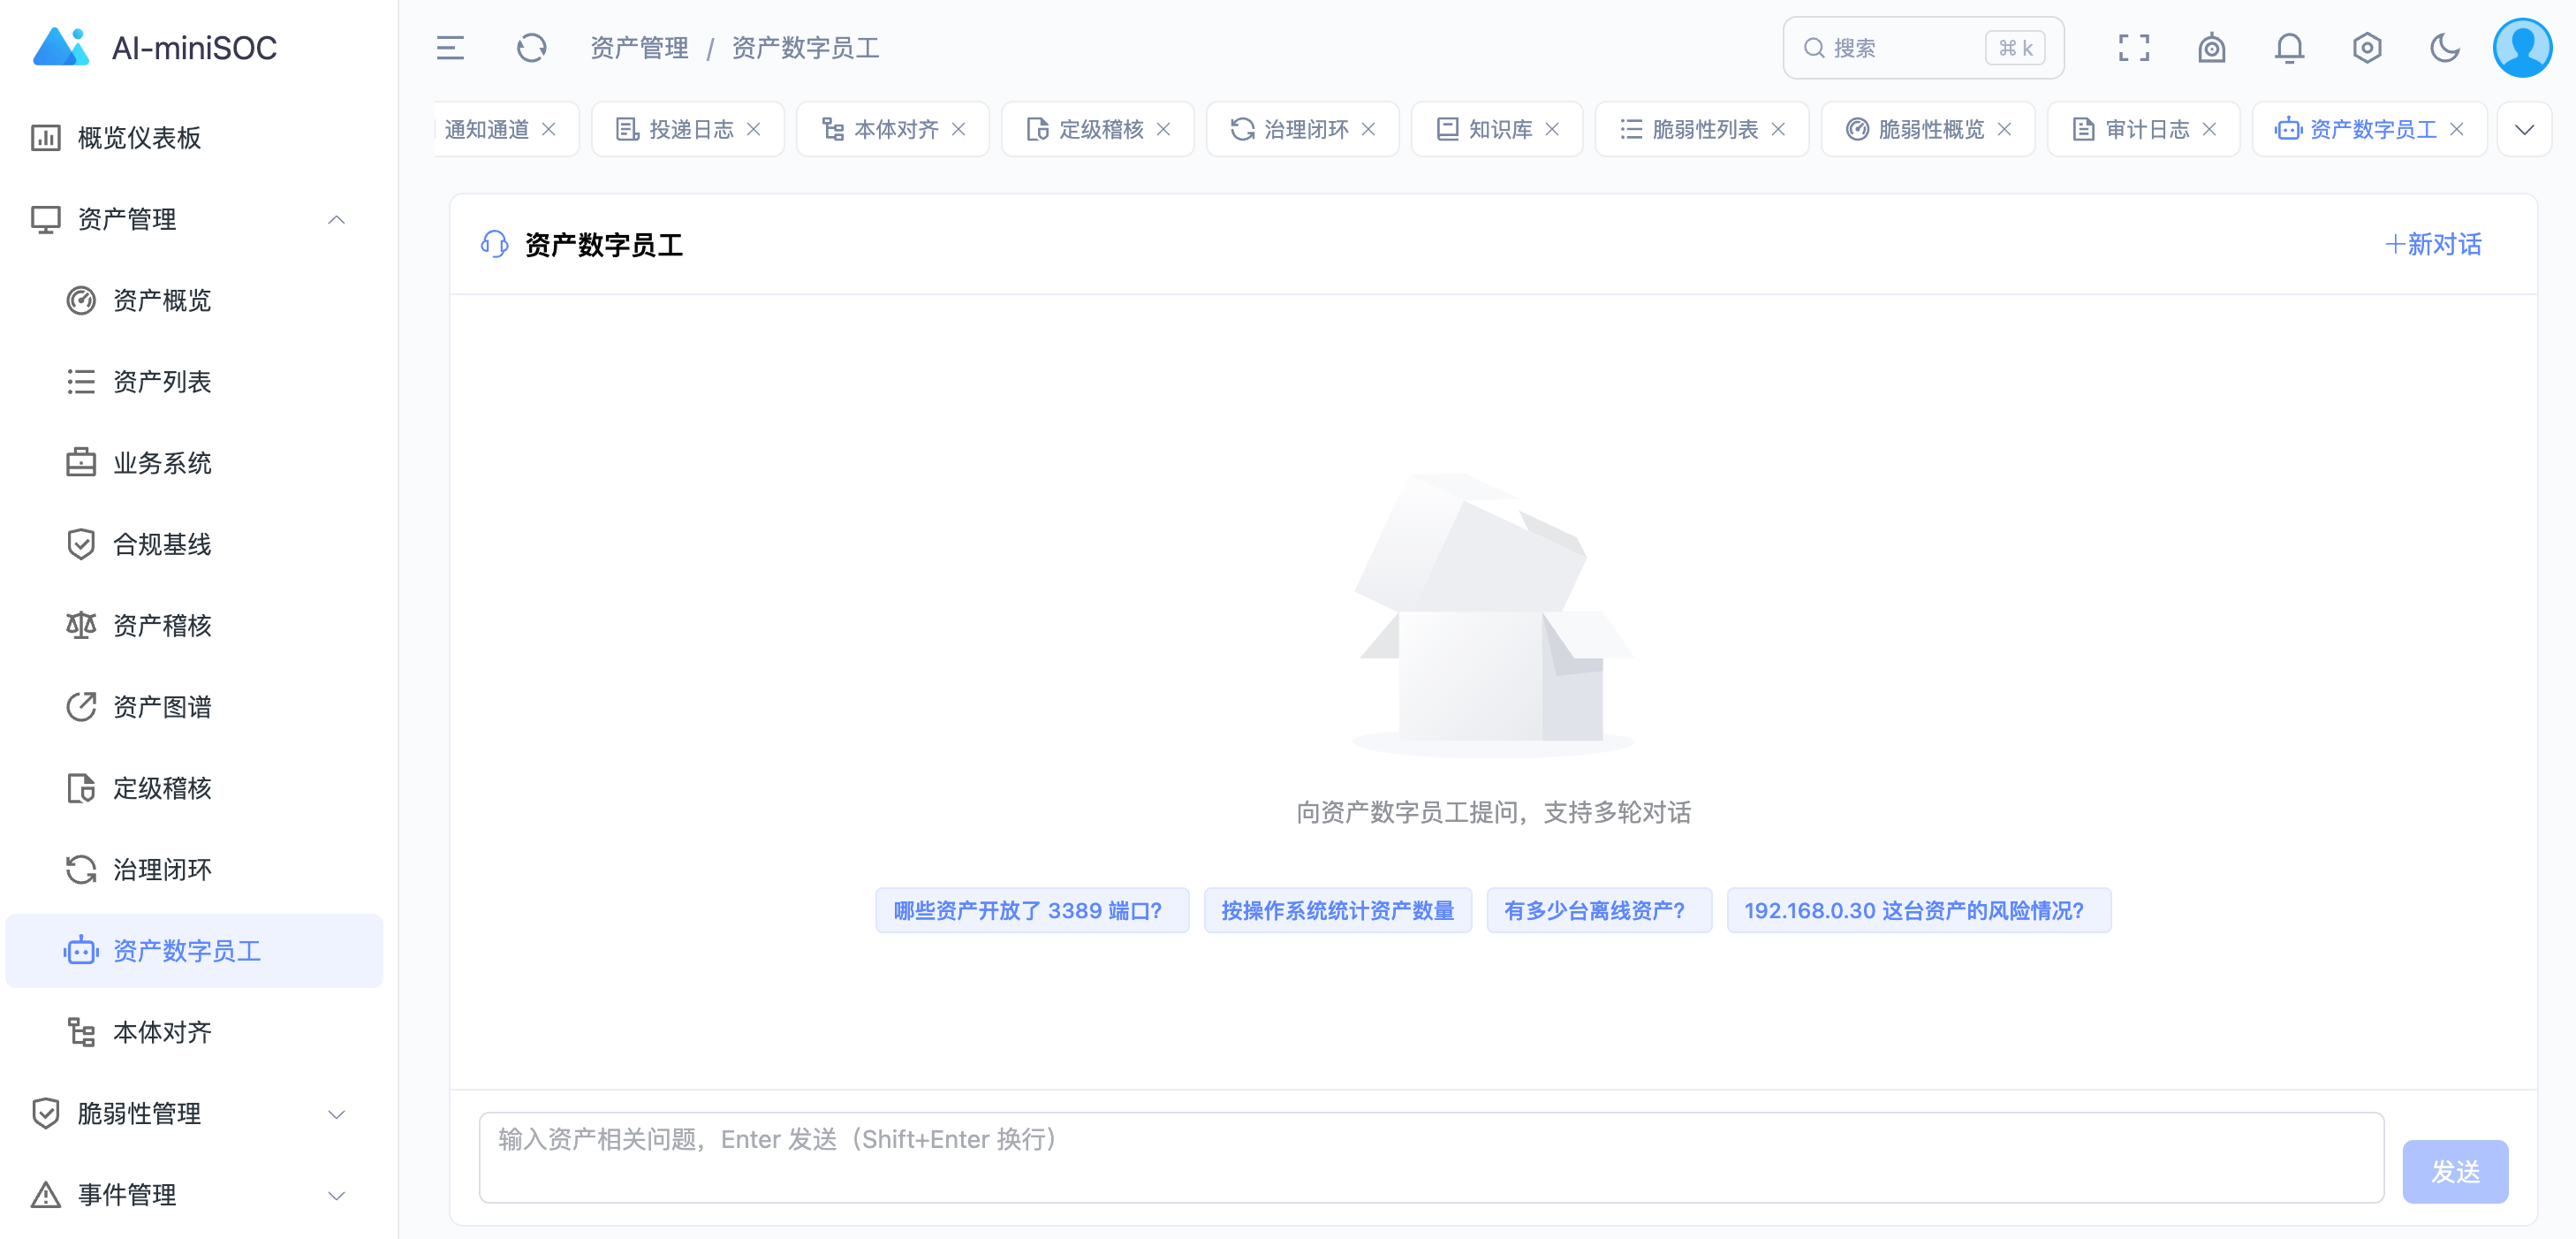
站内入口和 MCP 外部入口共用同一套工具。工具写一次,人和 Agent 都受益。
决策三:Key 治理——Agent 永远不持有你的账密
工具面定了,剩下最要命的问题:Agent 用什么身份调用?
旧方案写在 MCP 的推荐流程里:Agent 先调 set_mcp_credentials(username, password) 配置账号密码。能用,但三个问题:
- 账密明文交给 Agent 侧持有——密码躺在 Agent 的配置文件里
- 无法单独撤销——总不能因为撤 Agent 的权限就改自己密码
- 审计分不清人和机器——都落到同一个账号头上
新方案(2026-10 落地)把整个凭证体系重做了一遍:
第一步:用户申请 Key。 登录前端 → 个人中心 → MCP 接入 Tab → 申请新 Key(名称 + 有效期 7/30/90/365 天)。系统返回一次性明文 sk-mcp-xxx——关掉弹窗就再也看不到了(库里只存 hash)。设计细节:viewer/auditor 角色不能自助申请,需 admin 在用户管理页代发——权限继承角色原则,低权限角色的 Agent 权限也低。
实际界面。个人中心的「MCP 接入」Tab——已申请的 Key 列表带状态(启用/过期)、最后使用时间、有效期倒计时,每行可独立注销:
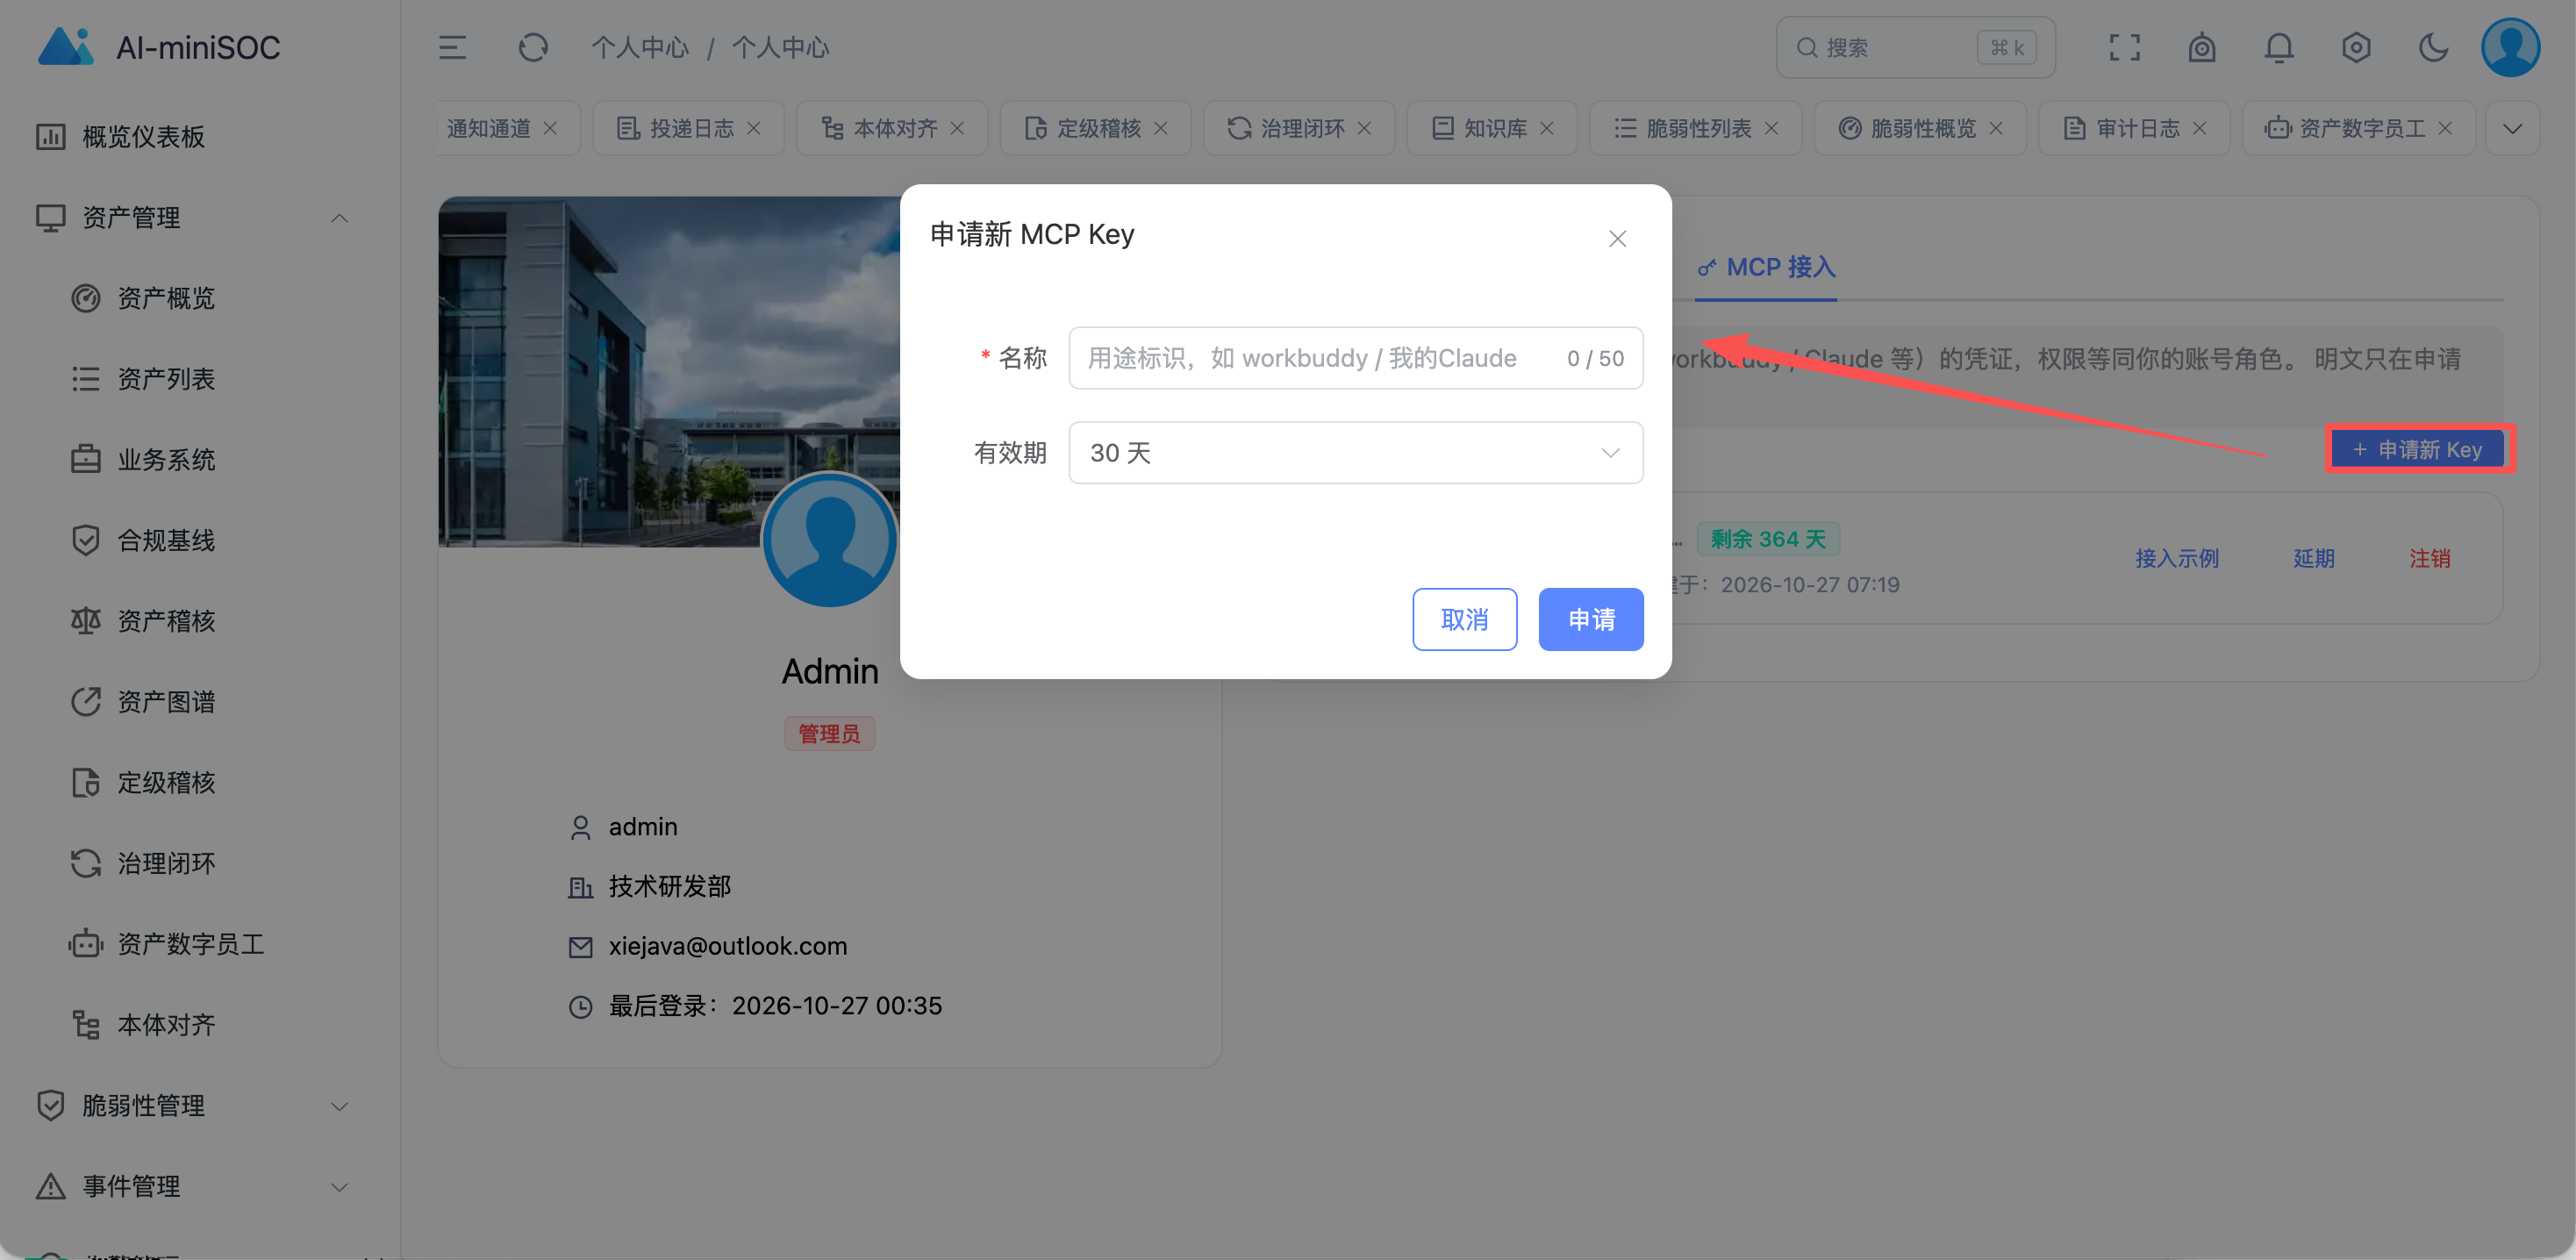
申请新 Key 的弹窗——名称 + 有效期(7/30/90/365 天)二选一填,提交后明文只展示这一次:
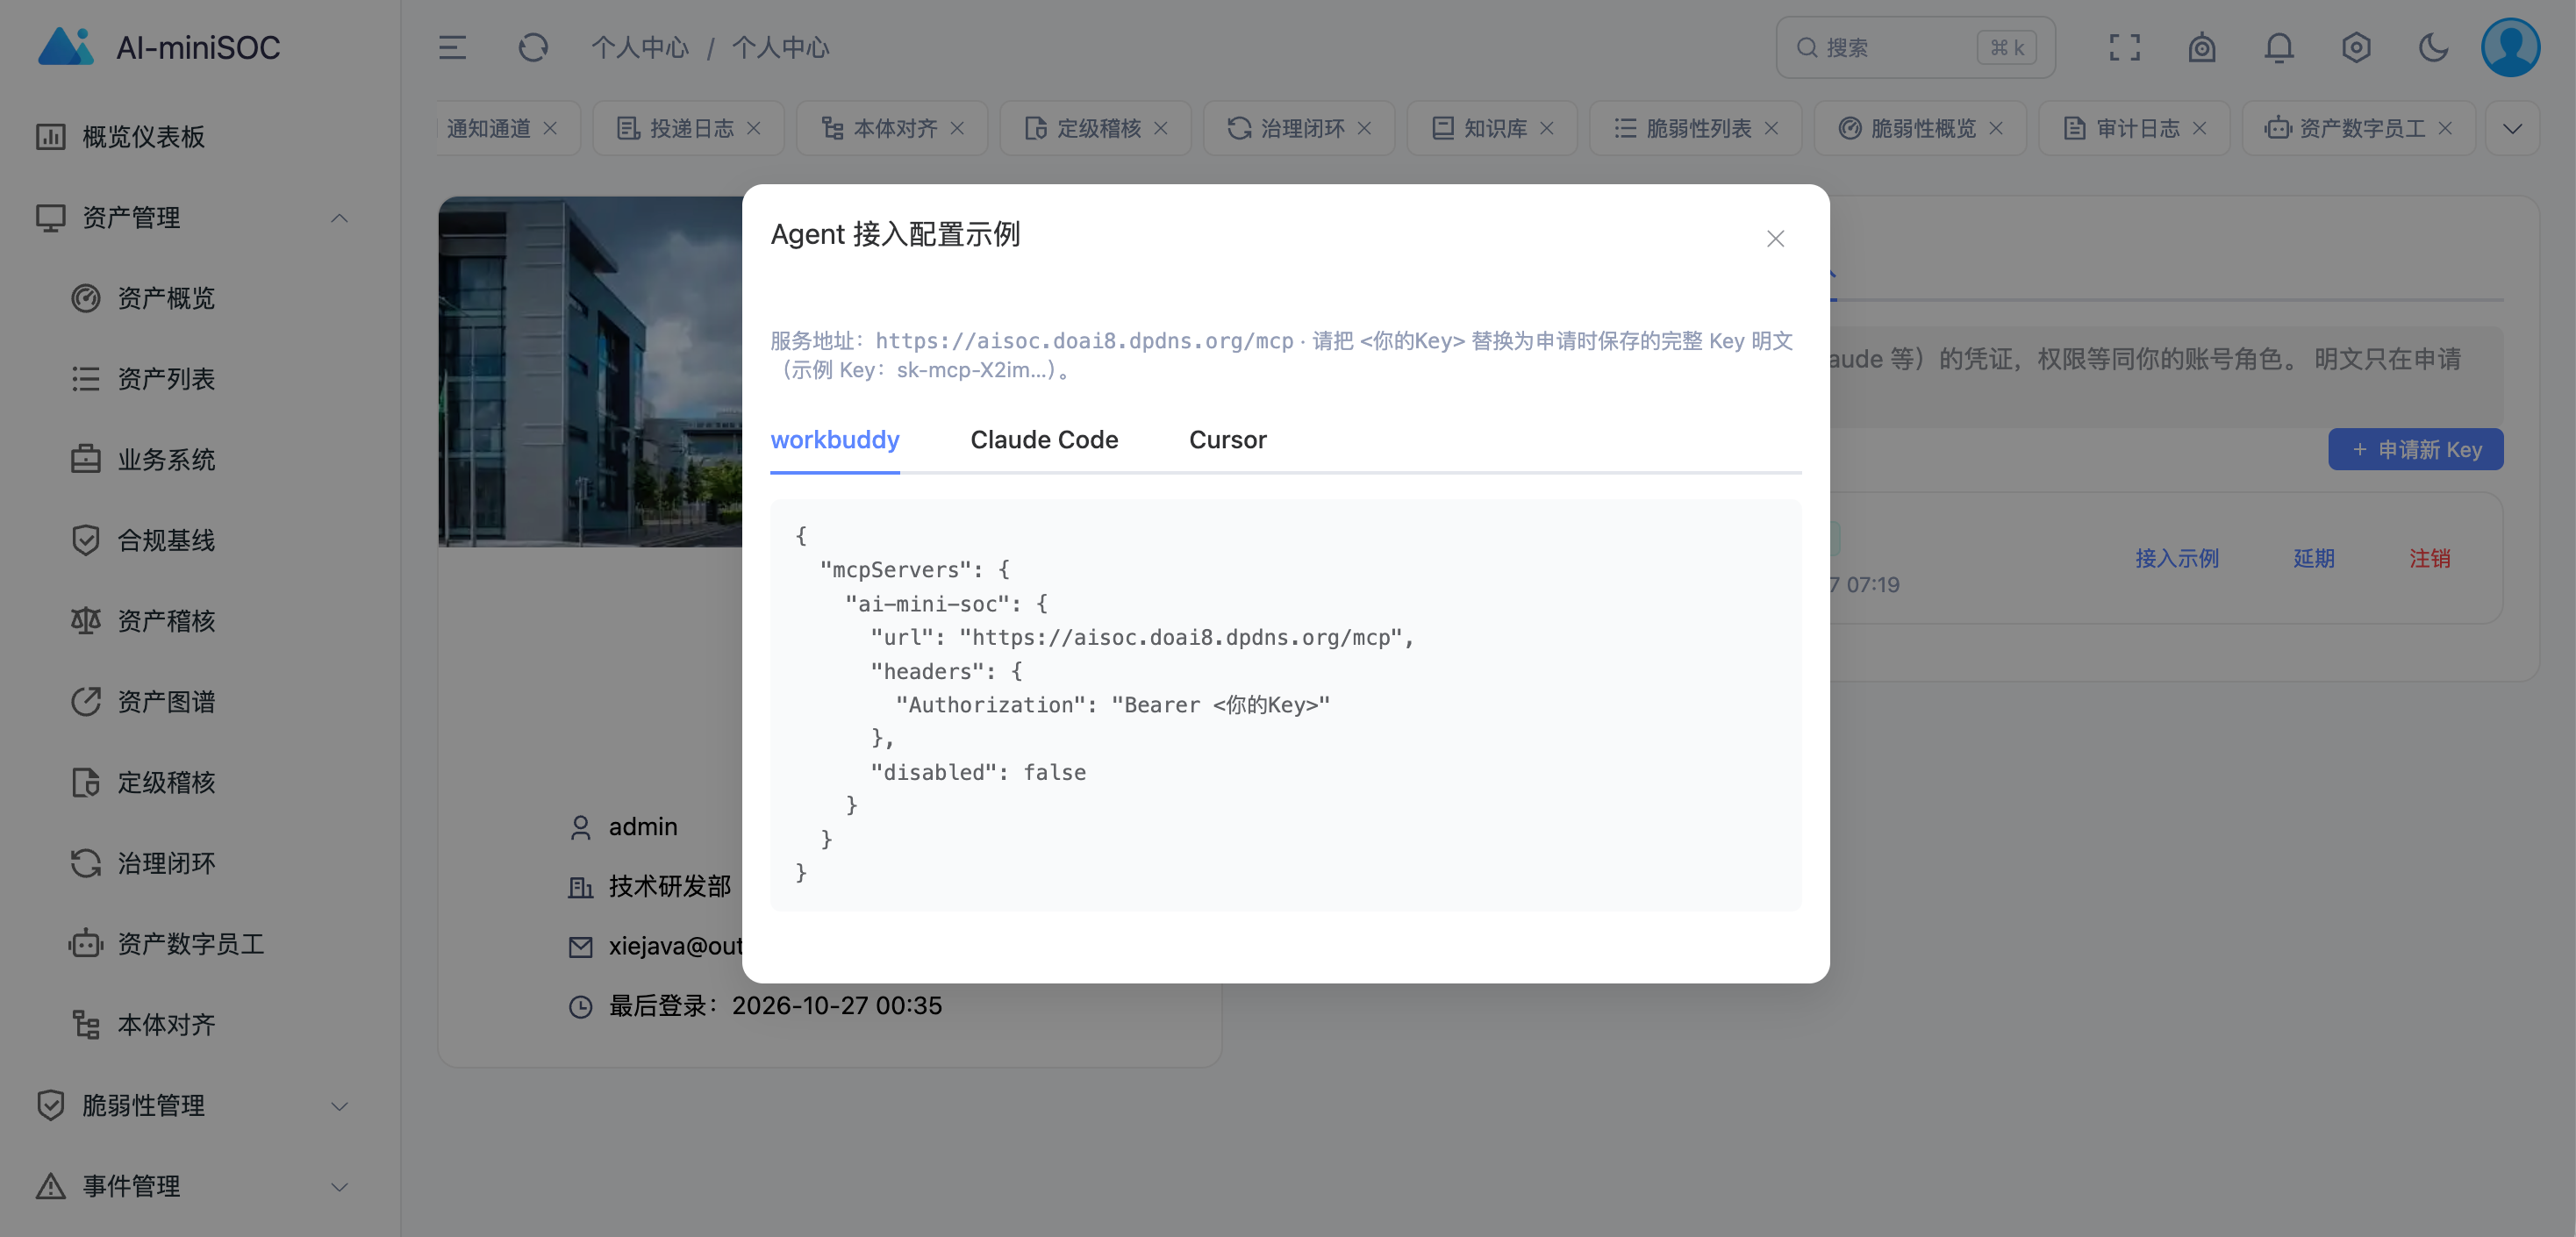
第二步:Agent 带 Key 连接。 workbuddy 的配置(~/.workbuddy/mcp.json):
| |
第三步:服务端免密签发 JWT。 这是整个设计最漂亮的一跳——Key 校验中间件验过 sk-mcp-xxx 后,以 Key 绑定用户的身份直接 mint 一个 JWT,注入后续所有工具调用:
sk-mcp-key(Agent 持有,可撤销)
   ↓ 校验(hash 比对,60s 缓存)
绑定用户身份 → 服务端免密 mint JWT(自动带 jti)
   ↓
Agent 的每个工具调用都以该用户身份执行——权限完全等同该用户
于是:Agent 全程只持有 Key,永远碰不到账号密码;Key 泄了单独撤销这一个 Key;审计日志里人和 Agent 各自清清楚楚;权限不用另建一套,直接复用 15 篇将讲的 RBAC——给 Agent 发 Key,就是给它发了一张"权限和你一样但可随时没收"的工牌。
配套的防爆破:按客户端 IP 连续失败计数,超阈值锁定返回 429(与登录失败计数按 username 维度独立)。Key 注销即时生效——每个请求都过校验中间件,注销时同步清缓存,下一个请求立即 401,无窗口期。
动手:五分钟把 SOC 接进 workbuddy
以 workbuddy 为例(Claude Code / Cursor 同理,配置见项目 README):
1. 申请 Key(如上节)。名称填 “workbuddy”,有效期按需。
2. 写配置。把上面的 mcp.json 填好 host 和 Key。
3. 验证三连。连接后让 Agent 依次调:
get_system_info→ 拿到 SOC 元信息(版本、数据规模)get_current_user→ 验证身份就是 Key 绑定用户——这一步别跳过,它确认整条 Key→JWT→身份链路是通的list_assets/list_alerts→ 拿到真实数据,权限边界生效
4. 真实对话。然后就可以自然语言指挥了:
“看下今天的 high 以上告警,按资产分组给我重点的。” “那台 192.168.x.x 是什么资产?有什么脆弱性?” “帮我把这个告警研判结果建成事件,标题用研判的结论。”
Agent 会自己编排工具链:list_alert_triage_top → ai_triage_alert_group → get_asset_summary → create_incident——每一步都是 60 个过审工具之一,每一步都以你的身份、在你的权限内、落你的审计。
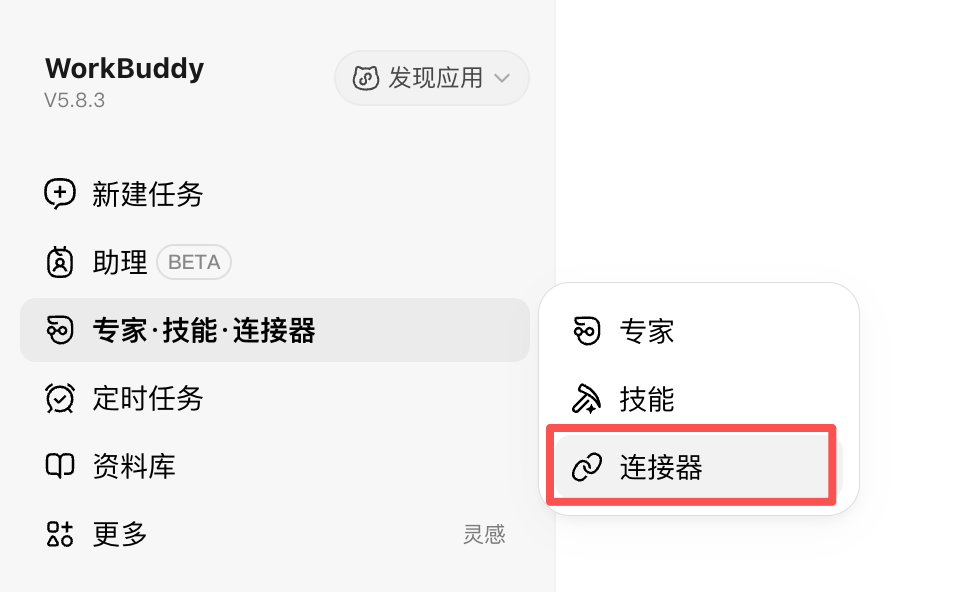
workbuddy 的实际接入过程(其他客户端同理)。入口在「专家·技能·连接器 → 连接器」:
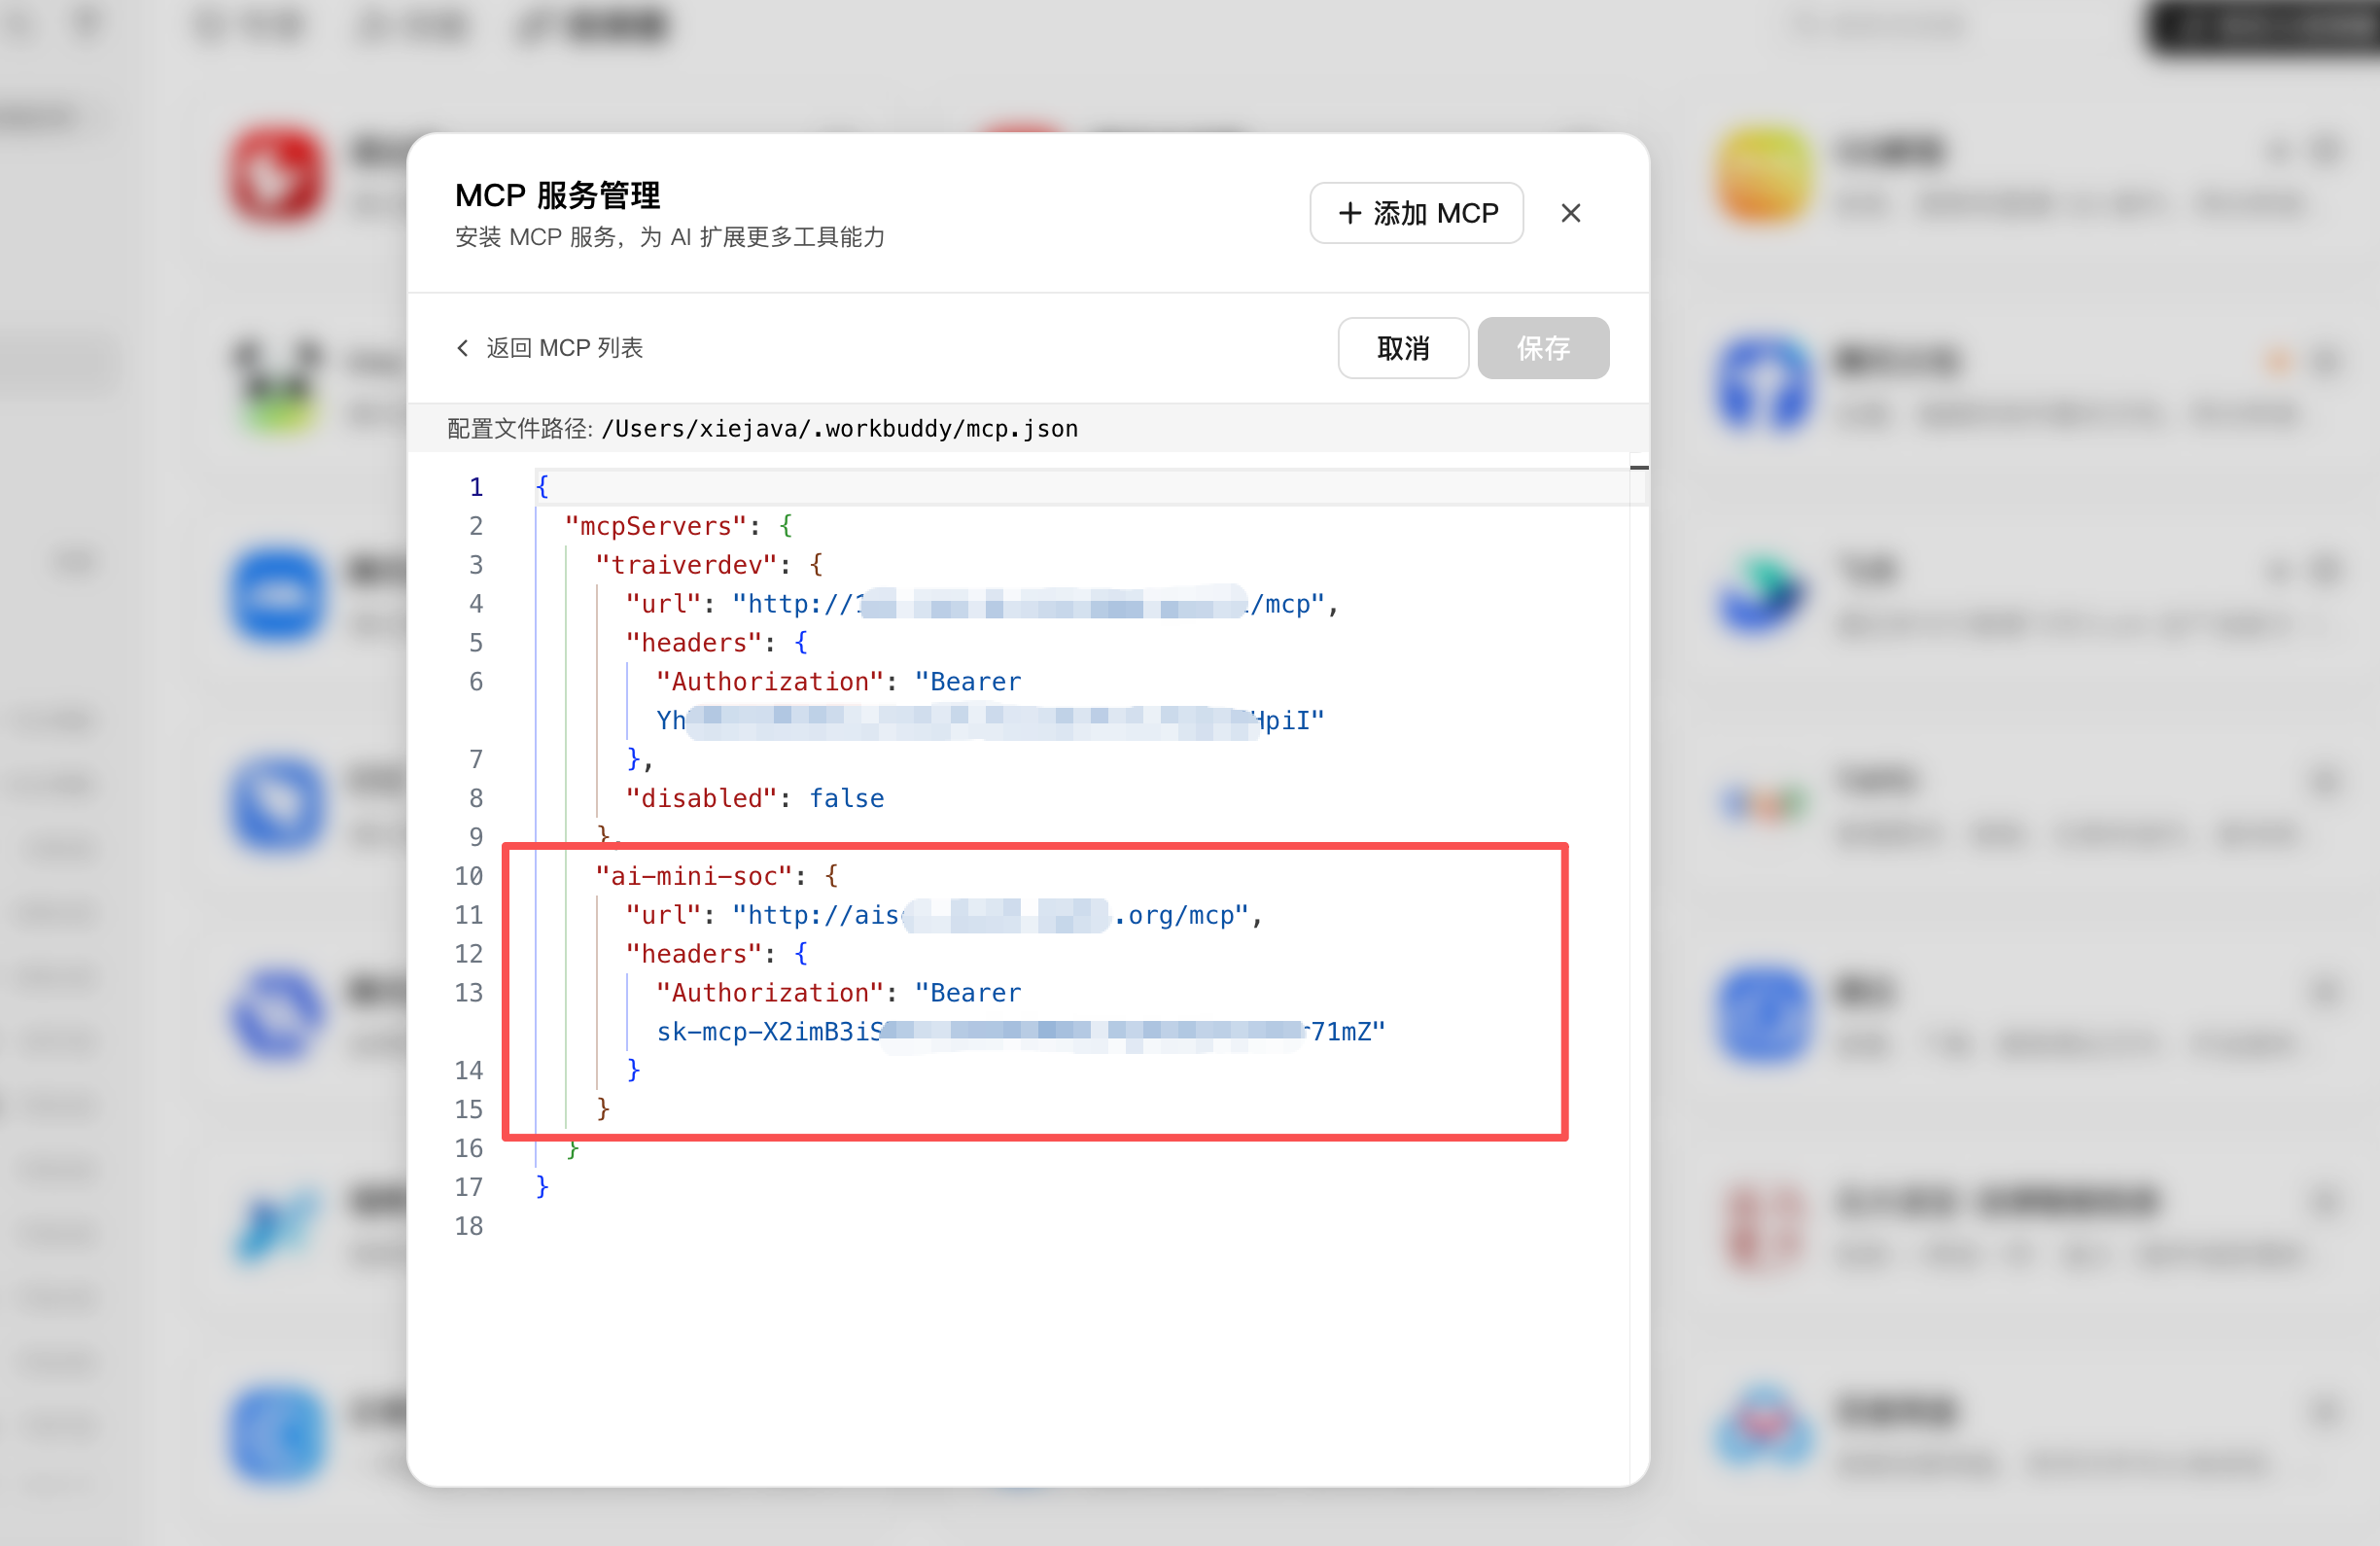
在 MCP 服务管理里添加 ai-mini-soc,配置写入 ~/.workbuddy/mcp.json——就是上文那段 JSON,URL 指向 SOC 的 8100 端口,Key 放在 Authorization 头:
保存后回到列表——ai-mini-soc 绿点在线,60/60 个工具已启用。这个数字本身就是前文 B→C 决策的验收:Agent 看到的正是那 60 个手写精选工具,一个不多一个不少:
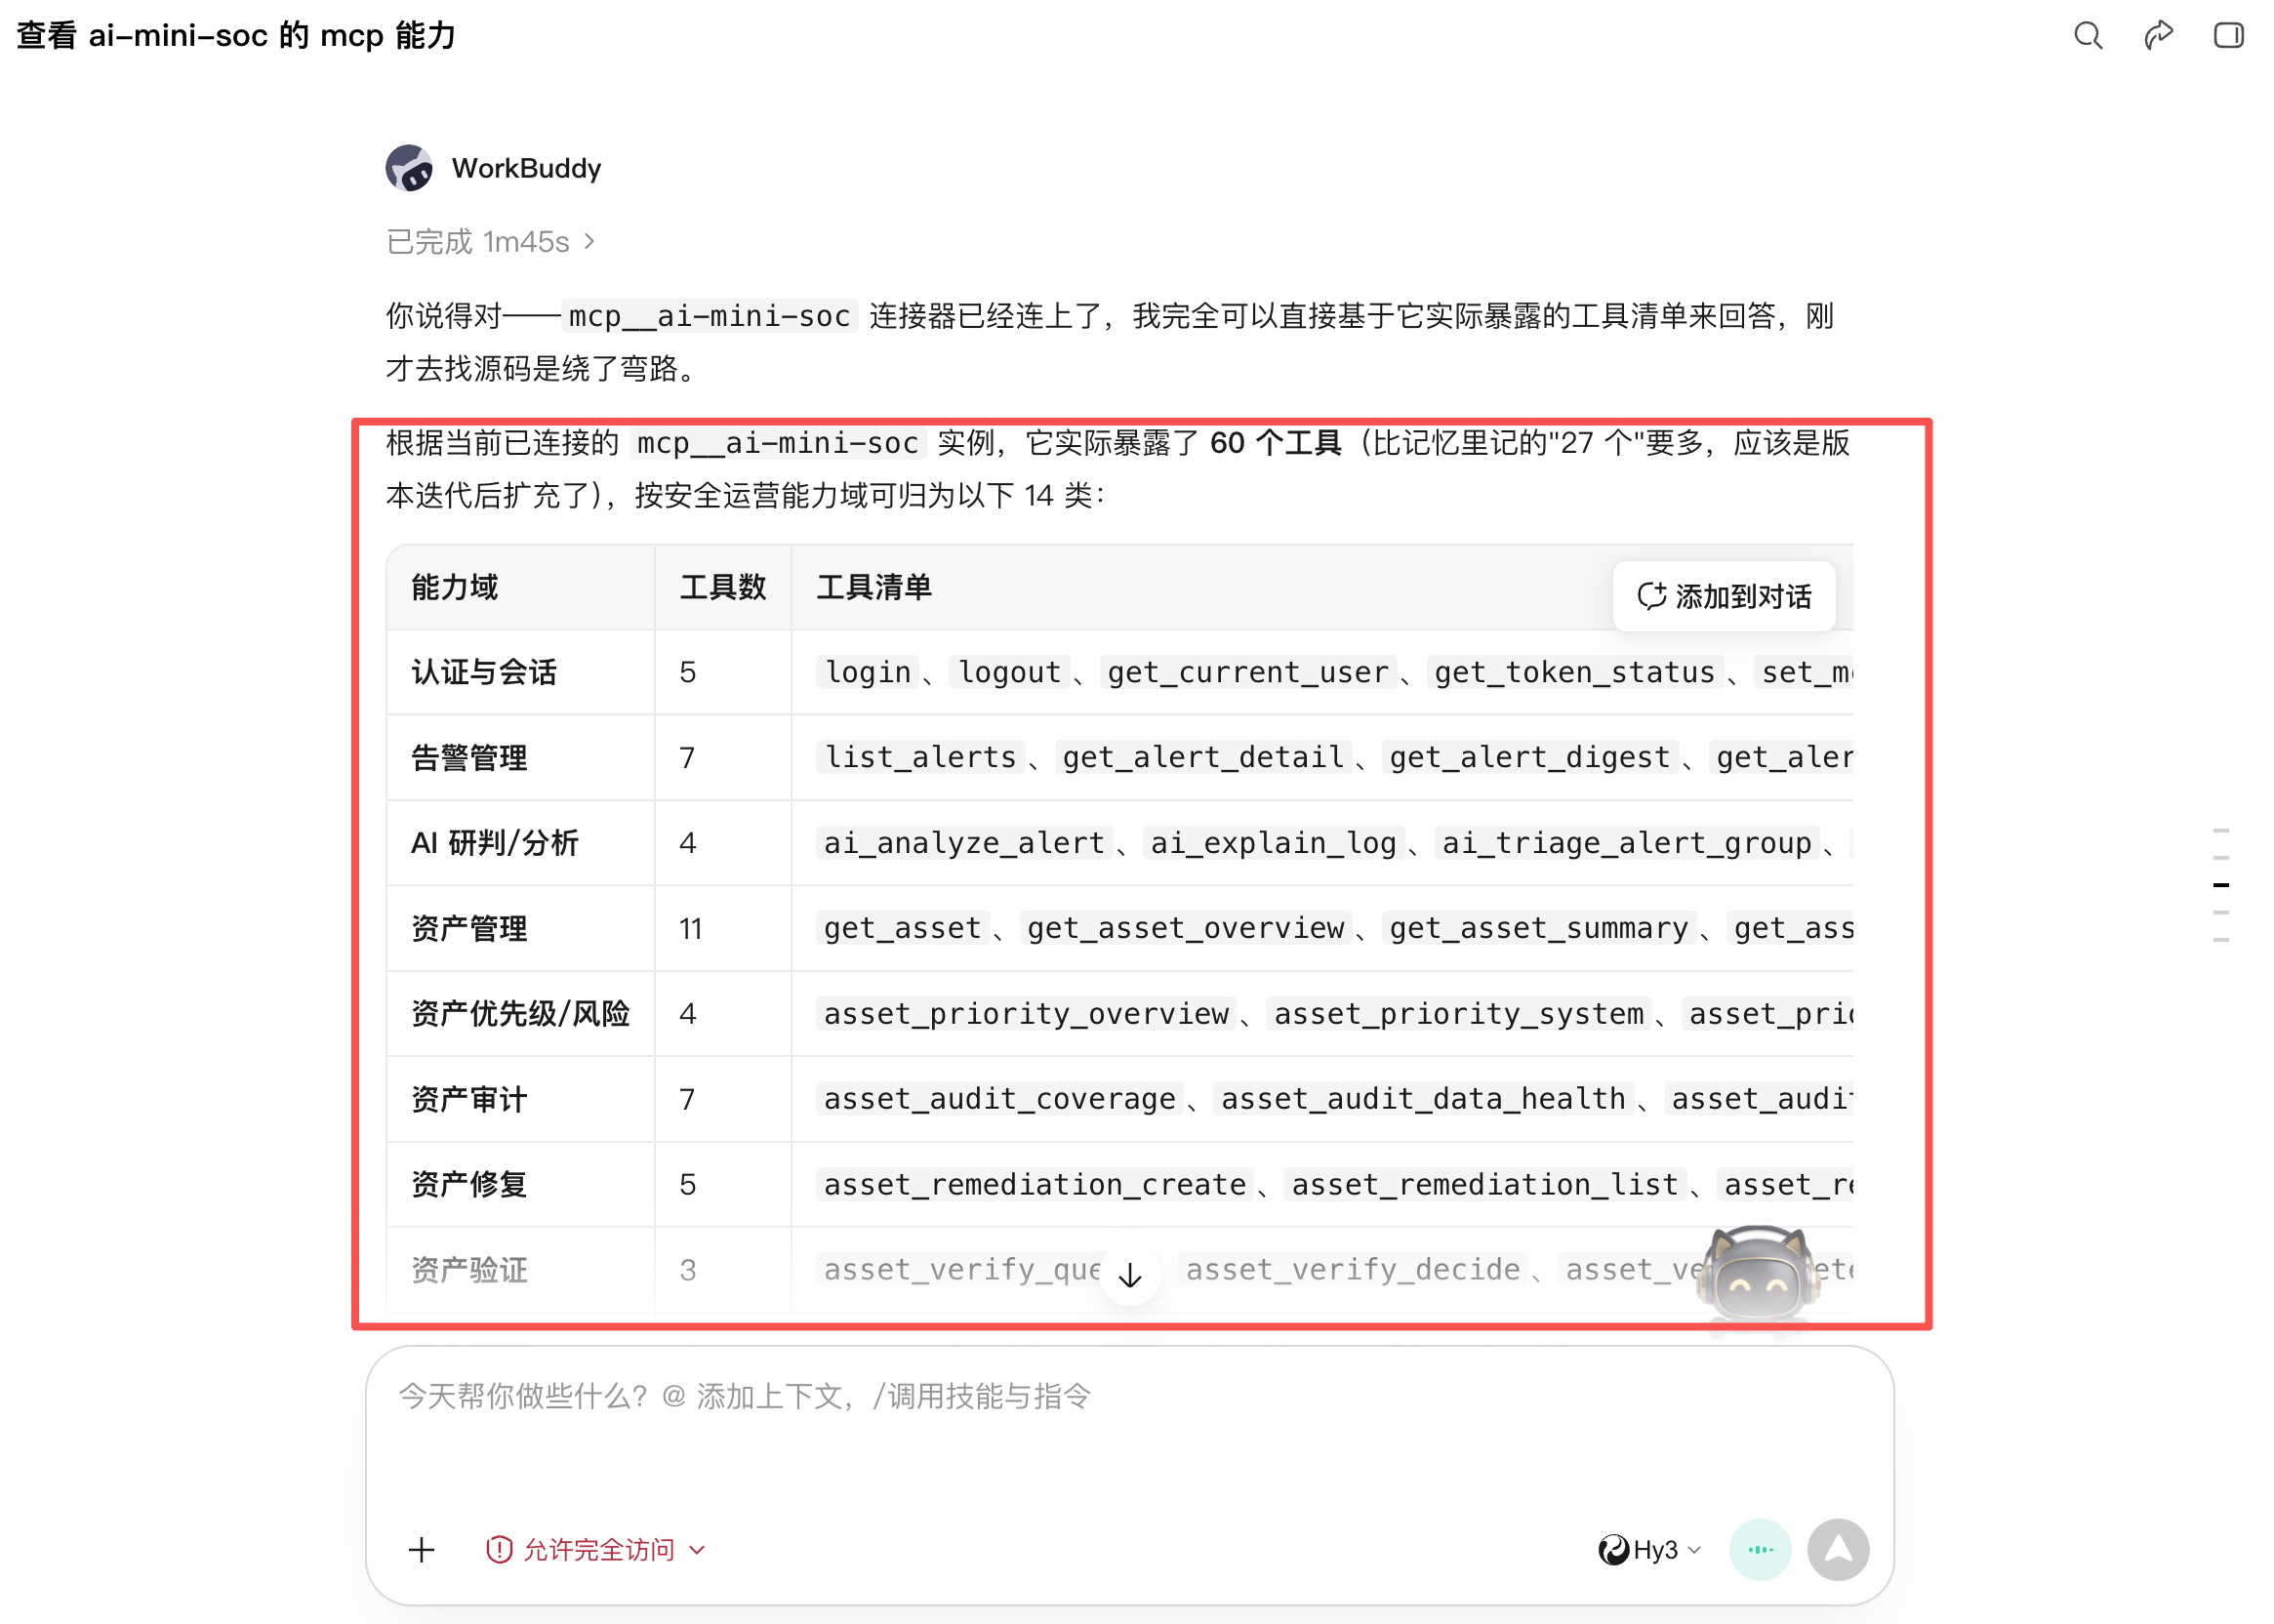
验证与实际使用。 先让 Agent 自查能力面——“查看 ai-mini-soc 的 MCP 能力”,它枚举出 60 个工具并按 14 个能力域归类(认证/告警/AI 研判/资产/优先级/审计/修复/验证……),与自己记忆中的"27 个"不符时明确纠正——以连接器实际暴露的清单为准,不凭训练记忆:
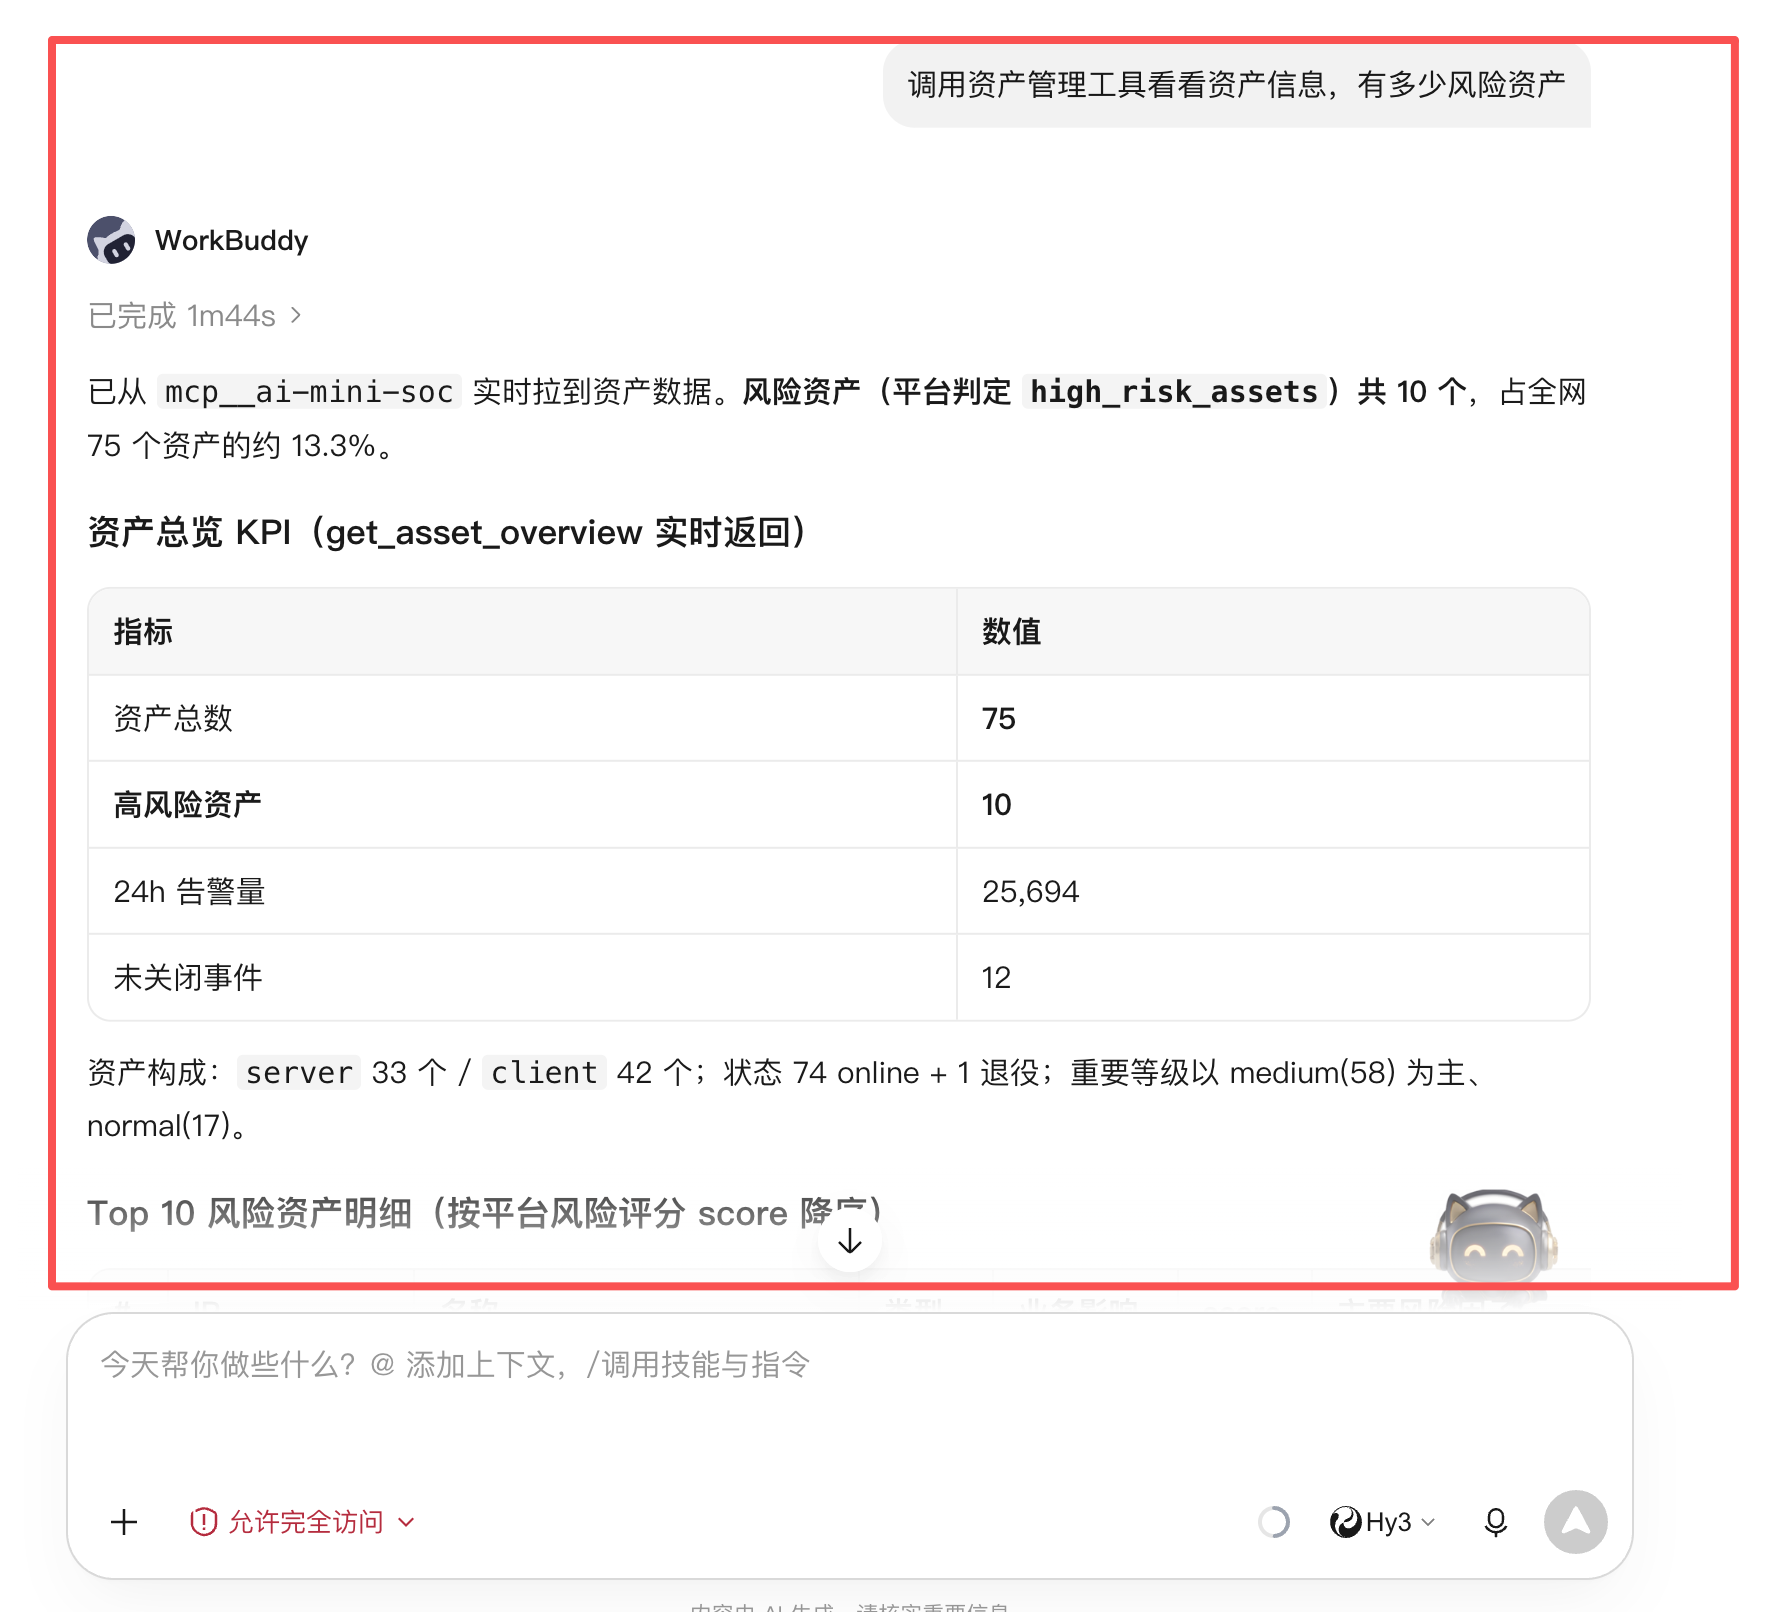
再来真格的——“调用资产管理工具看看资产信息,有多少风险资产”。Agent 实时调 get_asset_overview,返回资产总数 75、高风险 10、24h 告警 25,694、未关闭事件 12,并附 Top 风险资产明细。全程没有一行人肉复制粘贴:
踩坑记录:四个真实翻车点
坑一:SSE 长连接撞上 BaseHTTPMiddleware。 最初用 Starlette 的 BaseHTTPMiddleware 包 MCP 组合应用做 Key 校验——SSE 流式响应被中间件缓冲,客户端收不到增量事件。修法:改写纯 ASGI 中间件,SSE 长连接零包装零缓冲。教训:流式协议上叠任何"便利"中间件前,先想清楚它会不会碰响应体。
坑二:同步 DB 调用堵死事件循环。 MCP 的 uvicorn 跑在独立线程、有自己的事件循环,而 SQLAlchemy 是同步的——中间件里直接查库,一次慢查询就堵住整个 MCP 服务。修法:同步 DB 调用一律 anyio.to_thread.run_sync 扔线程池。这是 Python 异步生态的经典陷阱,在 MCP 场景下尤其容易踩(中间件看起来"就是个函数")。
坑三:fastapi-mcp 的补丁地狱。 OpenAPI 自引用递归 + 版本不兼容,最终方案要打库源码补丁加 monkey-patch——每次升级依赖都是一次心跳。这也是放弃 B 路线的直接导火索:当你需要魔改第三方库才能跑通,这个方案就已经在还债了。
坑四:Key 撤销要不要联动 JWT 黑名单——评了两次才想对。 第一版设计写的是"Key 撤销必须同步撤销该用户所有 JWT"。二轮校核推翻:① MCP mint 的 JWT 只在服务端内部使用(TokenManager 注入工具调用),Agent 侧根本拿不到;② 每个请求都重新过 Key 校验,注销清缓存后下一请求立即 401,无窗口期;③ 按 user_id 撤销全部 JWT 会误伤用户的人工登录会话。修正为:单 Key 注销只清该 key 缓存,不动 JWT 黑名单。教训:跨层设计(Key 层 × Token 层)的联动关系,先把每层的信任边界画清楚再写方案。
为什么"Agent 治理"比"Agent 接入"稀缺
MCP 的教程已经泛滥,但几乎都在讲"怎么把系统接给 Agent"——工具越多越好,能力越大越好。
本篇的全部设计反着来:
- 工具面过审:142 个路由只精选 60 个运营能力暴露,管理后门一个不给
- 入参白名单:非法参数在触达后端之前拦掉
- 输出带证据:data + evidence + confidence,Agent 推理有据可依
- 身份可收:sk-key 工牌模式,权限等同用户、撤销即时生效
- 全程审计:谁(人或哪个 Key)在何时调了什么写操作,逐条落账
和 11 篇的"三层诚实防线"同源:架构层不给路径 > 数据层强制声明 > 呈现层打标记。Agent 时代的版本就是:工具面最小化 > 入参校验 > 身份与审计。
市面产品在炫耀"我的 Agent 能做 100 件事";生产系统只该问一句:“它做错一件事的代价,你承受得起吗?”
常见问题
Q:模型幻觉导致 Agent 乱调工具怎么办?
A:三层兜底。工具面本身只含运营能力(没有"删库"这种工具可调);写操作(如 create_incident、remediation 派单)走后端完整校验和审计;数字员工工具返回 confidence,低置信度结果 Agent 和人都能看到。最坏情况是"创建了一条多余的事件记录"——可删、可审计、有据可查,不是不可逆破坏。
Q:MCP 端口暴露出去安全吗?
A:8100 建议只在内网/VPN 可达。传输层有 mcp.auth.required 开关(开了之后无 Authorization 头直接 401)+ Key 校验 + IP 失败锁定三层。真要跨公网,前面再加一层反代的 mTLS 更稳——但一个人 SOC 的典型场景是 Agent 和 SOC 同在内网。
Q:为什么 workbuddy 而不是 Claude Code?
A:都支持,配置同构(项目 README 里有三种客户端的完整配置)。本文实操以 workbuddy 为线只是因为它是我日常主力。Claude Code 一行命令接入:claude mcp add --transport http ai-mini-soc http://<host>:8100/mcp --header "Authorization: Bearer sk-mcp-..."。
Q:60 个工具会不会还是太多?
A:按域分层加载:Agent 冷启动先 get_system_info,工具清单按需探索。实测 token 开销可接受(短名字省 70% 的红利在这里)。真到了工具爆炸的程度,下一步是按 Key 的角色过滤工具面——架构上已留好口子(工具注册表按域组织)。
Q:怎么给我的系统加 MCP?
A:别从"把 API 全接上"开始。三步:① 列出你的 Agent 实际会用到的 10 个操作(不是你有的 100 个路由);② 给写操作设计审计与权限边界(先想撤销,再想发放);③ 用 FastMCP 手写这 10 个工具,名字起短些。顺序不能反——先定"给什么",再写"怎么给"。
收尾:13 在系列中的位置
| 系列主线 | 篇目 |
|---|---|
| AI 底座 / 消费点 / 可靠性 / 成果输出 | 09 / 10 / 11 / 12 |
| AI Agent 与 MCP(能力外放) | 13(本篇) |
| 工程化(告警治理/权限/CI-CD) | 14-16 |
到这里,“AI 副手"的完整弧线收拢:09 配大脑、10 教说话、11 保诚实、12 出成果、13 走出系统——AI 的能力从"你打开系统才工作"变成"在任何 MCP 客户端里随叫随到”。14 篇起回到工程化主题。
老李出差的高铁上,用手机打开 Claude:“昨晚有什么动静?” Claude 调 list_alert_triage_top:“夜间 3 条 medium,已聚类研判,无 critical。” “那个 EOL 的 Windows 机器修复工单推进了吗?” Claude 调 asset_remediation_list:“工单昨天已派给运维,状态’处理中’,预计明天回单。” 老李合上手机继续看窗外。 他没有给 Claude 管理员权限,没有告诉它任何密码—— 只是给它的工牌上,开了自己权限内的那几扇门。
值班员的价值不在它能做多少事,在于你敢在它值班时睡觉。
【系列导航】《一个人的SOC》总目录(持续更新)
【上一篇】(12) AI 安全报告与主动推送——五种场景的自动化闭环
【系列开篇】(00) 中小企业为什么需要自己的安全运营中心
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐
【Gitee 镜像】 https://gitee.com/xiejava/AI-miniSOC
【交流】 你会把系统的哪些操作暴露给 Agent、哪些坚决不给?欢迎来 Issue 对答案——工具面清单本身就是一份安全立场声明。
下一篇(预告):(14) 告警治理——聚合、分级与 13/10/7/4 阈值统一的故事(连载中,敬请关注)
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!