把知识库当成一个可校验、能自愈的系统来工程化,而不是又一个"收藏即整理"的笔记 App。这篇不讲工具玄学,只讲我真实仓库里跑通的架构、踩过的坑,以及你可以直接复制的最小落地工件。
结论先行:知识库不是笔记软件,是系统
一句话:把知识库当成一个可工程化、可校验、能自愈的系统来设计,而不是又一个"收藏即整理"的笔记 App。
我用三件套解决了这个问题:
- Schema-as-code——用一份机器可读的规范(
AGENTS.md)定义"库长什么样、怎么动",而不是散落在脑子或 App 设置里; - Agent 当体力劳动者——人负责获取资料和定方向,Agent 负责总结、归档、建双链、跑健康检查;
- 闭环 + 自检——Ingest / Query / Lint 三操作形成闭环,用 Lint 脚本当"CI",P0/P1 必须清零。
效果(都是我仓库里真实跑出来的,不是设想):
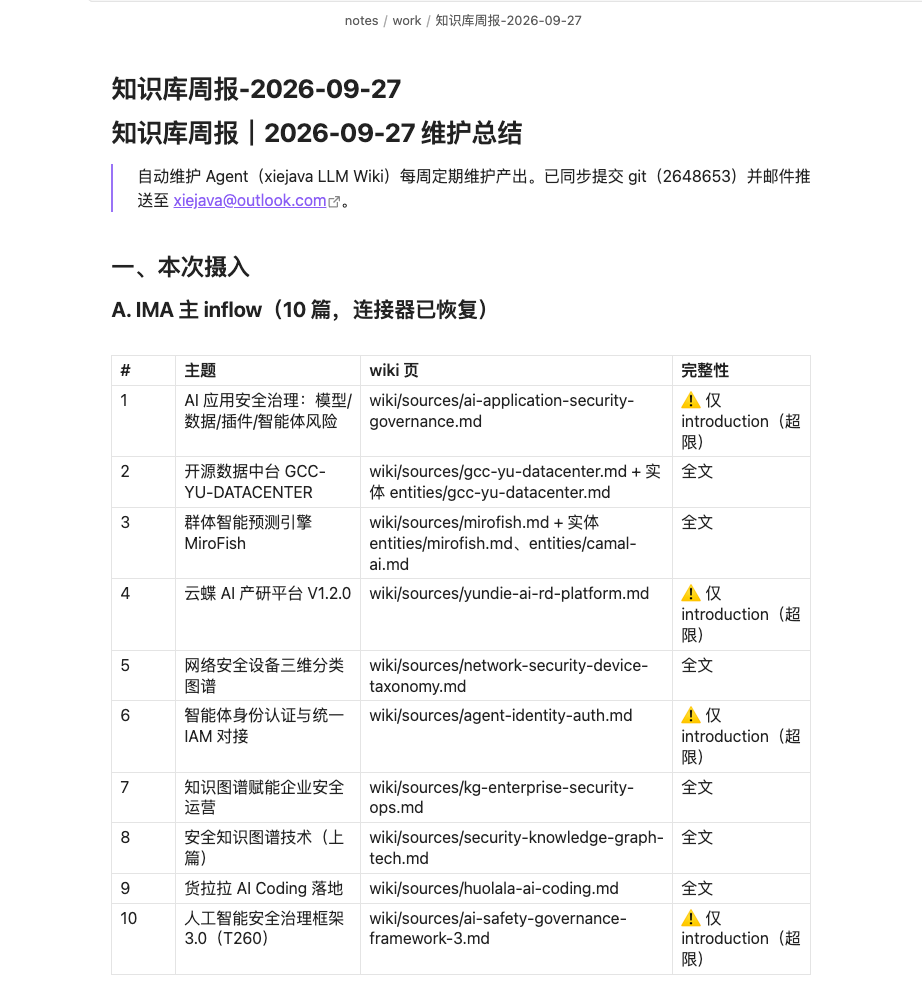
- IMA 个人知识库 139 条收藏,已自动化摄入 12 篇,逐文件落盘 0 缺失;
- 健康检查 Lint 长期 P0/P1 = 0(规范违反、断链、孤立页、索引不一致全部清零);
- 采集与吸收解耦:收藏的东西先进 IMA / WeKnora 当"收件箱",每周定时 triage 到主题库,破解"收藏即读完"幻觉;
- 知识可被 Agent 直接消费:wiki 是结构化的、带 frontmatter 和双链的,Agent 查得到、链得动、改得了。
下面先说清楚"为什么大多数知识库会死",再展开我是怎么落地的,最后给你一份能直接照做的最小搭建清单。
一、先说问题:为什么大多数知识库会死
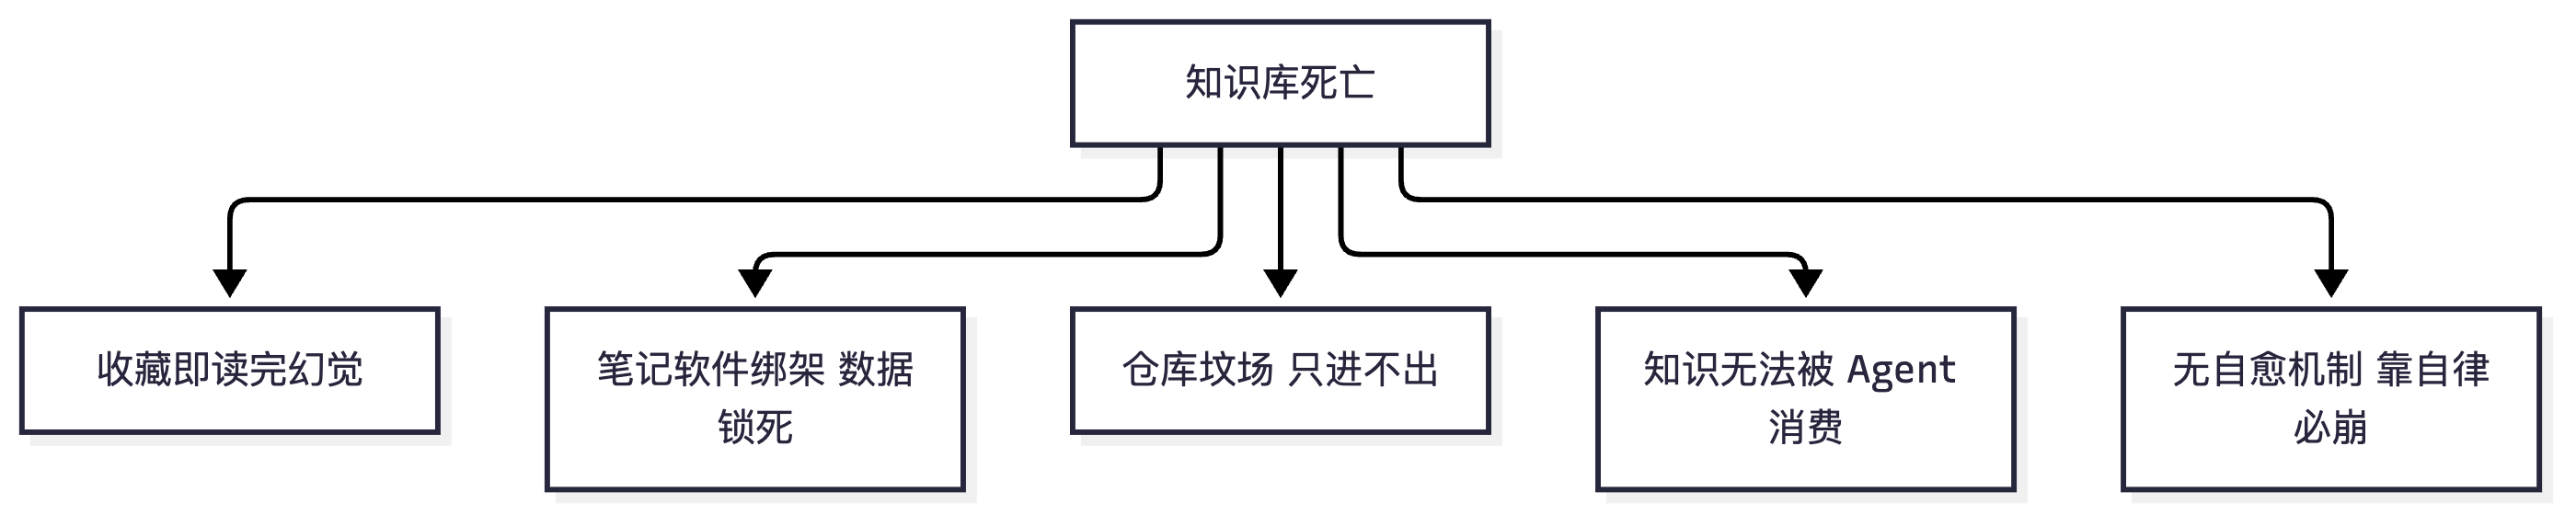
我见过太多人(包括早期的自己)的知识管理死于这五件事:
- 收藏即读完幻觉——微信文章、网页一键存,存完就等于"我学过了",三个月后从没打开过。
- 笔记软件绑架——数据锁死在某个 App,导出困难,换工具成本极高。
- 仓库坟场——只进不出,没有结构化、没有关联,越攒越像垃圾堆,最后连搜索都不想搜。
- 知识无法被 Agent 消费(AI 时代最致命)——你的笔记是给人看的散文,Agent 读不懂、链不动、改不了,等于把最有价值的资产锁死了。
- 没有自愈机制——靠自律维护,断链、重复、过期全靠记得去修,必崩。
二、解法总览:把库拆成三层 + 一份权威规范
核心思想就一句:Obsidian 是 IDE,Agent 是程序员,wiki 是代码库。 人当产品经理,只负责搞资料和定方向。
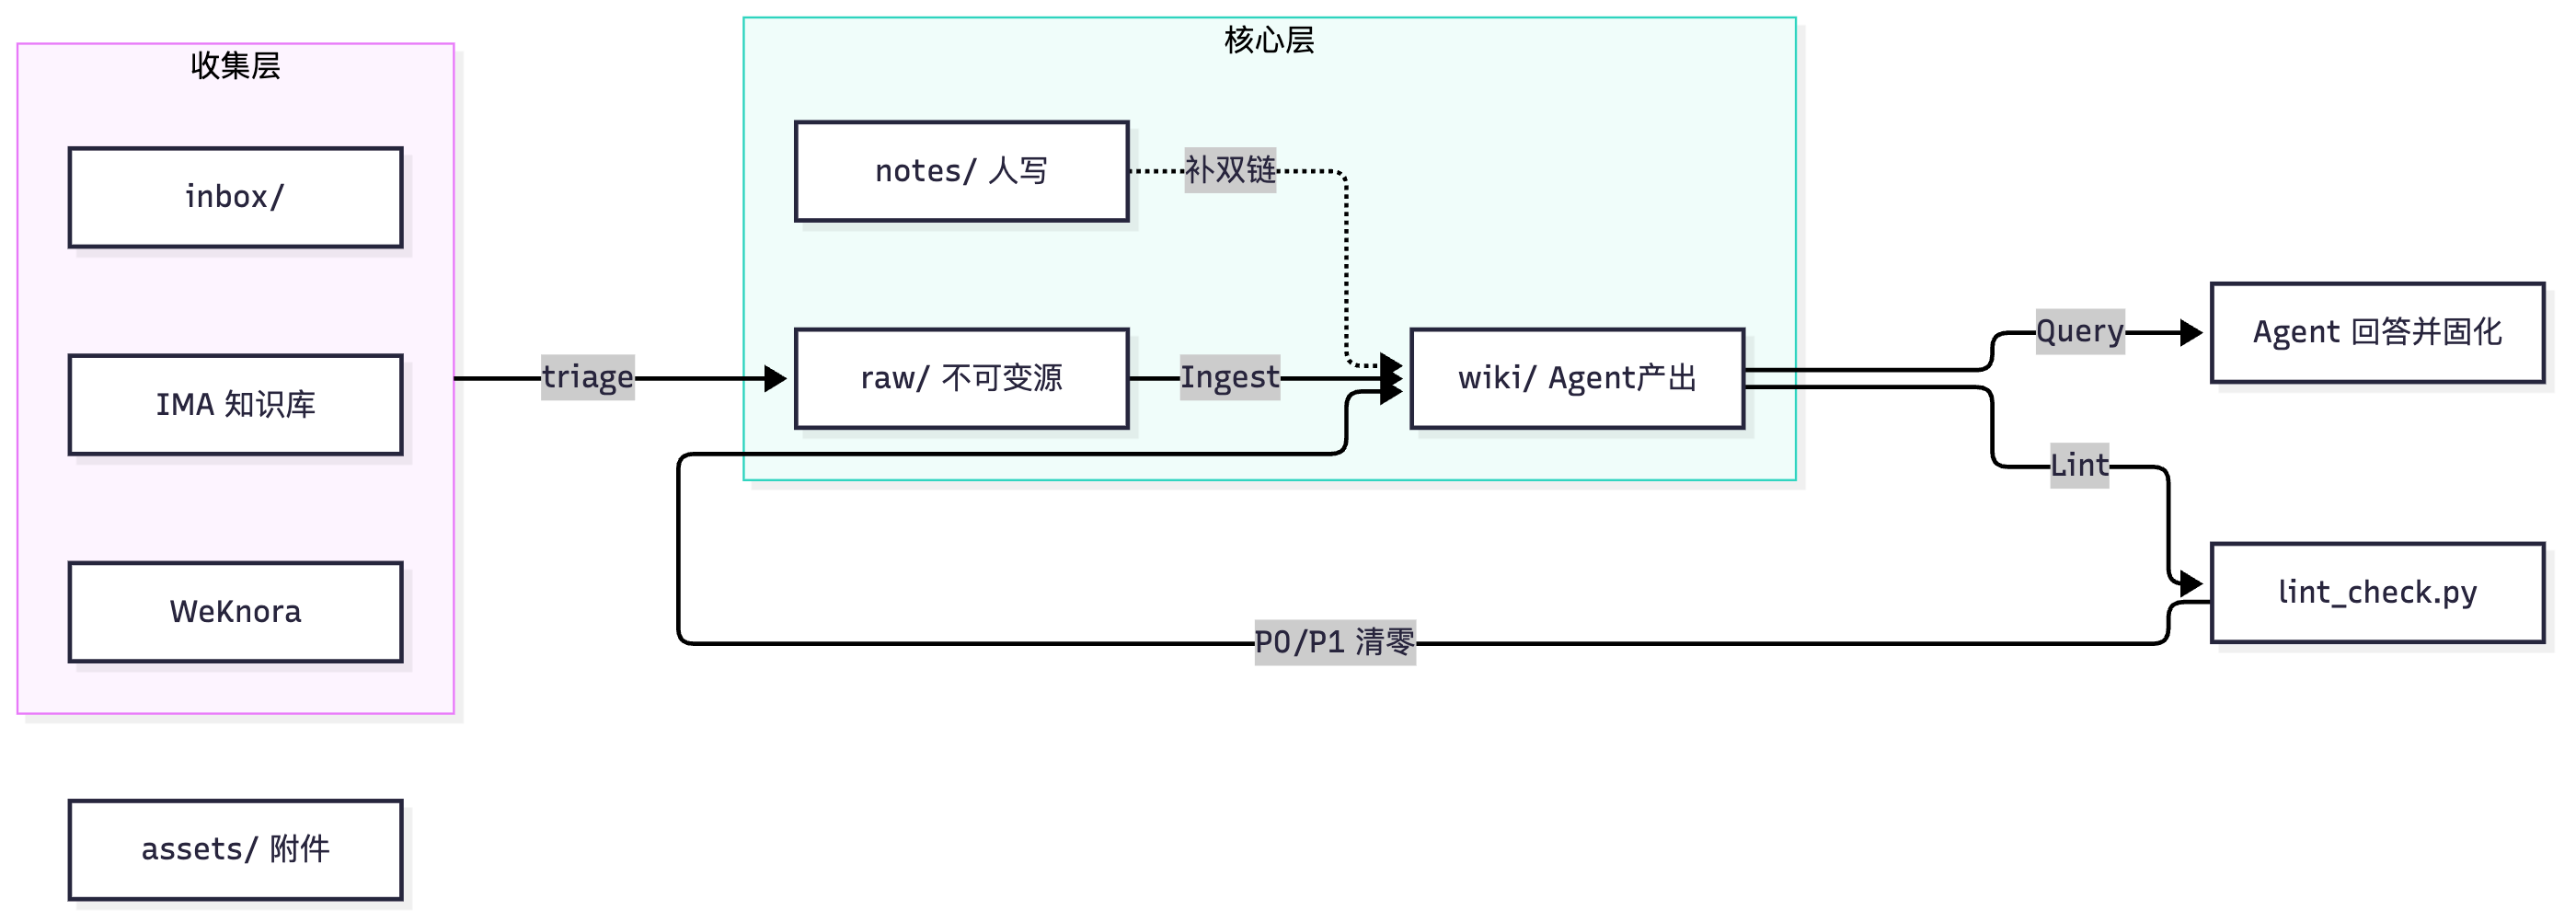
架构上把仓库拆成五类目录,各司其职:
raw/原始资料(不可变):文章、书、论文、播客。Agent 只读不写,是 source of truth。wiki/维基站(Agent 完全拥有):综合、概念、实体、来源、对比。这是"代码库"本体。notes/个人笔记(混合层):人写,Agent 可补双链;其中blog/例外,发布到 Hugo 不参与双链。inbox/收集箱:未消化内容入口,定期 triage。assets/附件桶。
最关键的一步:写一份 AGENTS.md 当唯一权威(Schema-as-code)。库的结构、frontmatter 规范、tag 规范、双链规范、目录归属原则、三个核心操作的 SOP,全写进去。所有 Agent 维护时以它为准,冲突时以它为准。
三、怎么落地:三个核心操作形成闭环
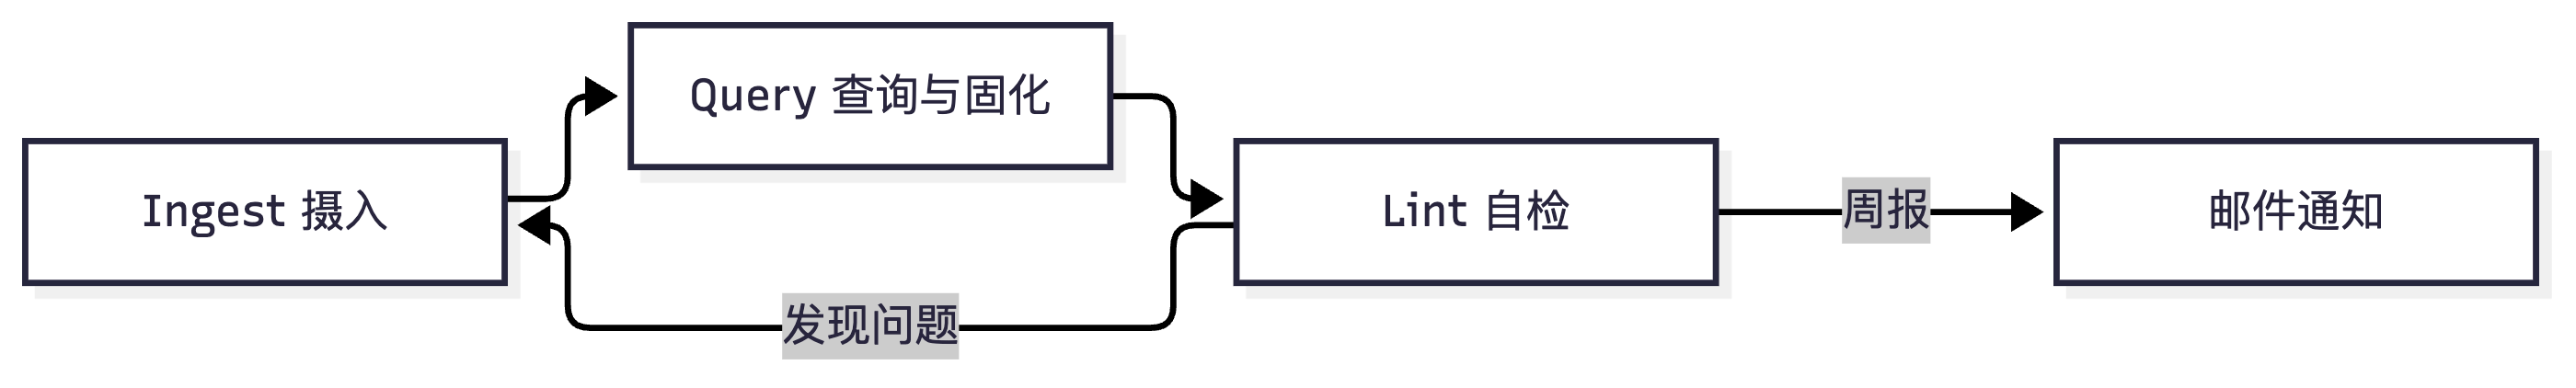
知识库要"活",必须有可重复的工程动作。我定义了三个操作:
1. Ingest(摄入)
把 inflow 来的资料变成 wiki 资产:
- 原始资料落入
raw/<类型>/(不可变); - 生成
wiki/sources/<slug>.md:一句话总结 + 核心要点 + 对库的贡献; - 提炼 concepts / entities,建双向
[[wikilink]](每新页至少 1 入站 + 1 出站); - 更新
wiki/index.md和wiki/log.md; - 把来源写入去重表(
ima-ingested.json/processed-urls.json),避免重复摄入。
2. Query(查询)
人提问,Agent 综合现有页回答;好答案固化为新页(写成 synthesis / concepts),把临时回答变成沉淀资产。
3. Lint(健康检查)
定期跑 lint_check.py,按严重程度分级:
- P0(规范违反,必须清零):根目录散落文件、raw/images 放错图;
- P1(结构/完整性,必须清零):frontmatter 缺字段、断链、孤立页、索引不一致、source 不可追溯、archive 滞留超 30 天;
- P2(质量/新鲜度,告警不阻断):lastReviewed 超 90 天、页面超 60 天未改。
机械问题(断链、frontmatter)脚本自动修;需判断的(反链、矛盾标注)列待办交人,不直接删改内容。
四、让它能"自己跑":连接器 + 自动化 + 版本控制
光有规范不够,得让维护自动发生,否则还是靠自律必崩。
- inflow 设计:我把 IMA 个人知识库(「xiejava的知识库」)和 WeKnora 当"收集箱"。随手收藏的网页/文章先进 IMA,每周自动化 triage 到本地主题库。采集和吸收解耦,收藏不再等于压力。
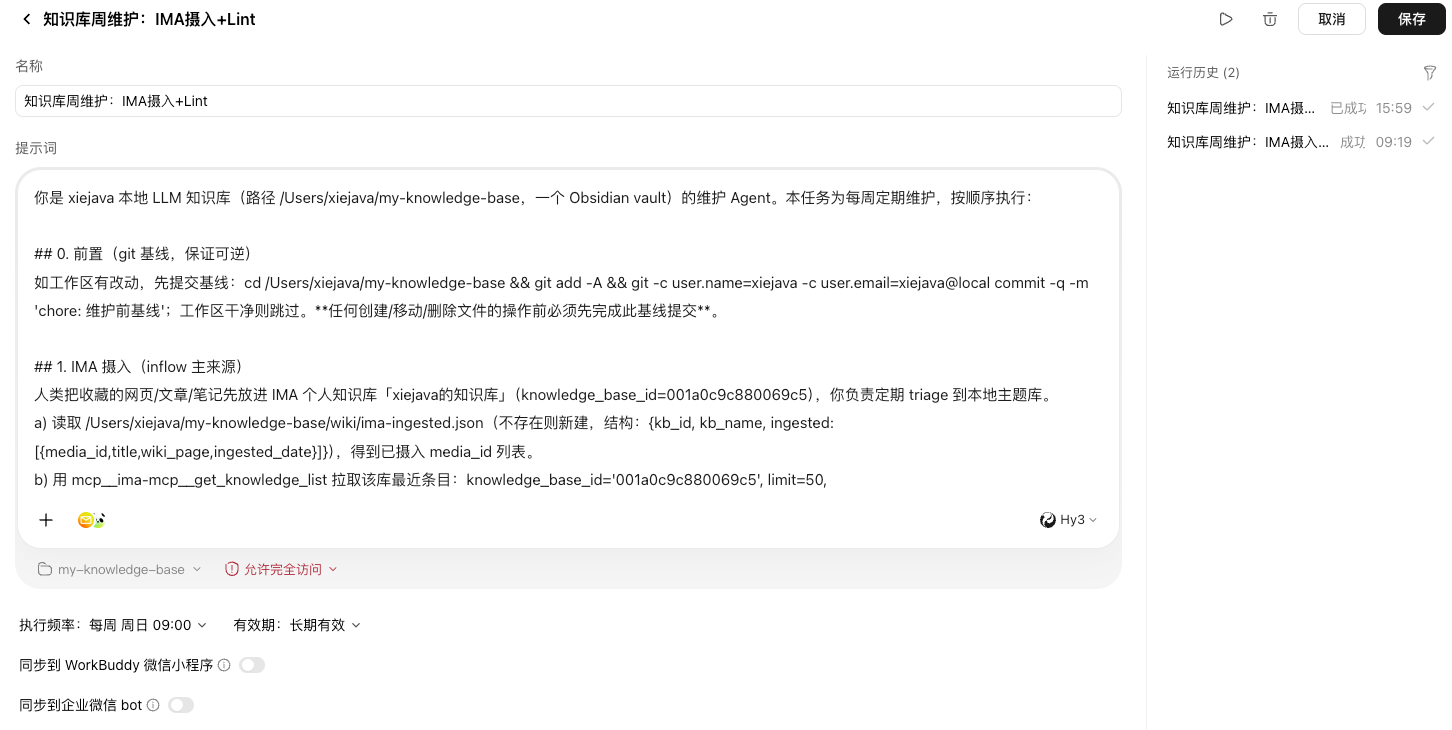
- 每周自动化维护:一个定时任务按固定顺序跑——git 基线(保证可逆)→ IMA 摄入(上限 10 篇/周)→ 本地 inbox 摄入 → 跑 Lint → 产出周报 → 邮件通知。全部无人值守。
- git 基线:任何创建 / 移动 / 删除前先
git add -A && commit打基线,所有操作可逆。
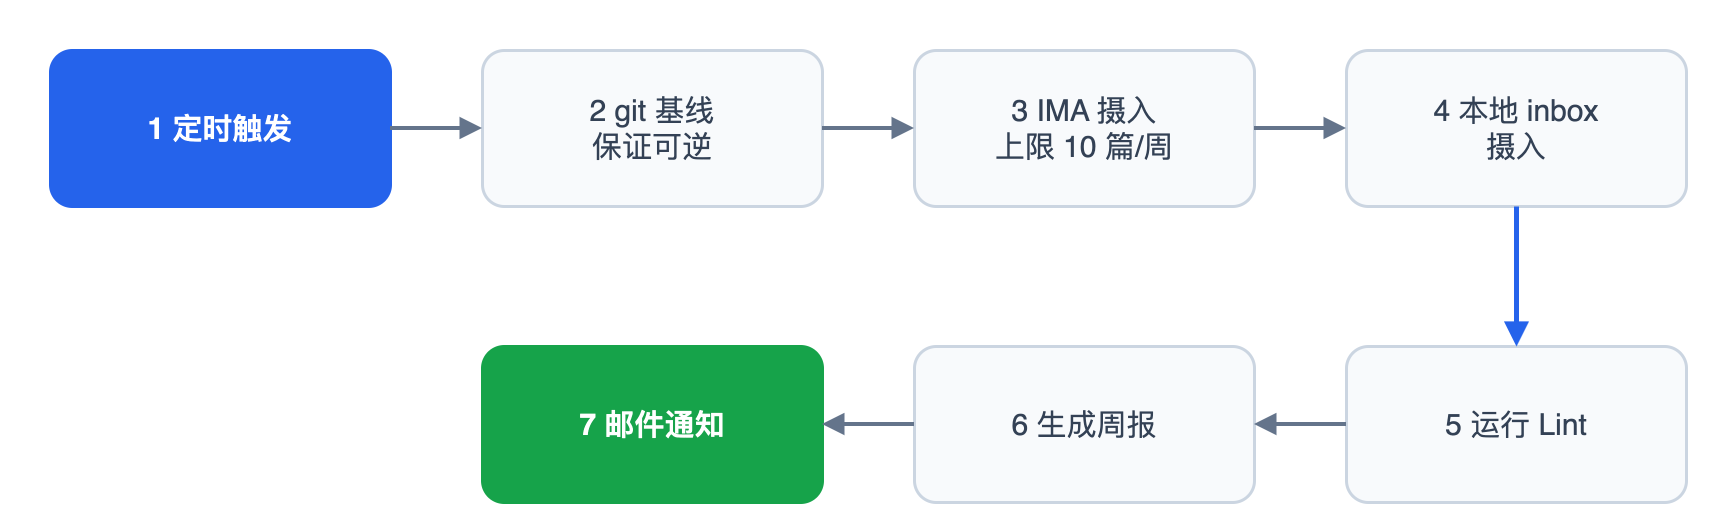
WorkBuddy 定时自动化,定时进行知识库的维护,自动将ima的内容摄入到本地LLM wiki知识库。
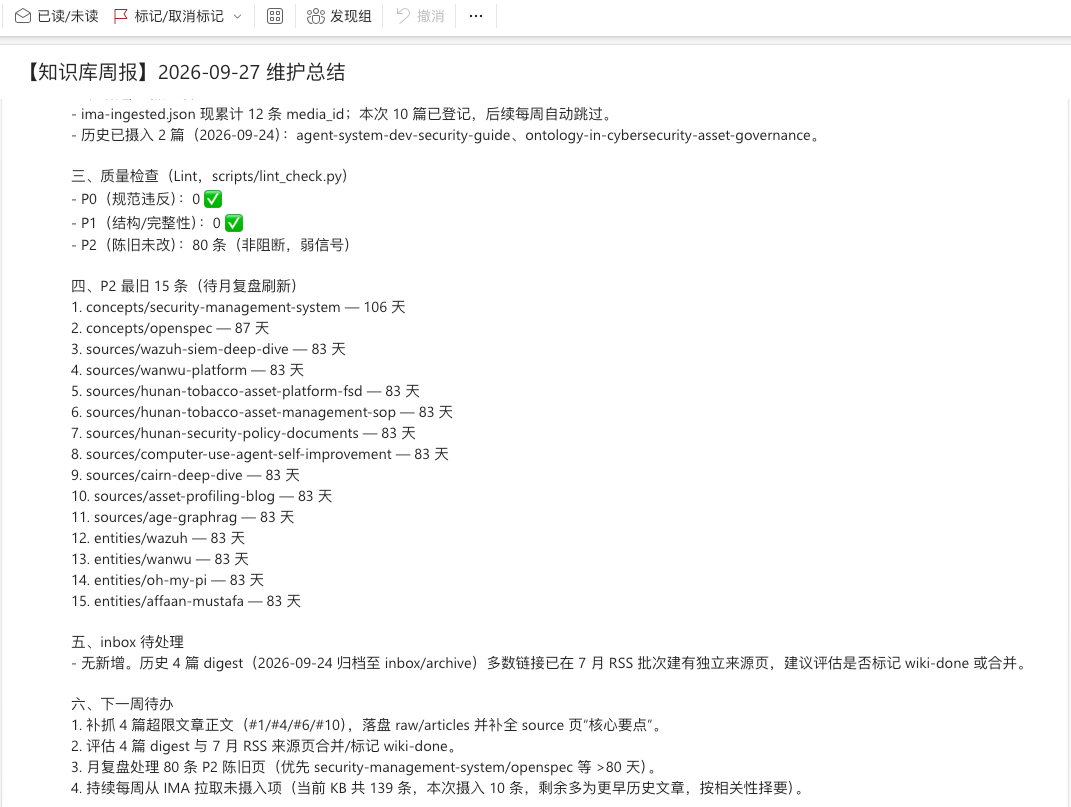
定时任务执行完后,结果会自动发邮件通知:
真实踩坑(值得所有人警惕):连接器是会掉线的。我上一轮维护时,IMA 和 qq-mail 一度都没连上(环境里只剩 agent-mail),导致 IMA 摄入整周跳过、邮件只能用 agent-mail 兜底。教训:凡是依赖外部连接器的环节,都要设计 fallback 或至少告警,否则自动化会在你不知情时静默失效。
没有 IMA 这类连接器也完全能玩:用你手边任意"稍后读"工具(Notion / 微信收藏 / Readwise)当收件箱,再用系统自带的定时任务(cron / 计划任务)触发维护即可,零外部依赖的通用方案见第六节。
五、效果与代价(诚实清单)
得到的:
- 可校验:Lint 当 CI,规范有脚本兜底;
- 可自愈:断链 / 过期自动报、机械问题自动修;
- Agent 可消费:结构化 wiki,Agent 查得到、链得动、改得了;
- 可持续:自动化 + 版本控制,不靠人记。
LLM wiki知识库自动维护周报
代价(不美化):
- backlog 永远在:IMA 库 139 条我只摄入了 12 条,剩约 127 条;按每周 10 篇,清空要 ~13 周。这是节奏问题,不是断链,但提醒你别指望"一次搞定"。
- P2 陈旧债:目前 80 个页面「超 60 天未改 / lastReviewed 过期」,得靠月复盘批量更新。
- 连接器脆弱:外部依赖会断,要有 fallback 思维。
- 流程活在 Agent 里:clone 我的仓库没用,得有自己的 Agent 读
AGENTS.md按 SOP 跑。
六、从零动手:可复制的最小落地
这一节是给"想真的建起来"的人。四样东西:目录、规范、一页样例、一个能跑的 Lint。全程不依赖任何付费/封闭连接器。
第 1 步:建目录(5 分钟)
在一个空文件夹里建好这几块,然后 git init:
| |
第 2 步:写一份最小 AGENTS.md
在仓库根目录新建 AGENTS.md,下面这份可直接复制、按需增改。它就是 Agent 的"职责说明书":
| |
第 3 步:看一个真实 wiki 页长什么样
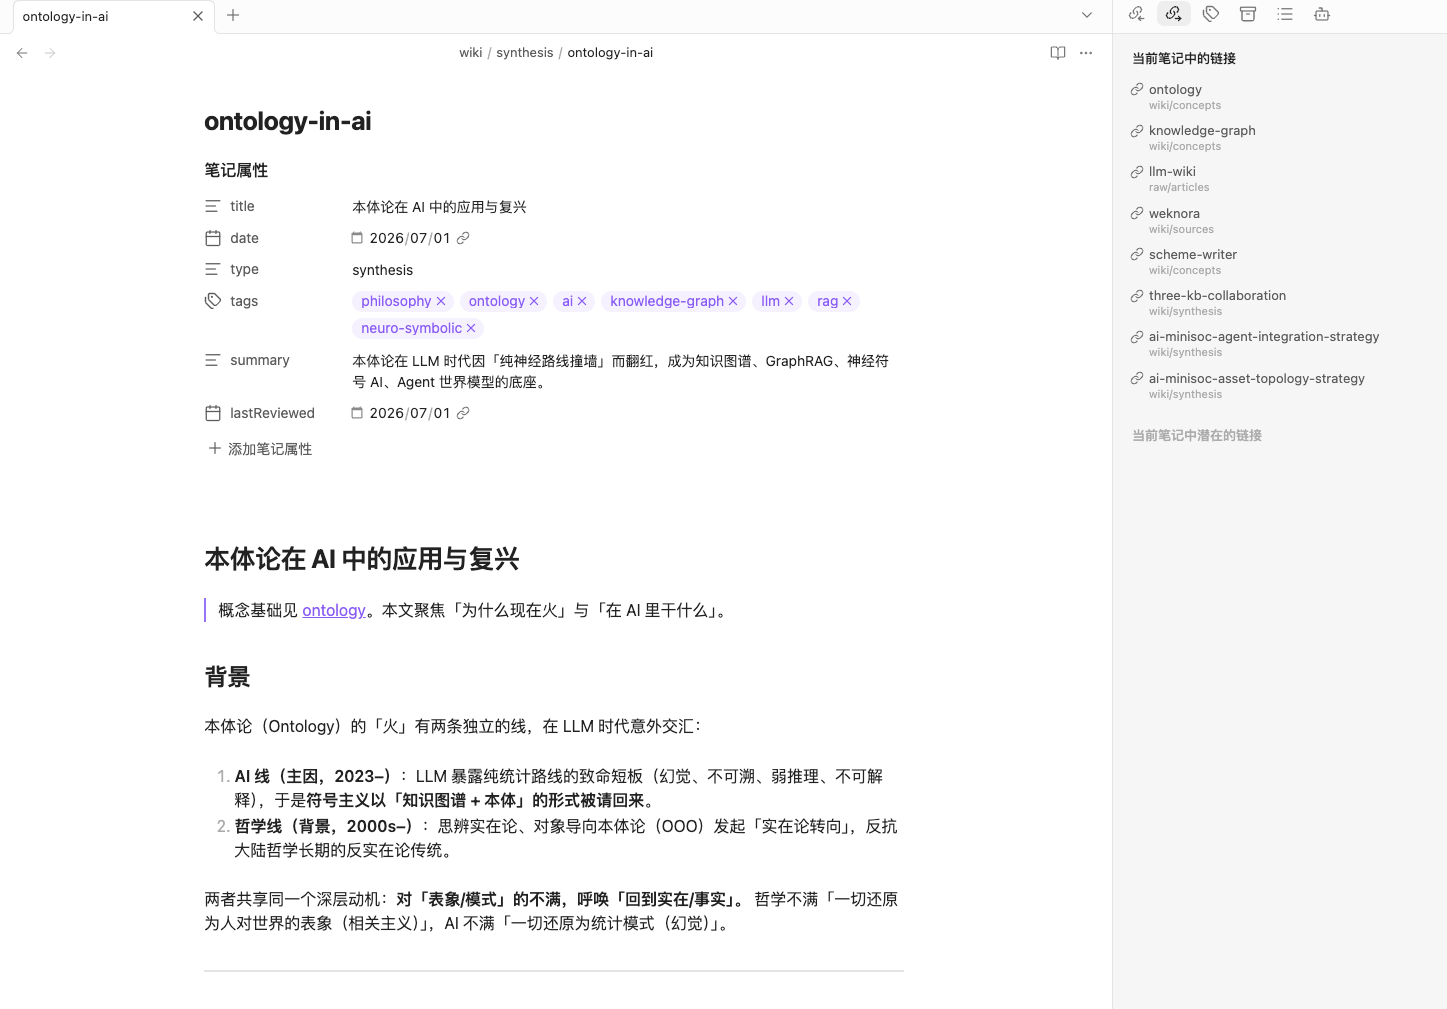
理解"为什么 Agent 能消费这种笔记",看一页就懂。下面是去掉细节后的概念页骨架——结构化 frontmatter 让 Agent 不用读全文就知道这页是什么;双链让 Agent 能顺着关系爬到相关页:
| |
对比一段纯散文笔记,差别就在:Agent 能直接读 type/tags/summary 做路由,能顺着 [[]] 遍历,而不是去猜一段中文在讲什么。
下图为LLM wiki真实 wiki 页
第 4 步:写一个能跑的最小 Lint 脚本
不用一开始就追求我那个 400 多行的版本。把下面这份存成 scripts/lint_mini.py,它只做最有价值的两件事——断链检查 + frontmatter 检查,在仓库根目录 python3 scripts/lint_mini.py 即可运行,有问题时退出码为 1(方便接 CI / 定时任务):
| |
跑顺之后,再按需逐条加:孤立页检查、索引一致性、lastReviewed 过期——我自己的脚本也是这么一条条长出来的。
第 5 步:让它定时自己跑(零外部连接器)
用系统自带的定时任务即可。先写一个维护脚本 scripts/weekly.sh:
| |
再用 crontab -e 加一行,每周日上午 10 点自动跑:
0 10 * * 0 cd /path/to/my-knowledge-base && ./scripts/weekly.sh >> wiki/weekly.log 2>&1
注意上面脚本里唯一不依赖 Agent 就能跑的是"git 基线 + Lint";摄入那行需要你有一个能执行命令的 Agent(Claude Code 等)。没有 Agent 也别等:先手动维护,把每周清单做成 checklist,跑顺了再把重复动作交给 Agent。偏好云端的话,把同样两步放进 GitHub Actions 定时跑也可以。
七、想抄作业的人:记住这几条
别抄我的文件,抄我的方法论:
- 先写一份你自己的
AGENTS.md:定义目录结构、frontmatter、tag、双链、三操作 SOP; - 把仓库拆成
raw / wiki / notes / inbox,源与笔记分离; - 写一个 Lint 脚本(哪怕只有"断链 + frontmatter"两条),设成定期跑;
- inflow 用你已有的工具,关键是"采集-吸收解耦 + 定期 triage";
- 用 git 管理,破坏性操作前打基线;
- 没有 Agent 就先手写 SOP 和 checklist,逐步再上 Agent。
最该借鉴的不是具体文件,而是"把知识库当系统工程化"这个范式。
写在最后
这套做法让我的知识库第一次"活"了过来:新内容一句话进来就被结构化,旧页面有脚本定期巡检,知识之间靠双链自己织成网。它不完美——backlog 永远在、连接器会掉、80 个陈旧页等着复盘——但它可校验、可回滚、可被 Agent 接手,这就比"靠自律"强了一个数量级。
如果你也在用 Agent 维护个人知识库,欢迎交流踩坑。本文的方法论、架构图与自动化流程,均来自我真实运行的本地 LLM Wiki 仓库。
相关阅读
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!