先说一个很多人的直觉:“我一个人用,CI/CD 是不是过度工程?”
我的答案是:恰恰相反,你比大团队更需要它。
原因很简单——大团队里,部署出事有人接手、有人 review、有人半夜爬起来。你呢?你是开发者,也是运维,还是唯一的那个人。一次手滑的部署,可能让整个 SOC 停机到第二天早上,期间你唯一的 SOC 也在裸奔。
AI-miniSOC 之前的部署是什么样?
Mac 上改代码 → SSH 登录服务器 → git pull → nohup uvicorn & → 祈祷没坏
每次 5-10 分钟,没有自动回滚、没有失败告警、没有版本追溯。上线前要手动检查一遍环境变量对不对、数据库迁移跑了没、服务起来了没——全部靠人脑。
现在的样子:
git push → CI 自动跑测试 → 全绿 → 自动部署 → 1.5 分钟完成 → 坏了自动回滚
你 push 完就可以去干别的了。 这一篇讲这套东西怎么搭、为什么这么搭、以及中间踩过的坑。
一、CI/CD 有什么用:你得到了什么
先看结果,再看实现。
1.1 三个最实在的变化
| 改造前 | 改造后 | |
|---|---|---|
| 部署耗时 | 5-10 分钟手工 | 约 1.5 分钟自动 |
| 部署坏了 | 你自己排查、回滚、祈祷 | 自动回滚到上一个 commit + 邮件告警 |
| 上线前检查 | 靠记忆和手测 | CI 自动跑:后端 pytest + 前端 lint/typecheck + 38 个安全门禁 |
第三行是重点:15 篇讲的那套权限门禁,就跑在这条流水线上。权限设计的"防复发"不是靠人记住,是靠 CI 红了合不进去——CI/CD 不是一个独立的工程话题,它是前几篇所有工程化努力的总装线。
1.2 每次部署留下什么
- 完整日志:
/tmp/aisoc-deploy.log记录每一步(拉哪个 commit、装了哪些依赖、build 产物入口、健康检查几次过) - 版本可追溯:每次部署的 commit SHA 有据可查,回滚就是
git reset --hard <上一个> - 失败有通知:GitHub Actions 内置邮件——commit 作者和 repo watchers 自动收到,零配置
- 进程自己会活:systemd 托管,崩了自动拉起,开机自启
改造前你的部署记录在聊天记录里;改造后它在一个日志文件里。 半夜出问题时,这两者的差别就是"10 分钟排查"和"10 秒看日志"。
二、怎么实现的:一条流水线,四个关键选择
2.1 全景
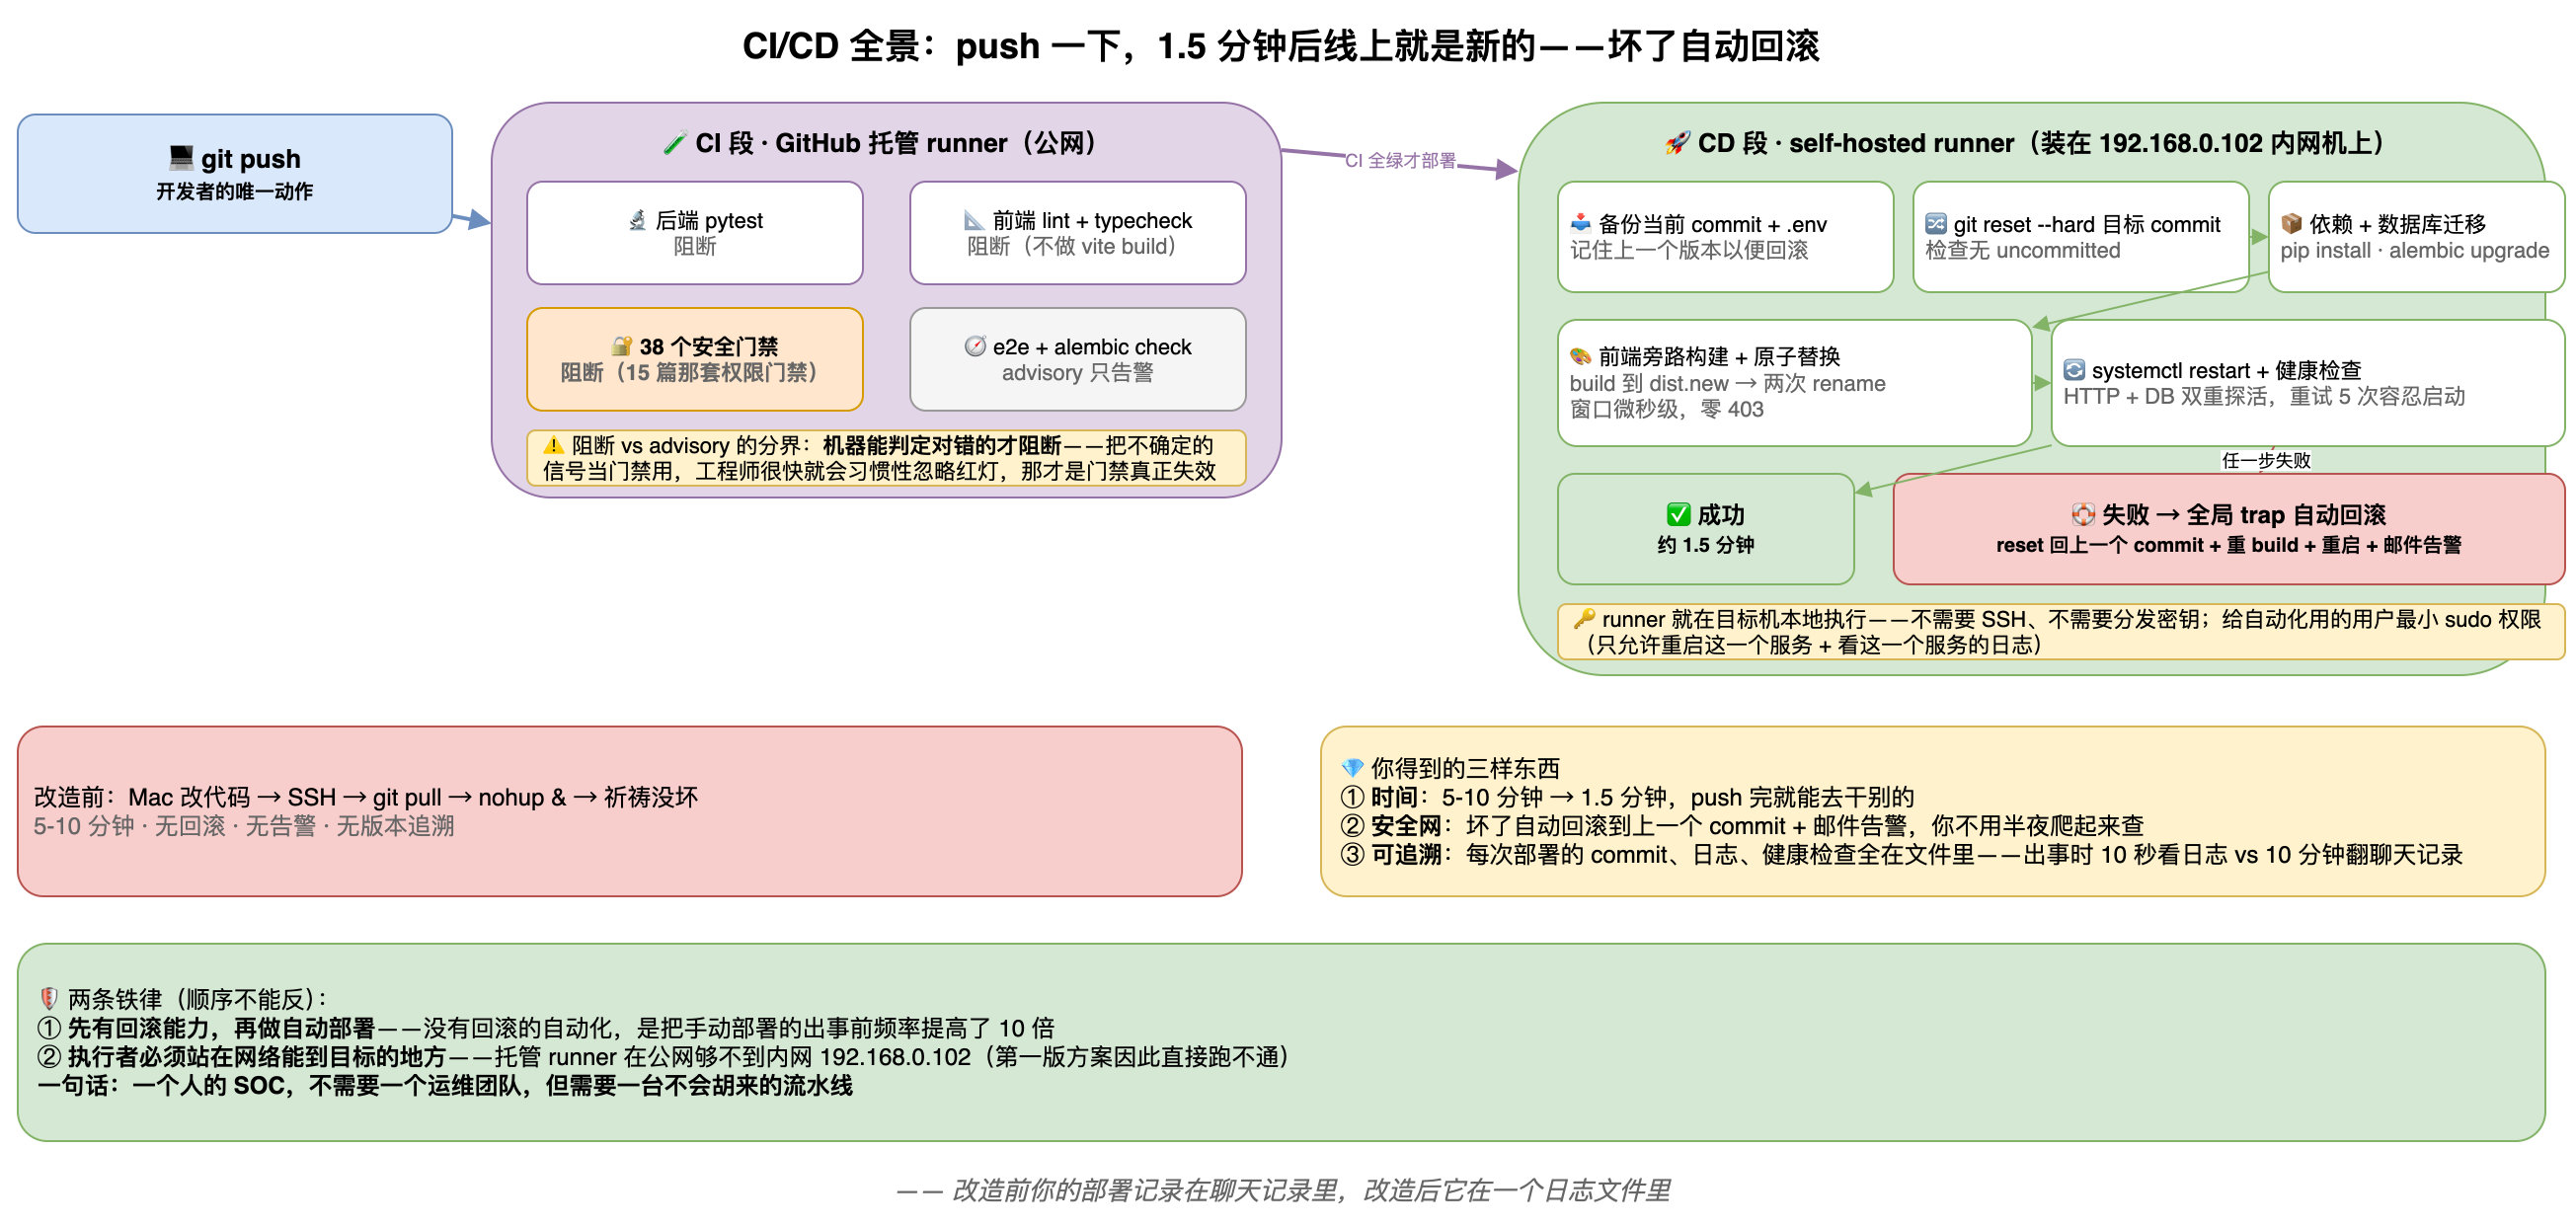
流水线分两段,用两种 workflow 表达:
- CI 段(GitHub 托管 runner):后端 pytest + 前端 lint/typecheck + 安全门禁。只验证,不部署
- CD 段(self-hosted runner,跑在服务器本机):拉取指定 commit → 执行部署脚本 → 健康检查 → 成功留档 / 失败回滚
关键连接点:CD 不监听 push,而是监听 workflow_run——只有 CI 全绿才触发部署。少一次 push 少一次部署,避免"合并即部署"绕过测试。
2.2 选择一:runner 装在哪(决定方案生死)
这是整套方案里最先卡住的一个决策,也是最容易被想当然的一个。
第一版设计:GitHub 托管 runner + SSH 到生产服务器。听起来标准,实际跑不通——
托管 runner 在公网,192.168.0.102 是内网 IP。公网路由不到私网地址,SSH 连接根本建立不了。
改法:在 192.168.0.102 上装一个 self-hosted runner。runner 常驻在服务器上,主动出公网连 GitHub 拉任务,在本地执行部署脚本。全程不需要 SSH、不需要分发密钥——因为执行者就在目标机器上。
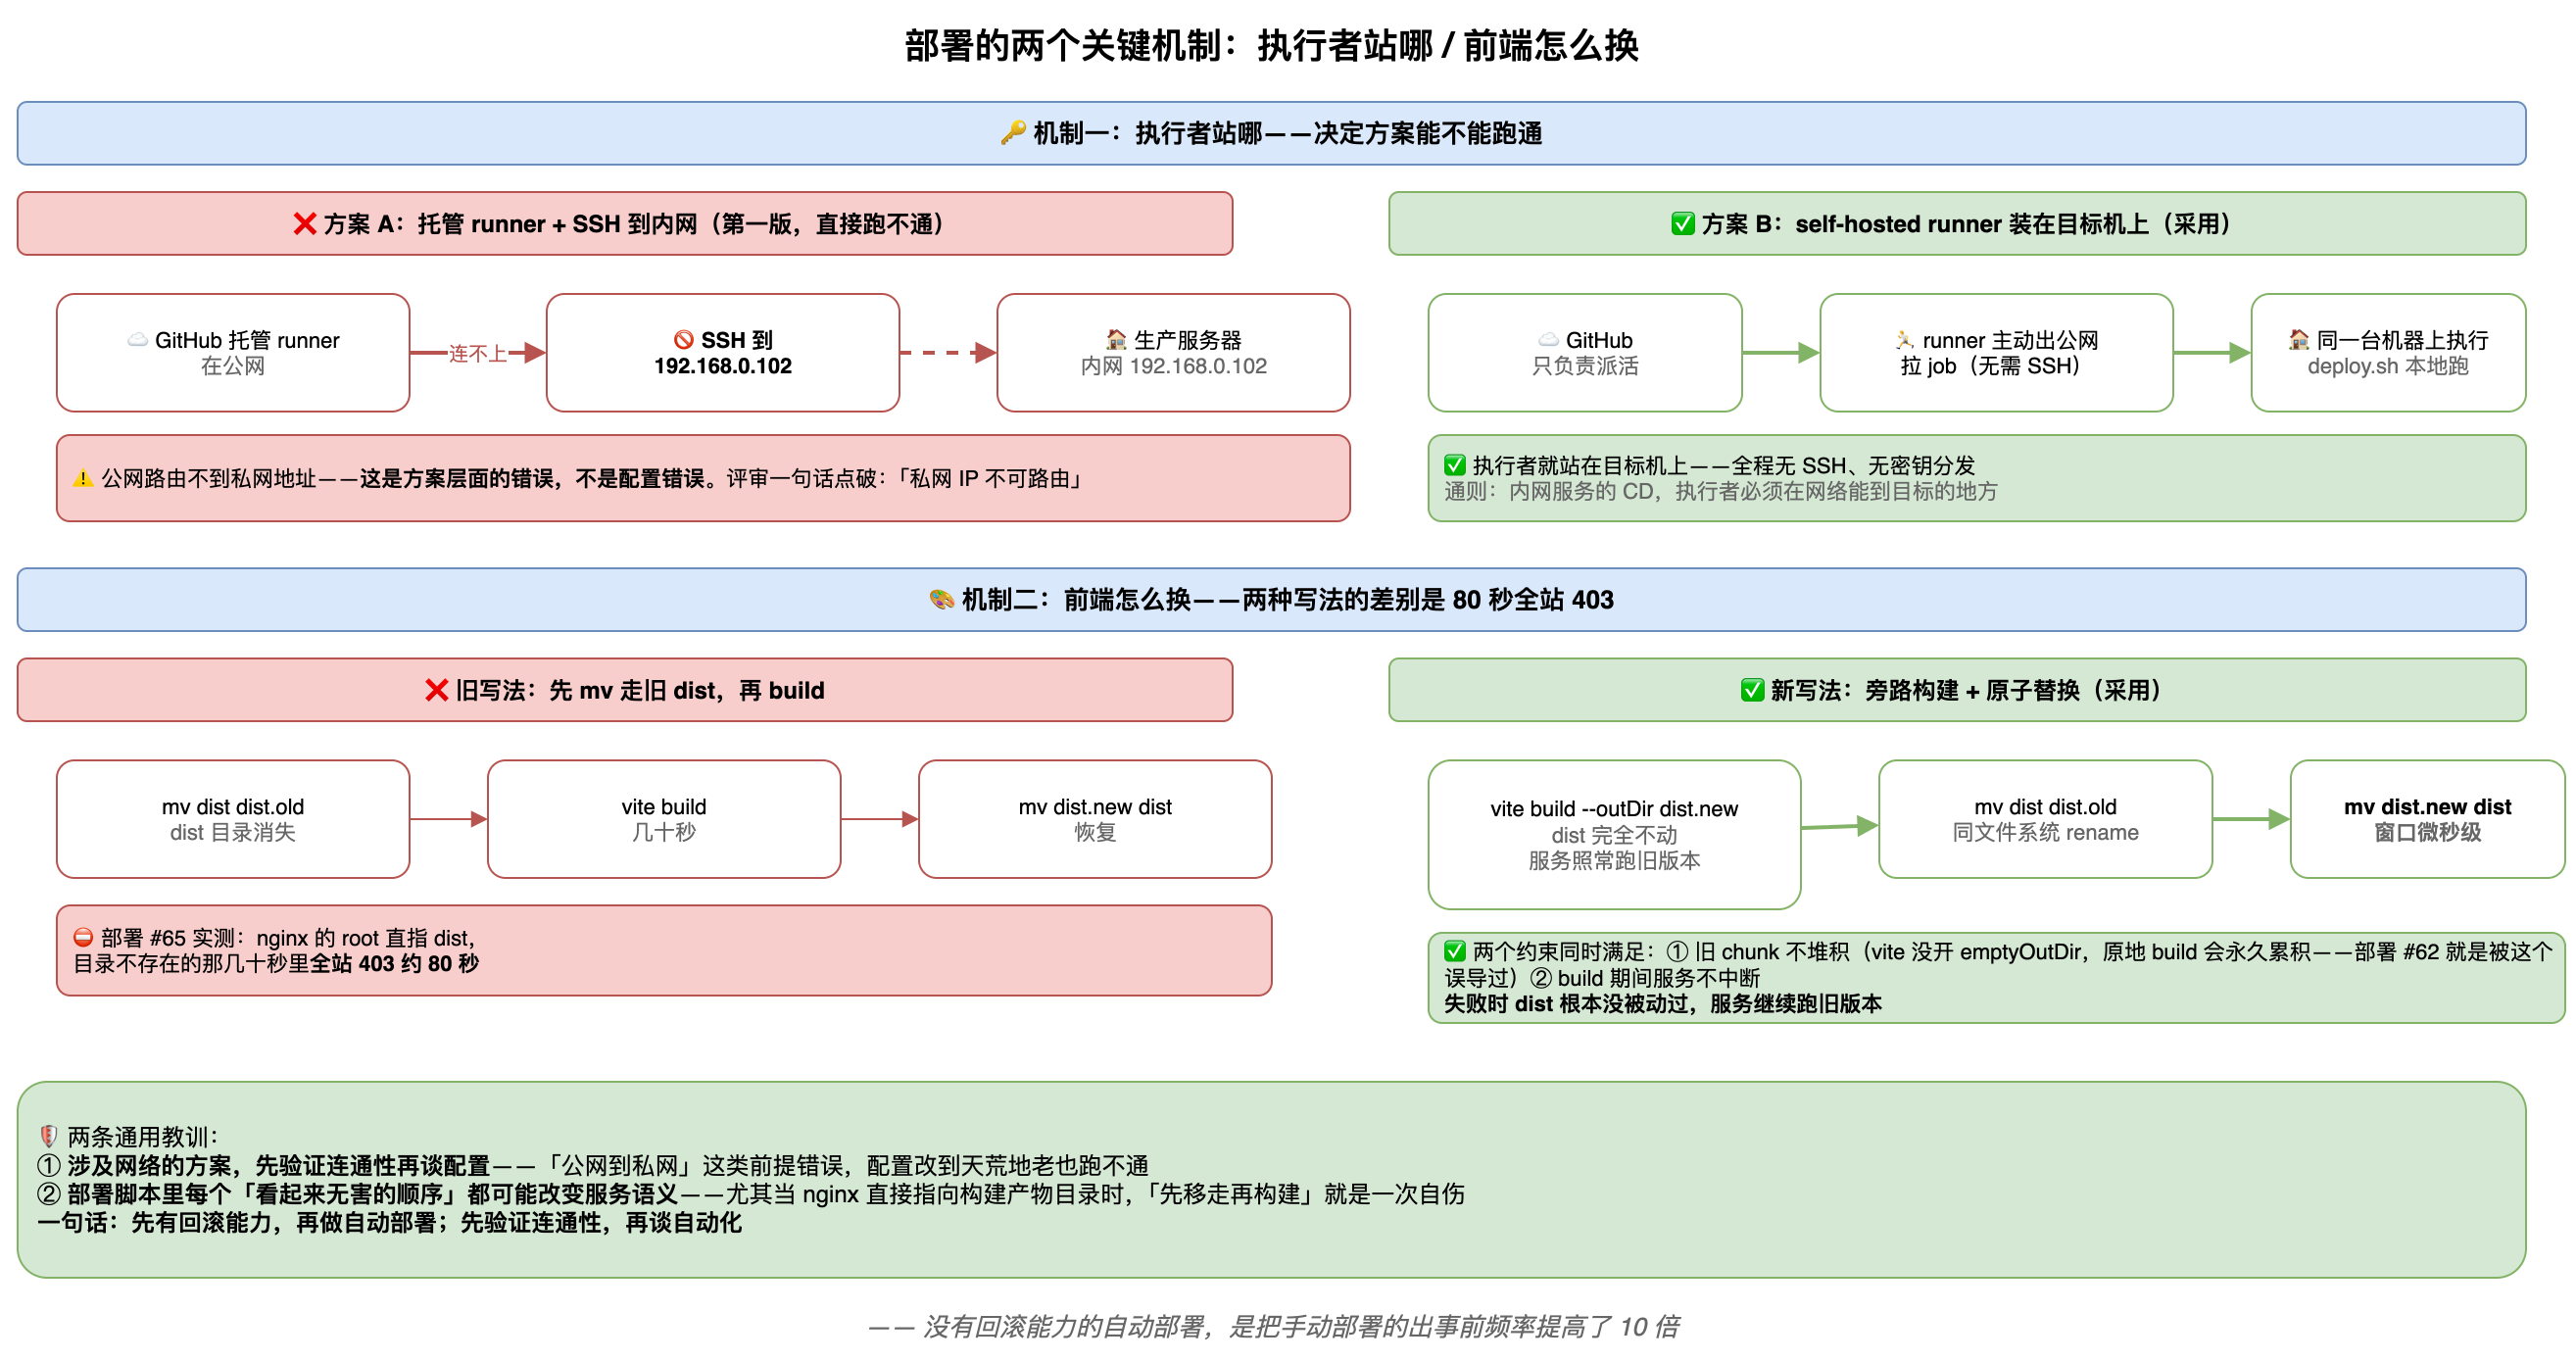
这一条对任何"内网服务"都是通则:部署执行者必须站在网络能到目标的地方。
2.3 选择二:前端构建在哪做
第二版决策(评审推翻过一轮):构建放 GitHub Actions 还是服务器本地?
选服务器本地构建。理由不是"哪个更先进",是环境差异——服务器上有 .npmrc(国内镜像)、有平台相关的二进制依赖(tailwind oxide),在 Actions 上构建等于让产物依赖另一个环境。
于是分工清晰:
- CI 只做 lint + typecheck(快、且不依赖构建环境)
- CD 在服务器本地做完整 build(npm ci + vite build)
为什么不传 artifact? 简单、避免跨平台产物差异——对一个人的项目,这个取舍很划算。
2.4 选择三:数据库迁移谁来跑
这是最谨慎的一个决策,也是唯一一处故意保留人工的环节。
最初的设想是"CD 自动 alembic upgrade head"。评审打回,理由很硬:数据迁移失败难回滚。代码回滚一行 git reset 就完事,但 schema 已经改了的话,代码和数据对不上。
改法:
- CI 跑
alembic check(对比模型与迁移差异)——但非阻塞,只告警 - 真正的 upgrade 由 DBA 审阅迁移文件后手动跑
值得玩味的是:部署脚本后来还是加上了自动 upgrade,但前提变了——回滚能力先建好了(下面的 trap),所以"自动跑迁移"从危险变成了可控。先有后悔药,再考虑自动上路。
2.5 选择四:进程怎么管
nohup uvicorn & 是历史包袱:系统重启要手动起、进程崩了不复活、日志散在各处。
换成 systemd,一次配置换来四件事:开机自启、崩溃自动拉起、journald 统一日志、cgroup 资源限制。
配套的还有最小权限 sudoers——部署用户只被允许重启这一个服务、看这一个服务的日志,不是 sudo ALL:
xiejava ALL=(ALL) NOPASSWD: /usr/bin/systemctl restart aisoc-backend
xiejava ALL=(ALL) NOPASSWD: /usr/bin/journalctl -u aisoc-backend *
自动化系统的权限,应该精确到"只能做这一件事"——和 13 篇"工具面 = 攻击面"、15 篇"权限要最小化"是同一条原则,只是这次的对象从 API 换成了服务器。
三、失败怎么办:全局 trap 自动回滚
这是整套方案里你最该关心的部分——自动部署最怕的不是部署失败,而是部署失败后没人知道、没人恢复。
3.1 机制
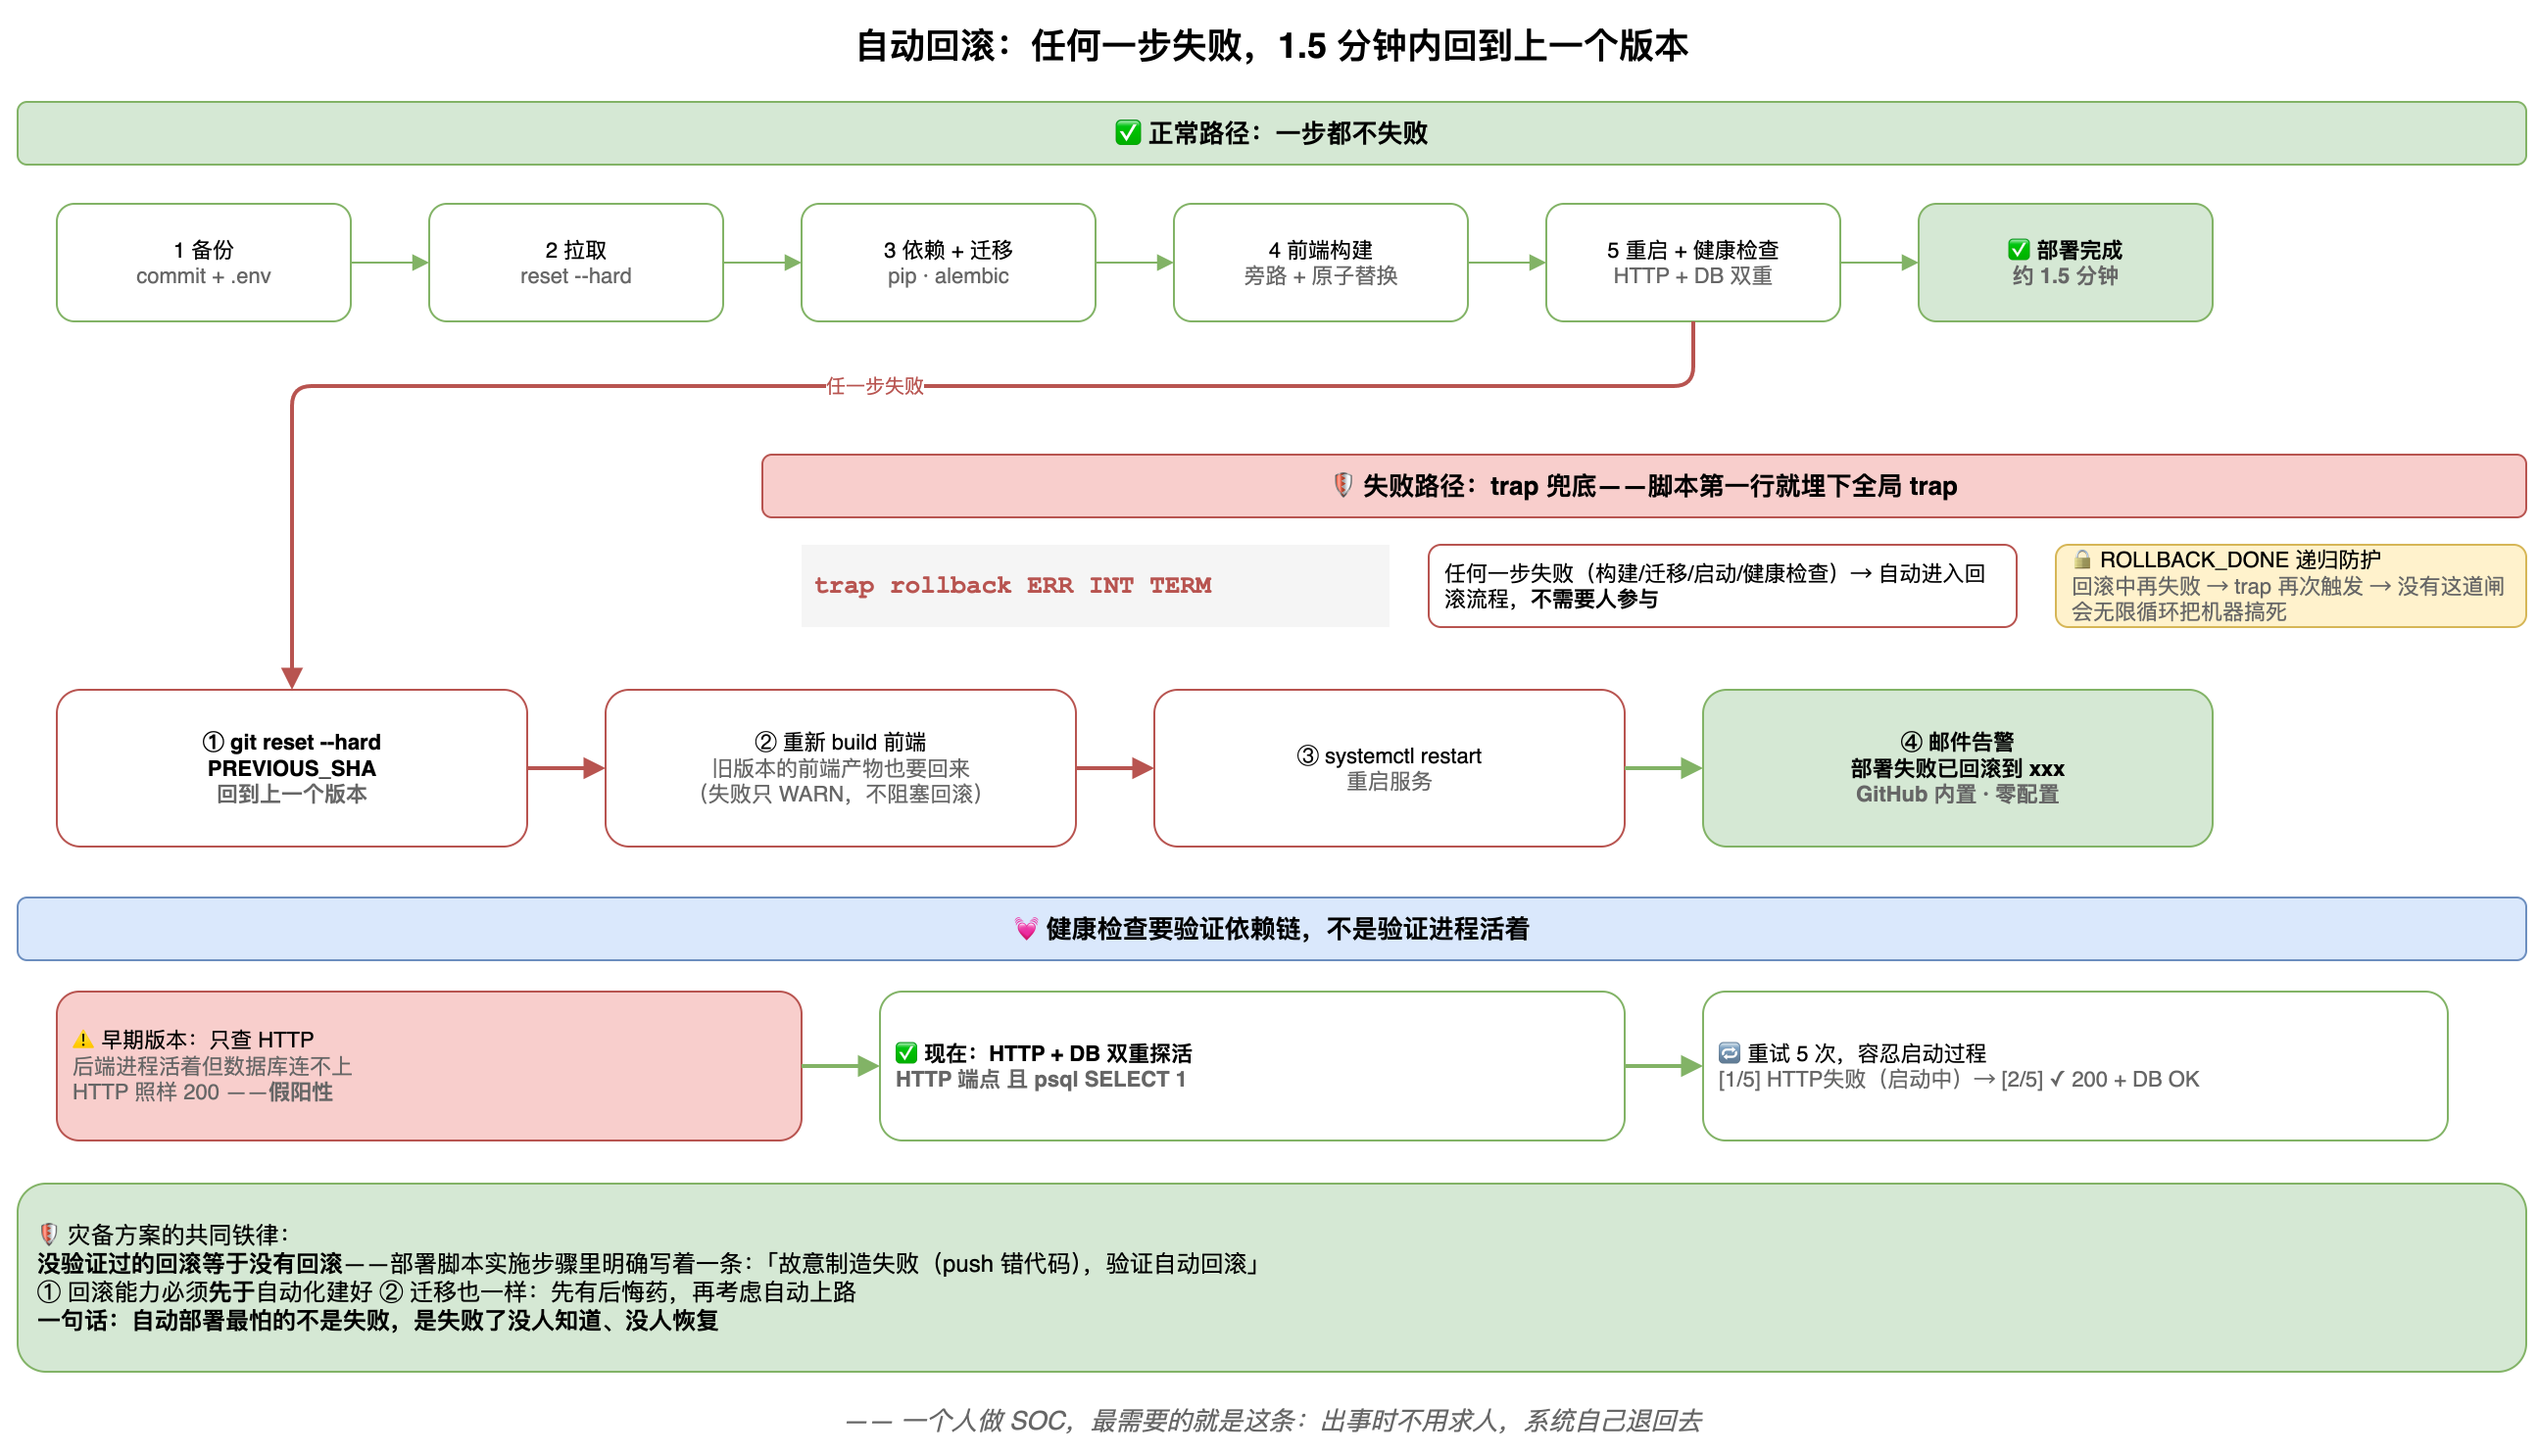
部署脚本第一行就埋下全局 trap:
| |
任何一步失败(构建失败、迁移失败、启动失败、健康检查不过),自动进入回滚流程:
① git reset --hard <PREVIOUS_SHA>   回到上一个版本
② 重新 build 前端                     旧版本的前端产物也要回来
③ systemctl restart aisoc-backend   重启服务
④ 邮件通知                           你收到"部署失败已回滚"
脚本注释里有个细节值得抄——回滚也要防递归:
| |
回滚过程中如果再失败,trap 会被再次触发——没有这道闸,回滚失败会无限循环把机器搞死。
3.2 健康检查:两道探活,不只看 HTTP
早期版本只检查 HTTP 端点,评审指出这是假阳性风险:后端进程活着但数据库连不上,HTTP 照样返回 200——看起来部署成功,实际上所有接口都在报错。
改法:HTTP + DB 双重探活,且不是一次过就完事,是重试若干次(服务启动需要时间):
健康检查:[1/5] HTTP失败(启动中)→ [2/5] ✓ HTTP 200 + DB SELECT 1 OK
注意第一次失败是正常的(服务还在起)。健康检查必须容忍启动过程——这也解释了为什么它要重试 5 次而不是只判一次。
3.3 前端原子替换:为了那 80 秒的 403
这个坑值得单独讲,因为它是真实把生产打挂过的一次。
nginx 的 root 直接指向前端 dist 目录。最早的部署写法是"先 mv 走旧 dist → 再 build"——顺序上很自然,但后果是:build 的那几十秒里,dist 目录不存在,全站 403。
实测部署 #65 期间前端 403 约 80 秒。
修法是"旁路构建 + 原子替换":
build → dist.new(dist 完全不动,服务照常跑旧版本)
     → mv dist dist.old
     → mv dist.new dist        ← 同文件系统 rename,窗口微秒级
     → rm -rf dist.old
两个约束同时满足:旧 chunk 不堆积(vite 没开 emptyOutDir,原地 build 会让历次产物永久累积,排查时还会被误导——部署 #62 就被这个误导过),build 期间服务不中断(dist 始终存在)。
四、效果如何:跑起来是什么样
4.1 一次部署的实际节奏
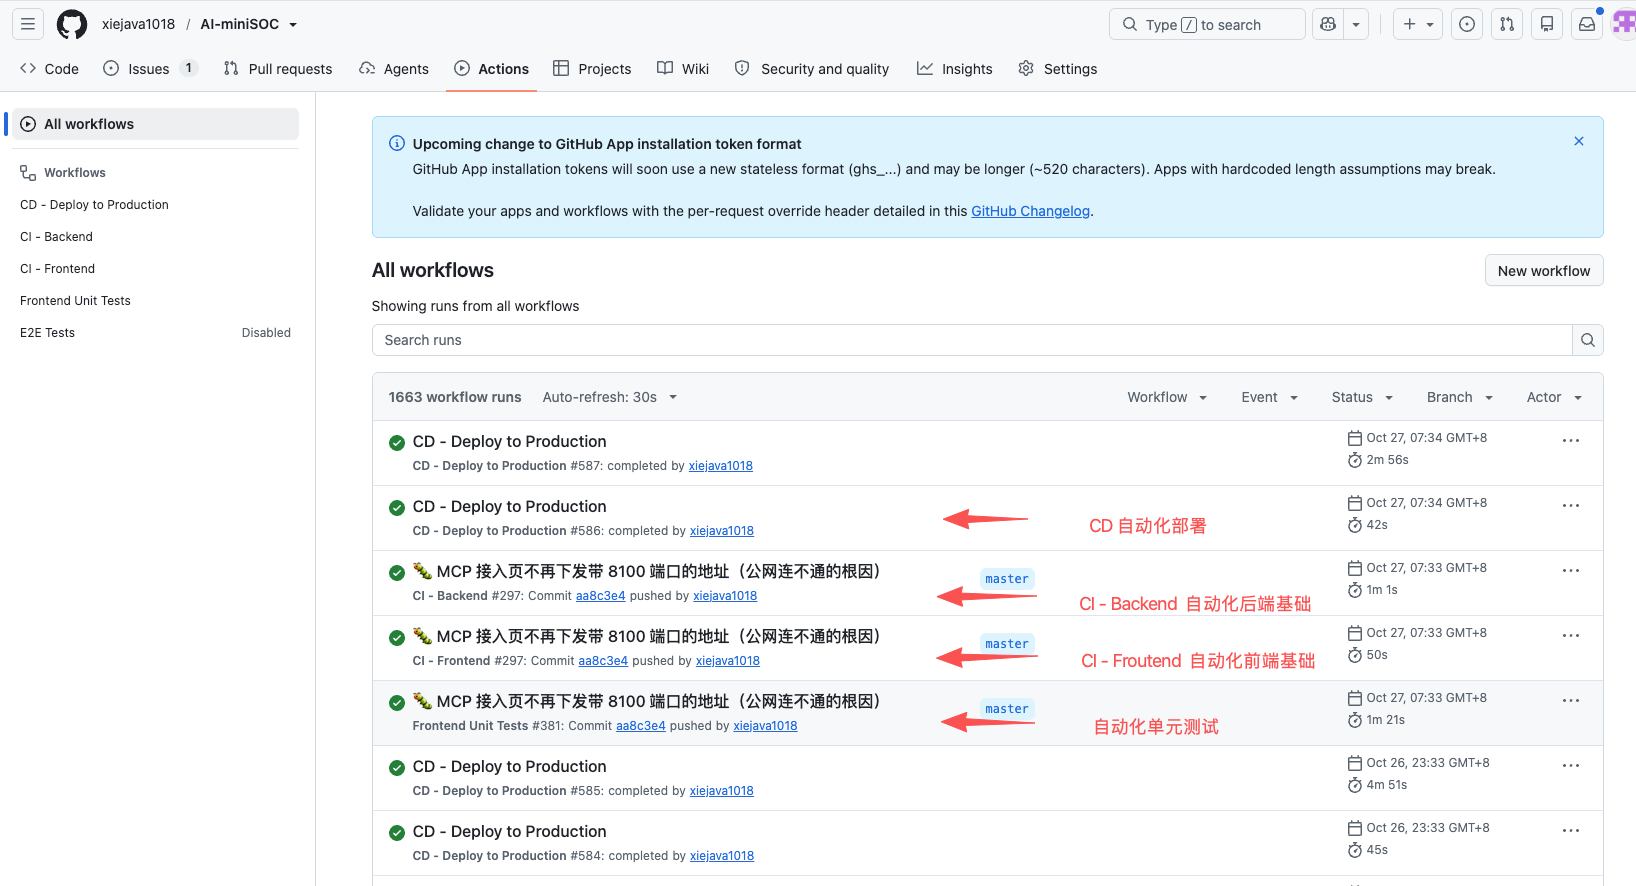
打开仓库的 Actions 页面——左侧是六条 workflow,右侧是运行记录。CD(Deploy to Production)和 CI(Backend / Frontend / Unit Tests)各自独立成列,一眼能看出谁在跑、谁绿了谁红了:
点开一次成功的 CD 部署,每一步的耗时都摊开给你看——这是最实用的一张图:一眼看出时间花在哪:
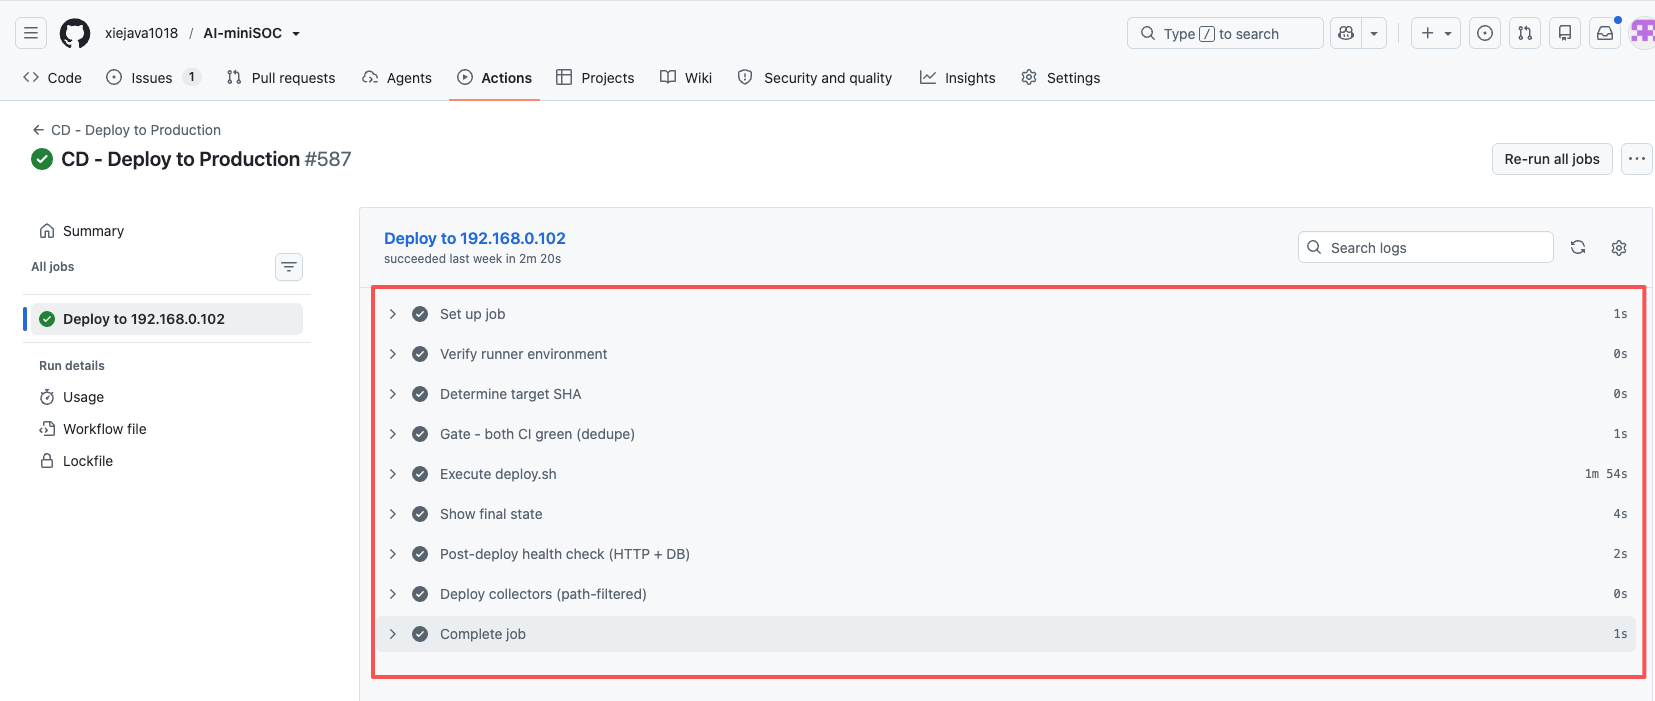
几个值得看的细节:
- “Gate - both CI green (dedupe)” 这一步只花 1 秒——CD 确实是在等 CI 全绿才启动,不是"合并即部署"
- “Execute deploy.sh” 占了 1 分 54 秒,其他步骤加起来不到 10 秒——部署时间几乎全在这一个步骤里(拉代码、装依赖、跑迁移、build 前端、重启、健康检查)
- “Post-deploy health check (HTTP + DB)” 2 秒——就是 3.2 节说的双重探活
- “Deploy collectors (path-filtered)” 0 秒——采集器走路径过滤,没有变更就不部署
从上面运行列表能看到 CD 的实际耗时在 42 秒到 2 分 56 秒 之间浮动——取决于这次改了多大。改个后端文案 40 秒,改动前端依赖就得两分多。
如果部署失败,GitHub 会立刻给你发邮件——内容是"哪次运行失败了、失败在哪个 commit",点进去就能看失败步骤的日志:
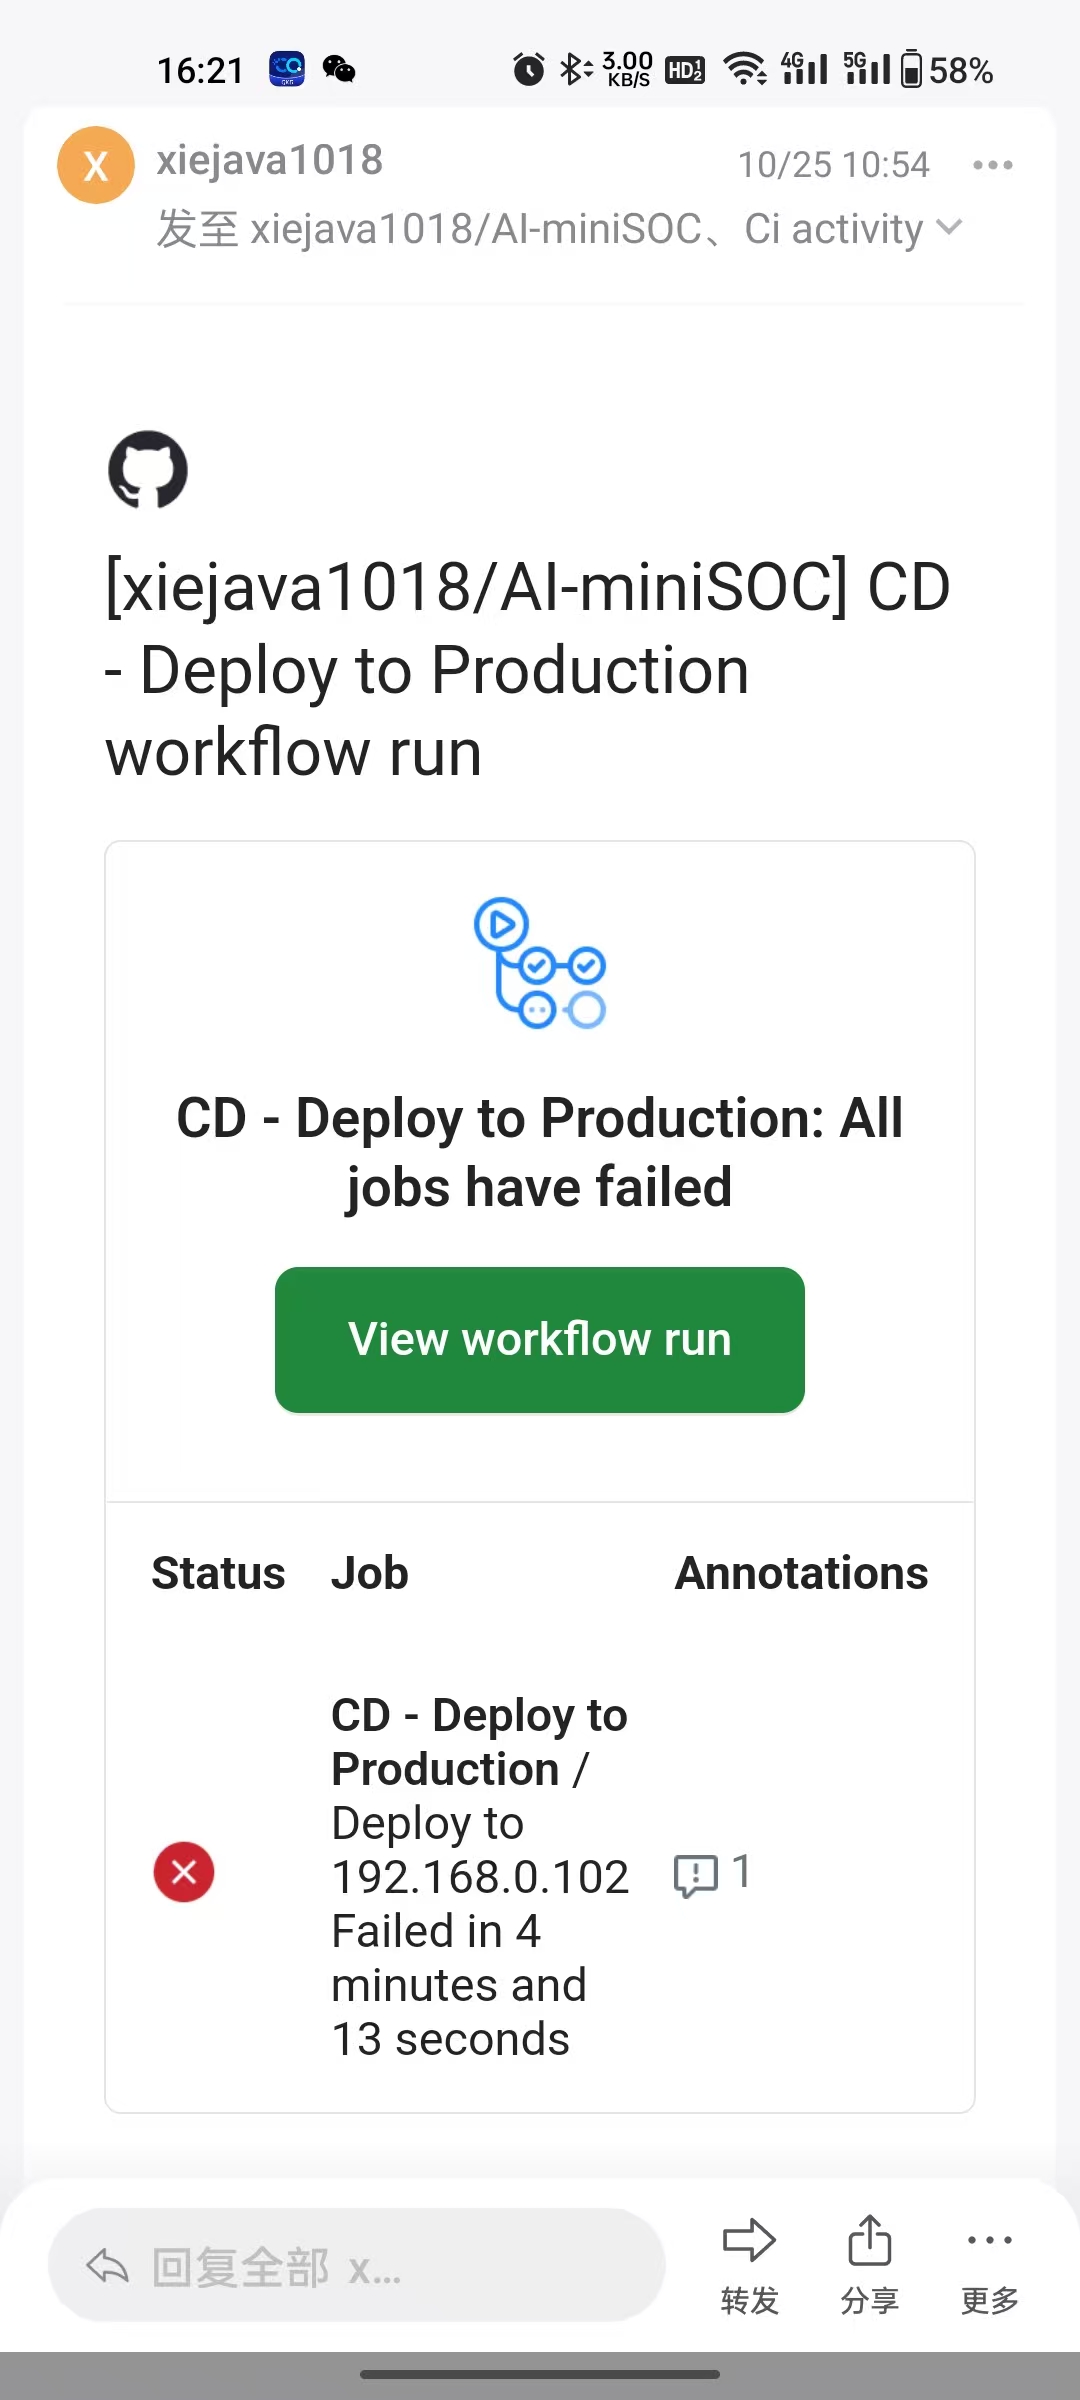
注意这封邮件是部署失败的通知(不是回滚成功的通知)——回滚成功的提示也在同一封邮件里。你不需要盯着屏幕等部署结果:要么成功要么回滚,两种情况都有邮件。
4.2 一条流水线上的三道关
CI 段不只是"跑测试",它拦的是三类问题:
| 检查 | 拦什么 | 状态 |
|---|---|---|
| 后端 pytest | 功能回归 | 阻断 |
| 前端 lint + typecheck | 类型错误、风格崩坏 | 阻断 |
| 38 个安全门禁(15 篇) | 权限写侧未授权、路由未分类、基线漂移 | 阻断 |
| e2e 测试 | 端到端流程 | advisory(不阻塞) |
| alembic check | 模型与迁移不一致 | advisory(已知 seed script 缺陷,暂不阻塞) |
advisory 与阻断的区别是这个流水线设计的核心:能自动判定对错的(测试挂了、权限漏了)就阻断;需要人判断的(e2e 偶发失败、迁移差异)只告警。把不确定的信号当门禁用,工程师很快就会习惯性地忽略红灯——那才是真正的门禁失效。
4.3 还没做完的(诚实交代)
这套东西也有明确没做完的部分:
alembic check因一个历史 seed script 假设了手工 ALTER 加的列,暂时只能 advisory- e2e 测试长期 queued 不阻塞
- 权限门禁里有一部分 pytest 仍是 advisory 探测
写清楚"哪些还没做",比宣称"全自动化了"更有用——读者能判断哪些能信、哪些要自己盯。
踩坑记录:五个真实翻车点
坑一:v2.0 的 runner 方案根本跑不通。 选了"托管 runner + SSH 到内网",公网路由不到 192.168.0.102——方案层面的错误,不是配置错误。评审一句话点破:“私网 IP 不可路由”。教训:涉及网络的方案,先验证连通性再谈配置。
坑二:前端 403 持续 80 秒(部署 #65)。 “先 mv 走旧 dist 再 build"的自然写法,打挂了生产。修法是旁路构建 + 原子替换。教训:部署脚本里每个"看起来无害的顺序"都可能改变服务语义——尤其当 nginx 直接指向构建产物目录。
坑三:健康检查假阳性。 只查 HTTP 200,后端活着但数据库连不上也算"部署成功”。修法是 HTTP + DB 双重探活 + 重试容忍启动过程。教训:健康检查要验证依赖链,不是验证进程活着。
坑四:pyjwt 依赖冲突(ResolutionImpossible)。 zhipuai>=2.1.5 要求 pyjwt<2.9.0,但 pip 解析不出可行解。修法是 --no-deps 单独装 zhipuai 再补齐其余依赖。教训:国产 SDK 的依赖树往往没跟上生态——遇到解析失败,先看是哪条约束冲突,别急着换库。
坑五:部署 #62 被旧 chunk 误导。 vite 没开 emptyOutDir,历次构建的旧 chunk 永久堆积在 dist 里,排查时以为"当前生效的是哪个构建"根本判断不出来。修法是每次 build 到干净目录 + 原子替换。教训:构建产物的可诊断性和可部署性一样重要。
怎么给我的系统上一套(最小可行路径)
不要一上来就抄全套。四个阶段,每个阶段独立有价值:
阶段 1:先有 CI(半天)——把现有测试挂到 GitHub Actions 上。哪怕只是"跑 pytest 不挂",也比不跑强。
阶段 2:把服务交给 systemd(1 小时)——写一个 unit 文件,systemctl restart 取代 nohup。这一步不涉及自动化,但它是后面所有自动化的地基——没有 systemd,CD 就没有"重启服务"这个动作可用。
阶段 3:先做回滚,再做自动化(2 小时)——顺序不能反。手写一个部署脚本,第一件事是 trap 回滚:记住上一个 commit,任何步骤失败就 git reset --hard 回去。手动跑几次确认它真的能回滚,再把它挂到 CI 上。没有回滚能力的自动部署,是把手动部署的频率提高了 10 倍。
阶段 4:接上流水线(半天)——CI 全绿触发 CD,CD 在目标机上执行阶段 3 的脚本。
几个具体的坑要先知道:
- runner 装在目标服务器上,不是你的开发机
- CD 不监听
push,监听workflow_run(CI 成功事件) - 给自动化用的用户最小 sudo 权限,只允许重启那一个服务
- 数据库迁移不要一上来就自动化,先让 DBA 手动跑几次
常见问题
Q:一个人做 CI/CD 是不是浪费时间?
A:看你怎么用。如果只是"每次部署花 5 分钟手动搞",一年也就几十次——确实不值。但真正的成本不在部署本身,在部署出错的那些次:排查、回滚、找"上次好的版本是哪次"。这套东西的全部价值都在"出事的时候"兑现。而一个人做 SOC,出事的时候只有你。
Q:GitHub Actions 免费吗?个人项目够用吗?
A:个人仓库有免费额度(公开仓库无限),自托管 runner 不消耗托管额度——反正部署本来就得在你自己机器上跑。
Q:为什么不用 Jenkins / GitLab CI?
A:一个人维护 Jenkins 是另一个需要人照看的系统(插件升级、配置备份、它自己也会挂)。GitHub Actions 零运维,代价是必须用 GitHub——对开源项目这不是问题。
Q:怎么确保自动回滚真的有效,而不是摆设?
A:故意部署一个坏版本。这是部署脚本实施步骤里明确写的一条:“故意制造失败(push 错代码),验证自动回滚”。没验证过的回滚等于没有回滚——这是所有灾备方案的共同铁律。
Q:部署失败的通知走哪里?
A:GitHub Actions 内置邮件,commit 作者 + repo watchers 自动收到,零配置、不用建机器人、不用保管 webhook。代价是不够即时(可能进垃圾箱)——个人项目这个取舍完全够用。
Q:这套和 15 篇的权限门禁什么关系?
A:15 篇那 38 个安全测试就挂在 CI 上,是阻断式门禁的一部分。权限设计在代码里,权限门禁在流水线里——两者合起来才是"防复发"的完整闭环:设计时默认拒绝,合并时自动拦截。
收尾:16 在系列中的位置
| 系列主线 | 篇目 |
|---|---|
| AI 副手五部曲 | 09-13 |
| 工程化·告警治理 | 14 |
| 工程化·权限矩阵 | 15 |
| 工程化·CI/CD(总装线) | 16(本篇) |
14 篇守住注意力,15 篇守住信任边界,16 篇把这些工程化成果接到流水线上——从此它们不再依赖你的记性和自觉,而是靠机器守住。
16 篇之后,工程化三件套齐了:告警不会淹掉你、权限不会漏掉、部署不会坏掉。
老李现在的发布流程是这样的:周五晚上写完一个功能,git push。 手机收到邮件:“CI - Backend ✅ / CI - Frontend ✅"。 一分钟后第二封:“CD - Deploy to 192.168.0.102 ✅ 1m32s”。 他去泡了碗面,回来时生产已经是新的了。 那天晚上他确实推错了一个 commit——但他是在测试环境推错的, 生产在两分钟前就自动回到了上一个稳定版本,邮件里写着"部署失败,已回滚到 6082cc4”。 他什么都没查,只是把那个 commit revert 了。
一个人的 SOC,不需要一个运维团队,但需要一台不会胡来的流水线。
【系列导航】《一个人的SOC》总目录(持续更新)
【上一篇】(15) 权限矩阵——admin/operator/viewer/auditor 端点级隔离
【系列开篇】(00) 中小企业为什么需要自己的安全运营中心
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐
【Gitee 镜像】 https://gitee.com/xiejava/AI-miniSOC
【交流】 你的部署还是"push + 祈祷没坏"吗?经历过最惊心动魄的一次上线事故是什么?欢迎来 Issue 对答案。
下一篇(预告):(17) 成本账本——运行一年 AI-miniSOC 的真实开销(连载中,敬请关注)
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!