上一篇里,老李问出了所有中小企业 IT 人的三个问题:为什么非做不可、路有几条、凭什么一个人做得动。我们得到的答案是:一台 8G 内存的旧服务器 + 开源组件 + AI,就够搭一个真正能用的 SOC。
那么这一篇,回答下一个必然的问题:
8G 内存,凭什么装得下一个"安全运营中心"?这玩意儿听起来就是一面大屏 + 一屋子服务器的存在啊。
答案是四个字:架构取舍。SOC 不是"东西越多越强",而是"每个组件刚好够用"。这篇文章我把 AI-miniSOC 的总体架构完整摊开给你看——不晒技术栈凑数,而是把每个选型决策背后的"为什么"讲透。看懂了这些取舍,你以后做任何技术选型都用得上;看完直接照着搭,就是下一篇的事。
一、先看全景:一张图读懂四层结构
老规矩,先上总体架构图,后面逐层拆:
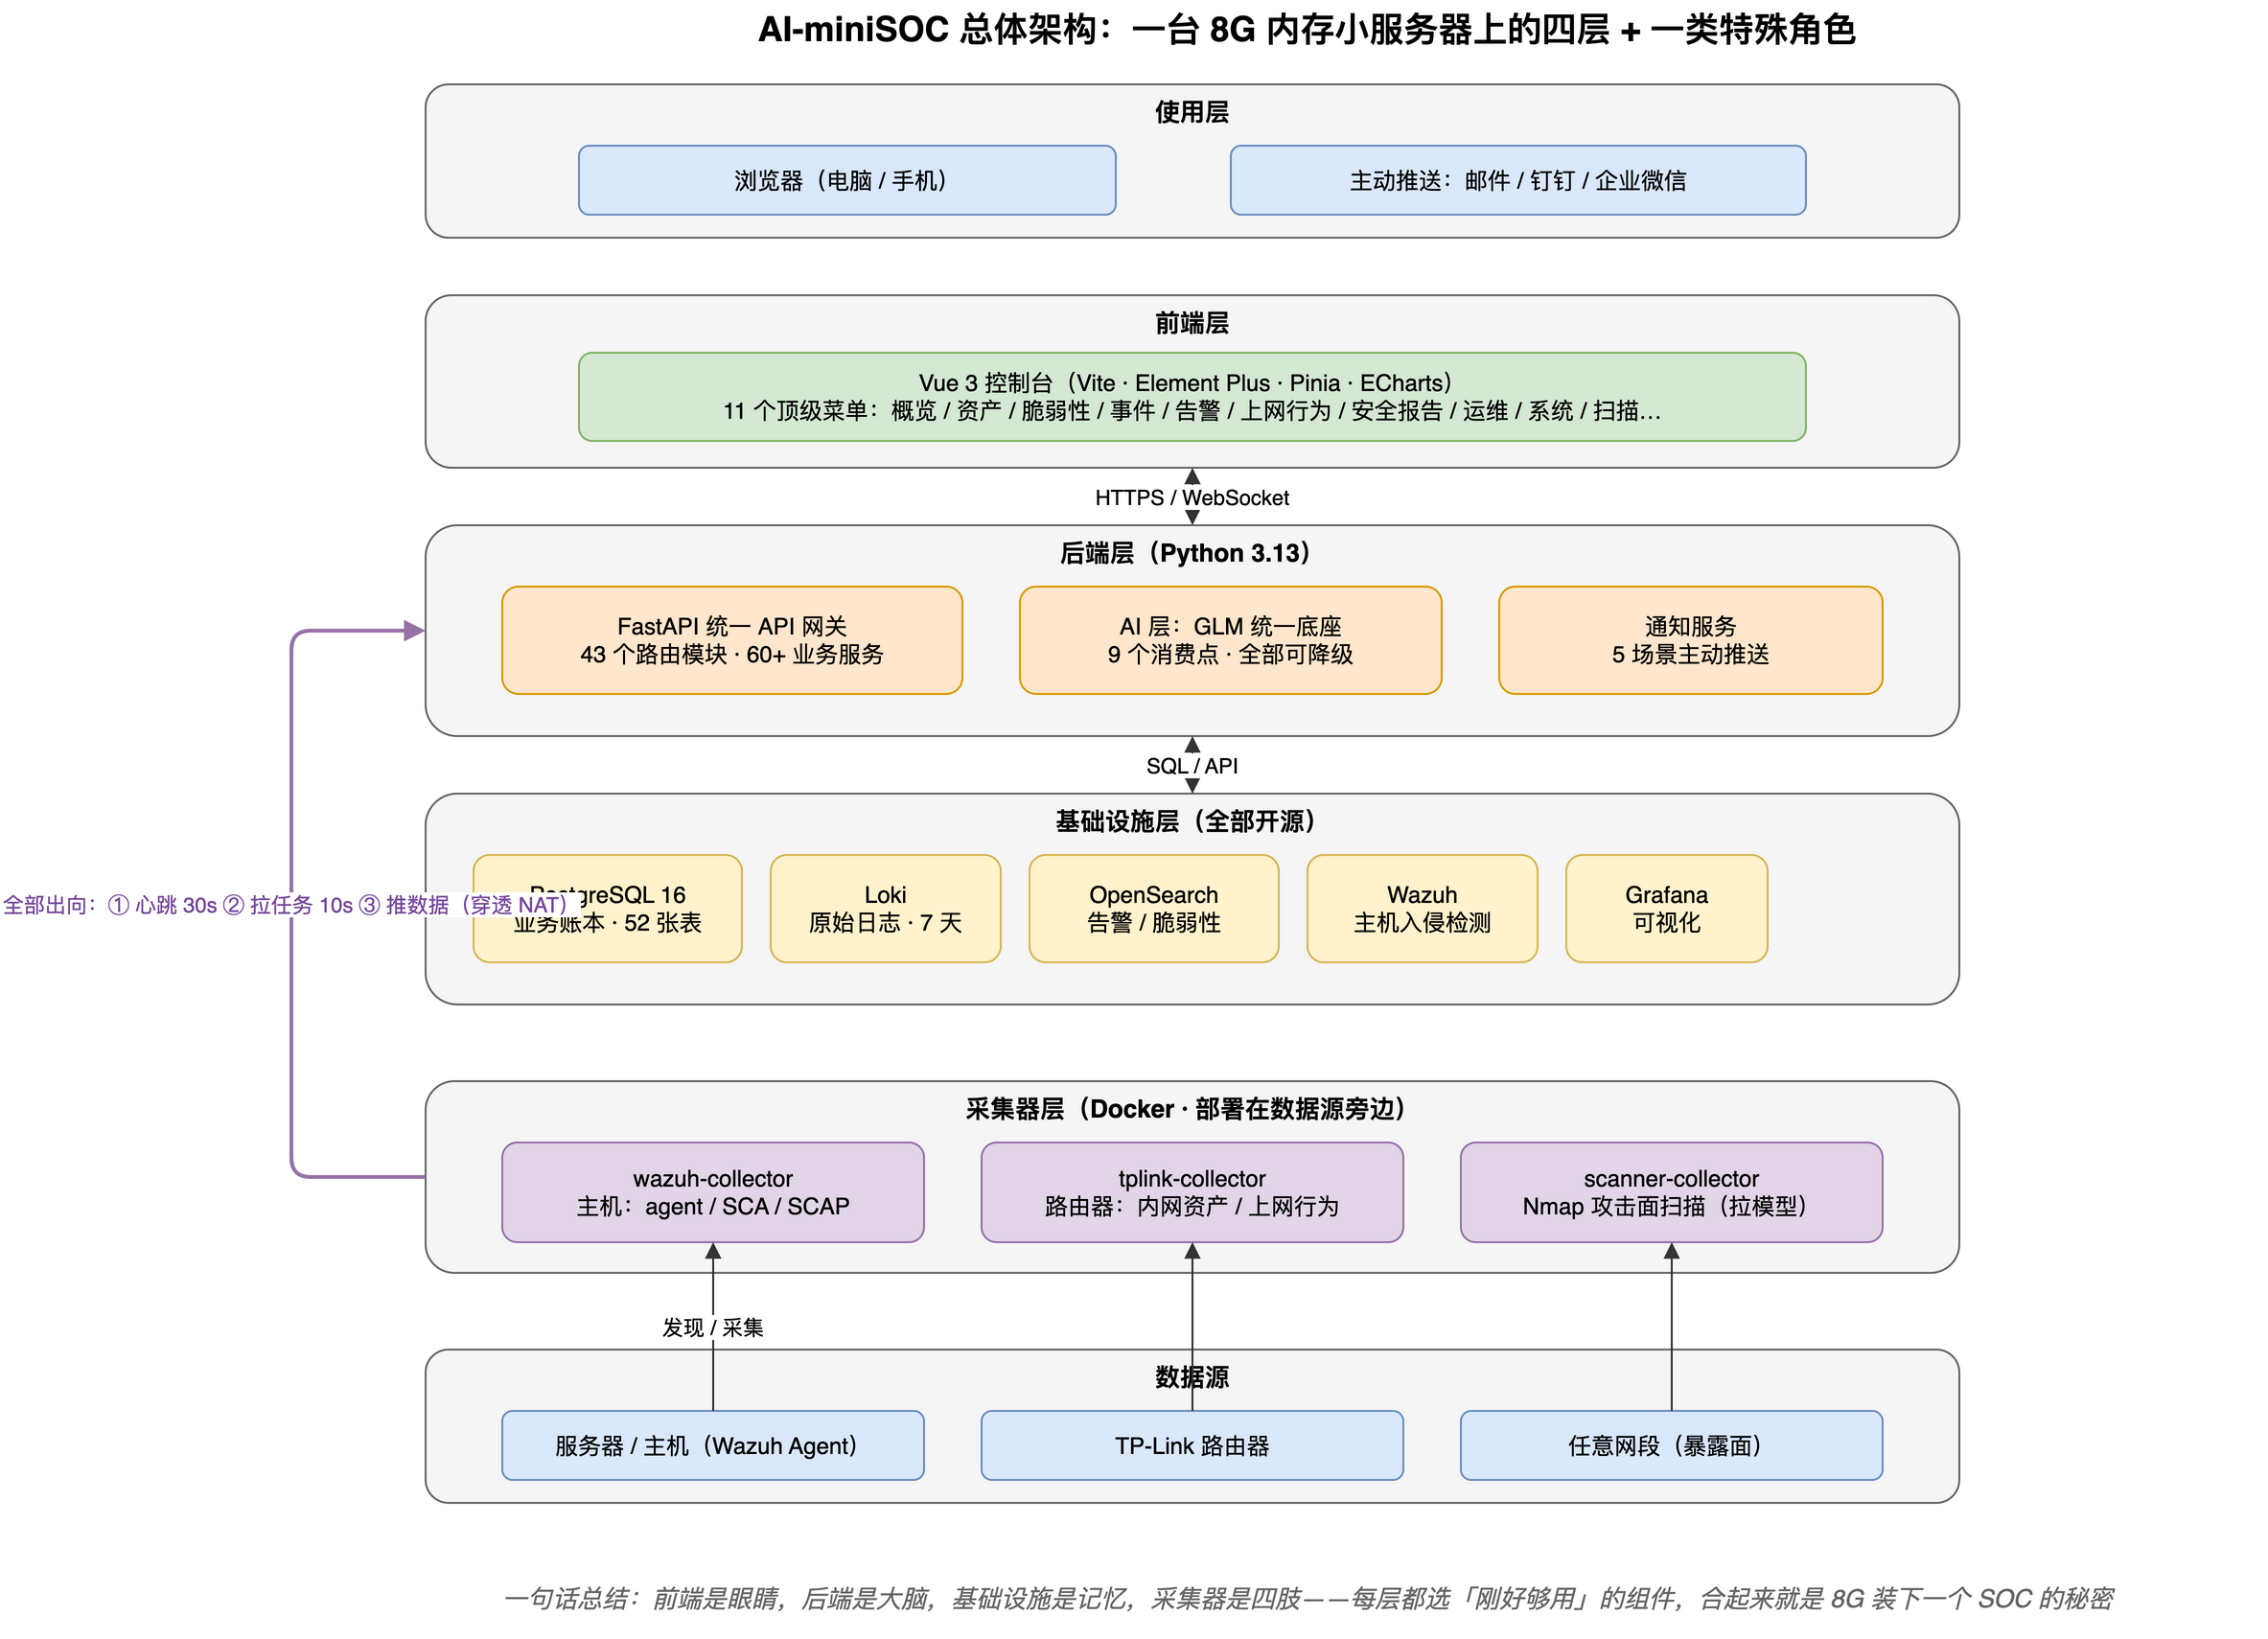
从上到下五段,每层一句话职责:
| 层 | 跑什么 | 一句话职责 |
|---|---|---|
| 使用层 | 浏览器(电脑/手机)+ 邮件/钉钉/企微推送 | 你和老板接触系统的两个入口 |
| 前端层 | Vue 3 控制台(Vite + Element Plus + ECharts) | 眼睛——11 个菜单管全公司安全 |
| 后端层 | FastAPI(Python 3.13):43 个路由模块、60+ 业务服务、AI 层、通知服务 | 大脑——所有业务逻辑在这 |
| 基础设施层 | PostgreSQL / Loki / OpenSearch / Wazuh / Grafana | 记忆——数据各就各位 |
| 采集器层 | 3 个 Docker 容器化的采集器 | 四肢——伸到数据源旁边去拿数据 |
几个数字你可能没什么概念,我翻译一下:43 个 API 路由模块、52 张数据库表、60+ 业务服务——这是一个正儿八经的平台级系统的体量,不是脚本拼凑的玩具。而这些东西的全部基础设施,跑在一台 8G 内存的机器上。
怎么做到的?下面是本文的主菜:三个关键取舍。
二、取舍一:日志分级存储——为什么是 Loki 而不是 ELK?
这是最省钱的一个决策,先想清楚它。
搭 SOC 的第一反应往往是:上 ELK(Elasticsearch + Logstash + Kibana)——网上的教程全是它,行业里也最出名。但 ELK 有个要命的特点:它索引一切。每一条日志的正文都要建立全文索引,索引本身和原始日志几乎等量,而 Elasticsearch 是 Java 程序,JVM 起步就是 4G 内存——你一台 8G 的机器,装一个 Elasticsearch 就满了,别的什么都不用跑了。
我的做法是把"日志"这个笼统的东西拆成三类,区别对待:
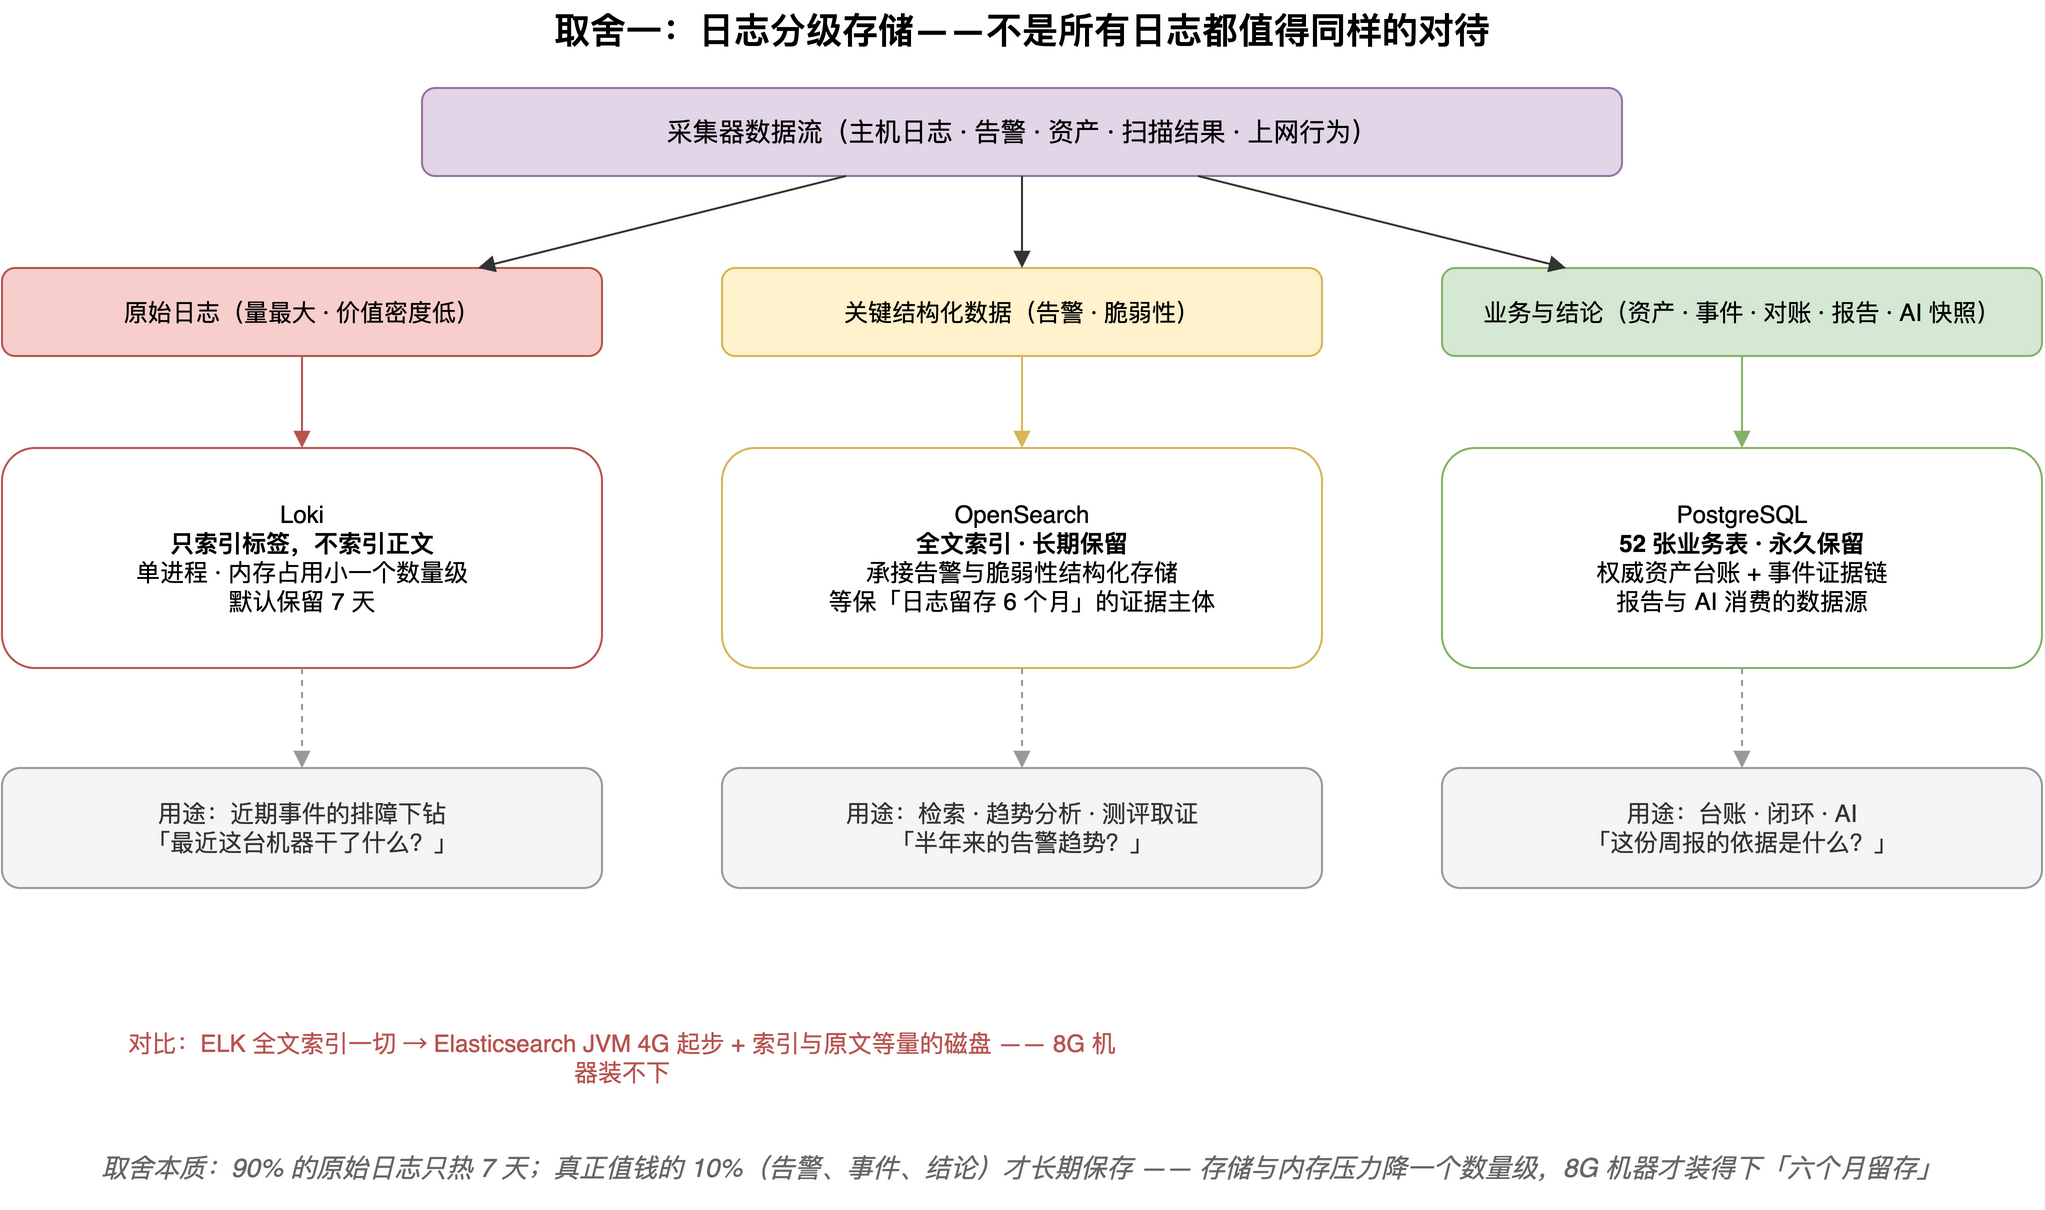
| 数据类型 | 量级 | 存哪 | 留多久 | 为什么 |
|---|---|---|---|---|
| 原始日志(主机操作、网络流量记录) | 最大,占 90%+ | Loki | 7 天 | 只索引标签不索引正文,内存占用小一个数量级 |
| 告警与脆弱性(Wazuh 告警、漏扫结果) | 中等 | OpenSearch | 长期 | 结构化、要全文检索——这是等保"留存 6 个月"的证据主体 |
| 业务与结论(资产台账、事件、报告、AI 快照) | 小,但最值钱 | PostgreSQL | 永久 | 权威账本,52 张表,事件闭环的证据链 |
这个分法背后的洞察是:出了事要排查的原始日志,热度只有最近几天;而真正需要长期留存的,是已经被提炼过的结构化数据(告警)和业务结论(事件、报告)。 90% 的原始日志 7 天后就没用了——为它们付出全文索引的成本,纯属浪费。
等保要求"日志留存不少于六个月"怎么办?留存的是 OpenSearch 里的告警记录和 PostgreSQL 里的处置闭环,它们本来就是日志中真正有取证价值的部分。原始流水日志超期覆盖,是业界通行做法(商业 SOC 的原始日志留存窗口通常也不长)。
类比:Loki 是"监控录像"(7 天循环覆盖,出了事调最近的看),OpenSearch + PostgreSQL 是"案底档案"(值得记录的永久在册)。派出所不需要保存全城每一天每一秒的录像,但需要每一起案件的卷宗。
三、取舍二:拉模型采集——家庭宽带也能接入的秘密
第二个决策关系到一件很实际的事:你的数据源可能没有公网 IP。
场景很常见:公司拉的是普通宽带(NAT 后面,没有固定公网地址),家里更是如此。如果用传统"推模型"思路——服务端主动连到采集器去拉数据——你会发现根本连不进去:NAT 后面的机器对外不可见。要打通就得在路由器上开端口映射或搞内网穿透,家庭宽带办不到,而且在防火墙上开入站端口,本身就是给攻击者开门。
我的解法是把方向反过来——拉模型(Pull-based):
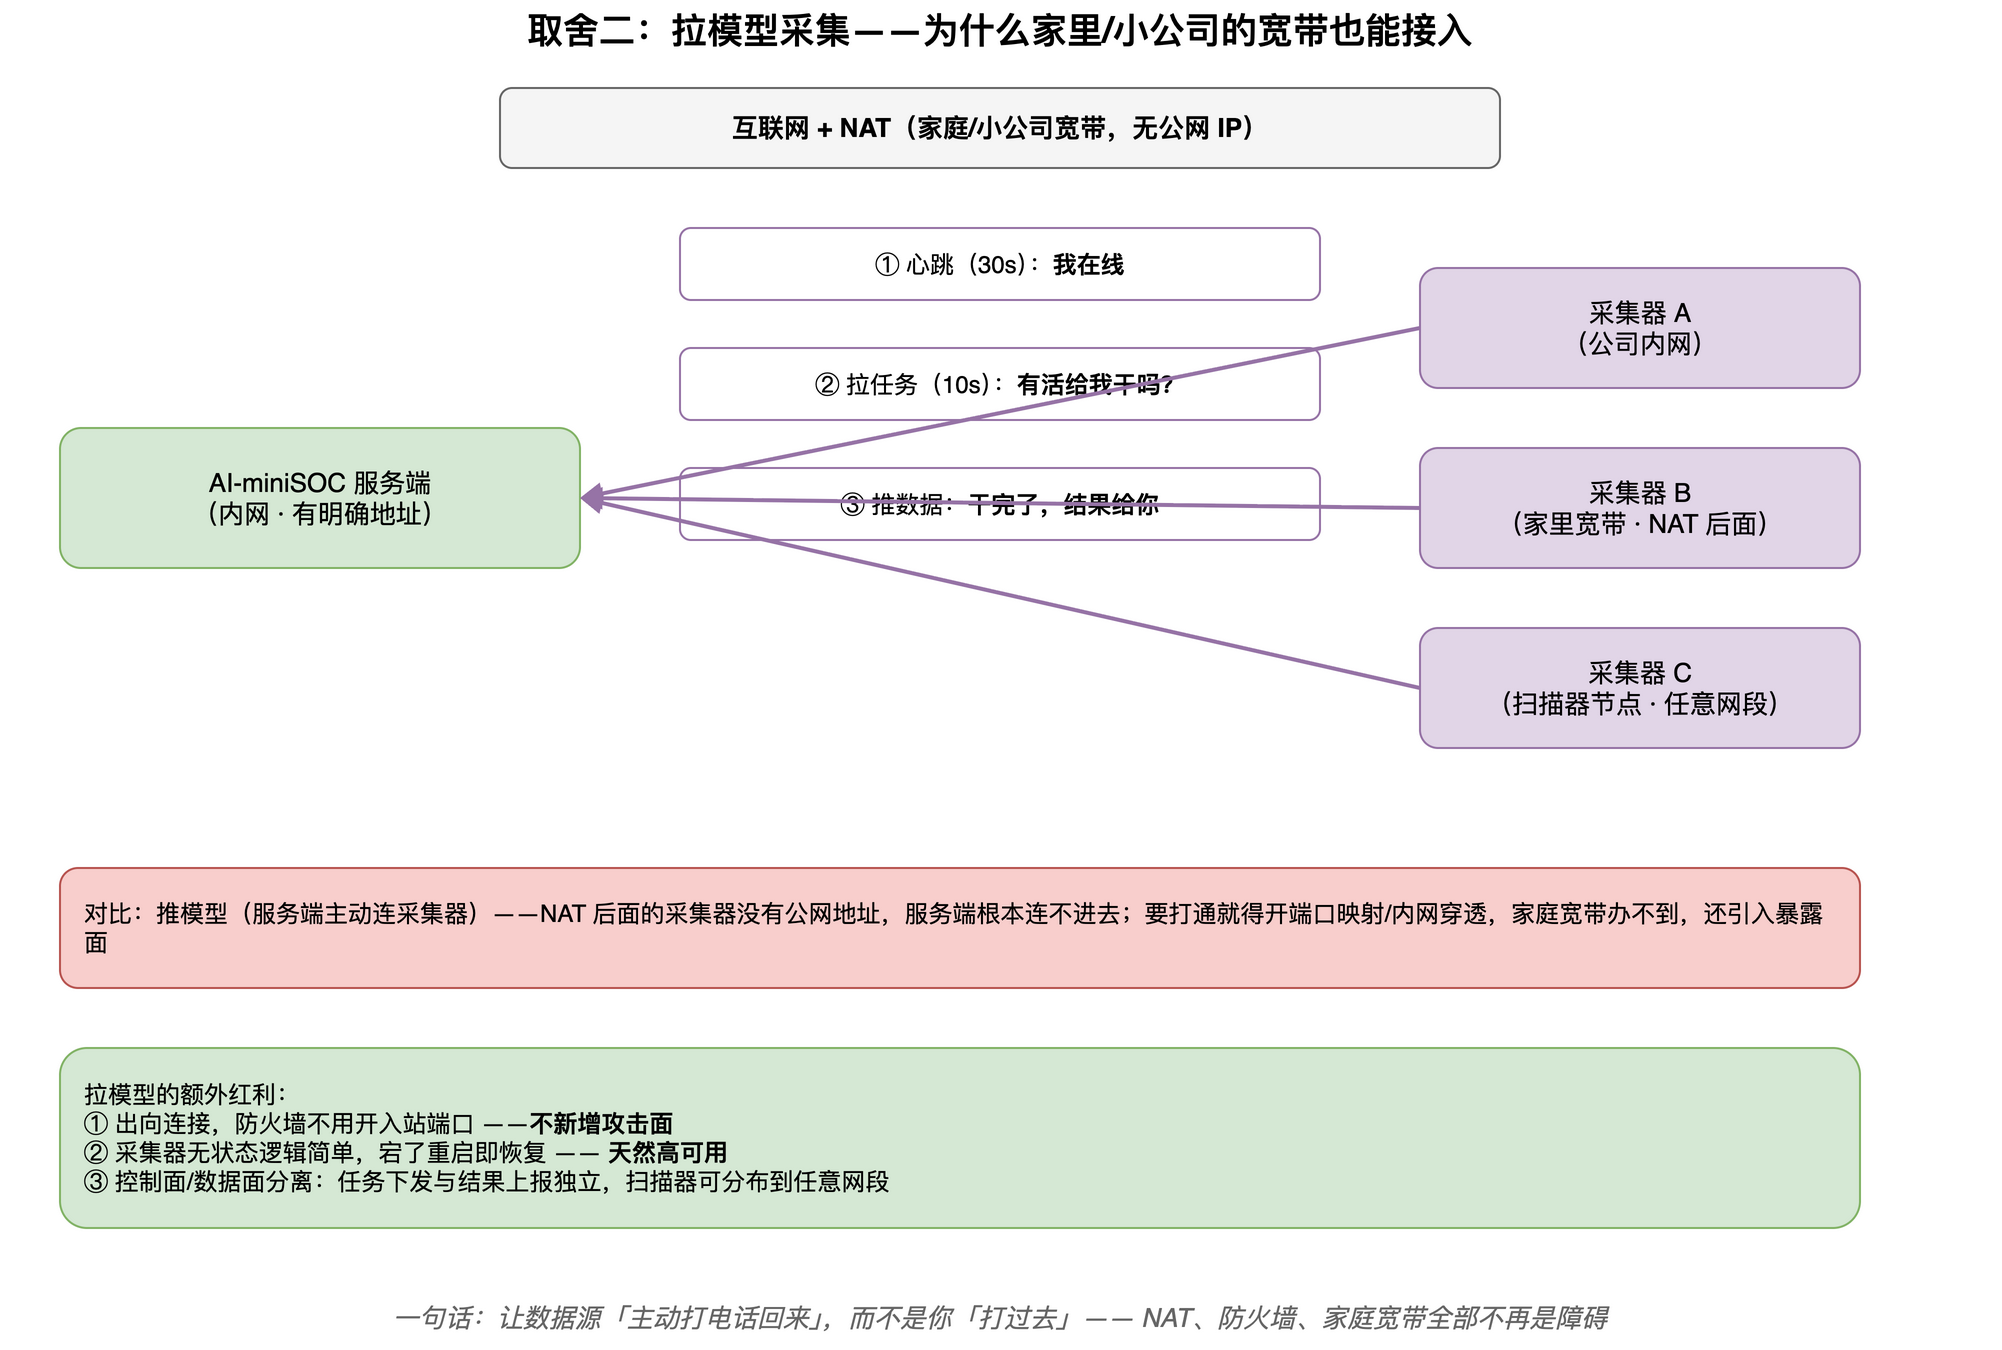
每个采集器只做三件事,全部是出向连接:
- 心跳(每 30 秒):“我还在线”——服务端据此判断采集器健康状态;
- 拉任务(每 10 秒):“有活给我干吗?"——扫描任务、同步指令都从这来;
- 推数据:“干完了,结果给你”——采集到的资产、日志、告警统一上报。
这个设计带来三个红利:
- NAT、防火墙统统不再是障碍——出向连接在内网环境永远畅通,公司、家里、分公司,什么地方都能接;
- 不新增攻击面——服务端不开任何入站端口给采集器;
- 天然高可用——采集器无状态、逻辑简单,断电重启后接着跑,不需要复杂的分布式协调。
另外它还实现了一个进阶设计:控制面/数据面分离。任务下发和结果上报是两条独立通道,所以攻击面扫描器可以部署到任意网段(比如放到 DMZ 去扫公网暴露面),而管理指令依然从统一控制面来。这个设计第 (05) 篇讲 Nmap 扫描器时会展开。
四、取舍三:AI 是"消费点"不是"中枢”——每个点都有降级路径
第三个决策最重要,也是这个项目名字里带"AI"的底气所在。
先泼一盆冷水:市面上大量"AI + 安全"产品,思路是把大模型放在系统中枢——告警进来先过模型、决策靠模型、甚至处置动作也模型说了算。听起来很酷,实际用起来有三个致命问题:模型 API 会挂会限流、模型会幻觉(安全场景零容忍)、模型会涨价。中枢一旦是 AI,AI 一抖,整个安全体系瘫痪。
我的做法反过来:确定性主干 + AI 消费点。
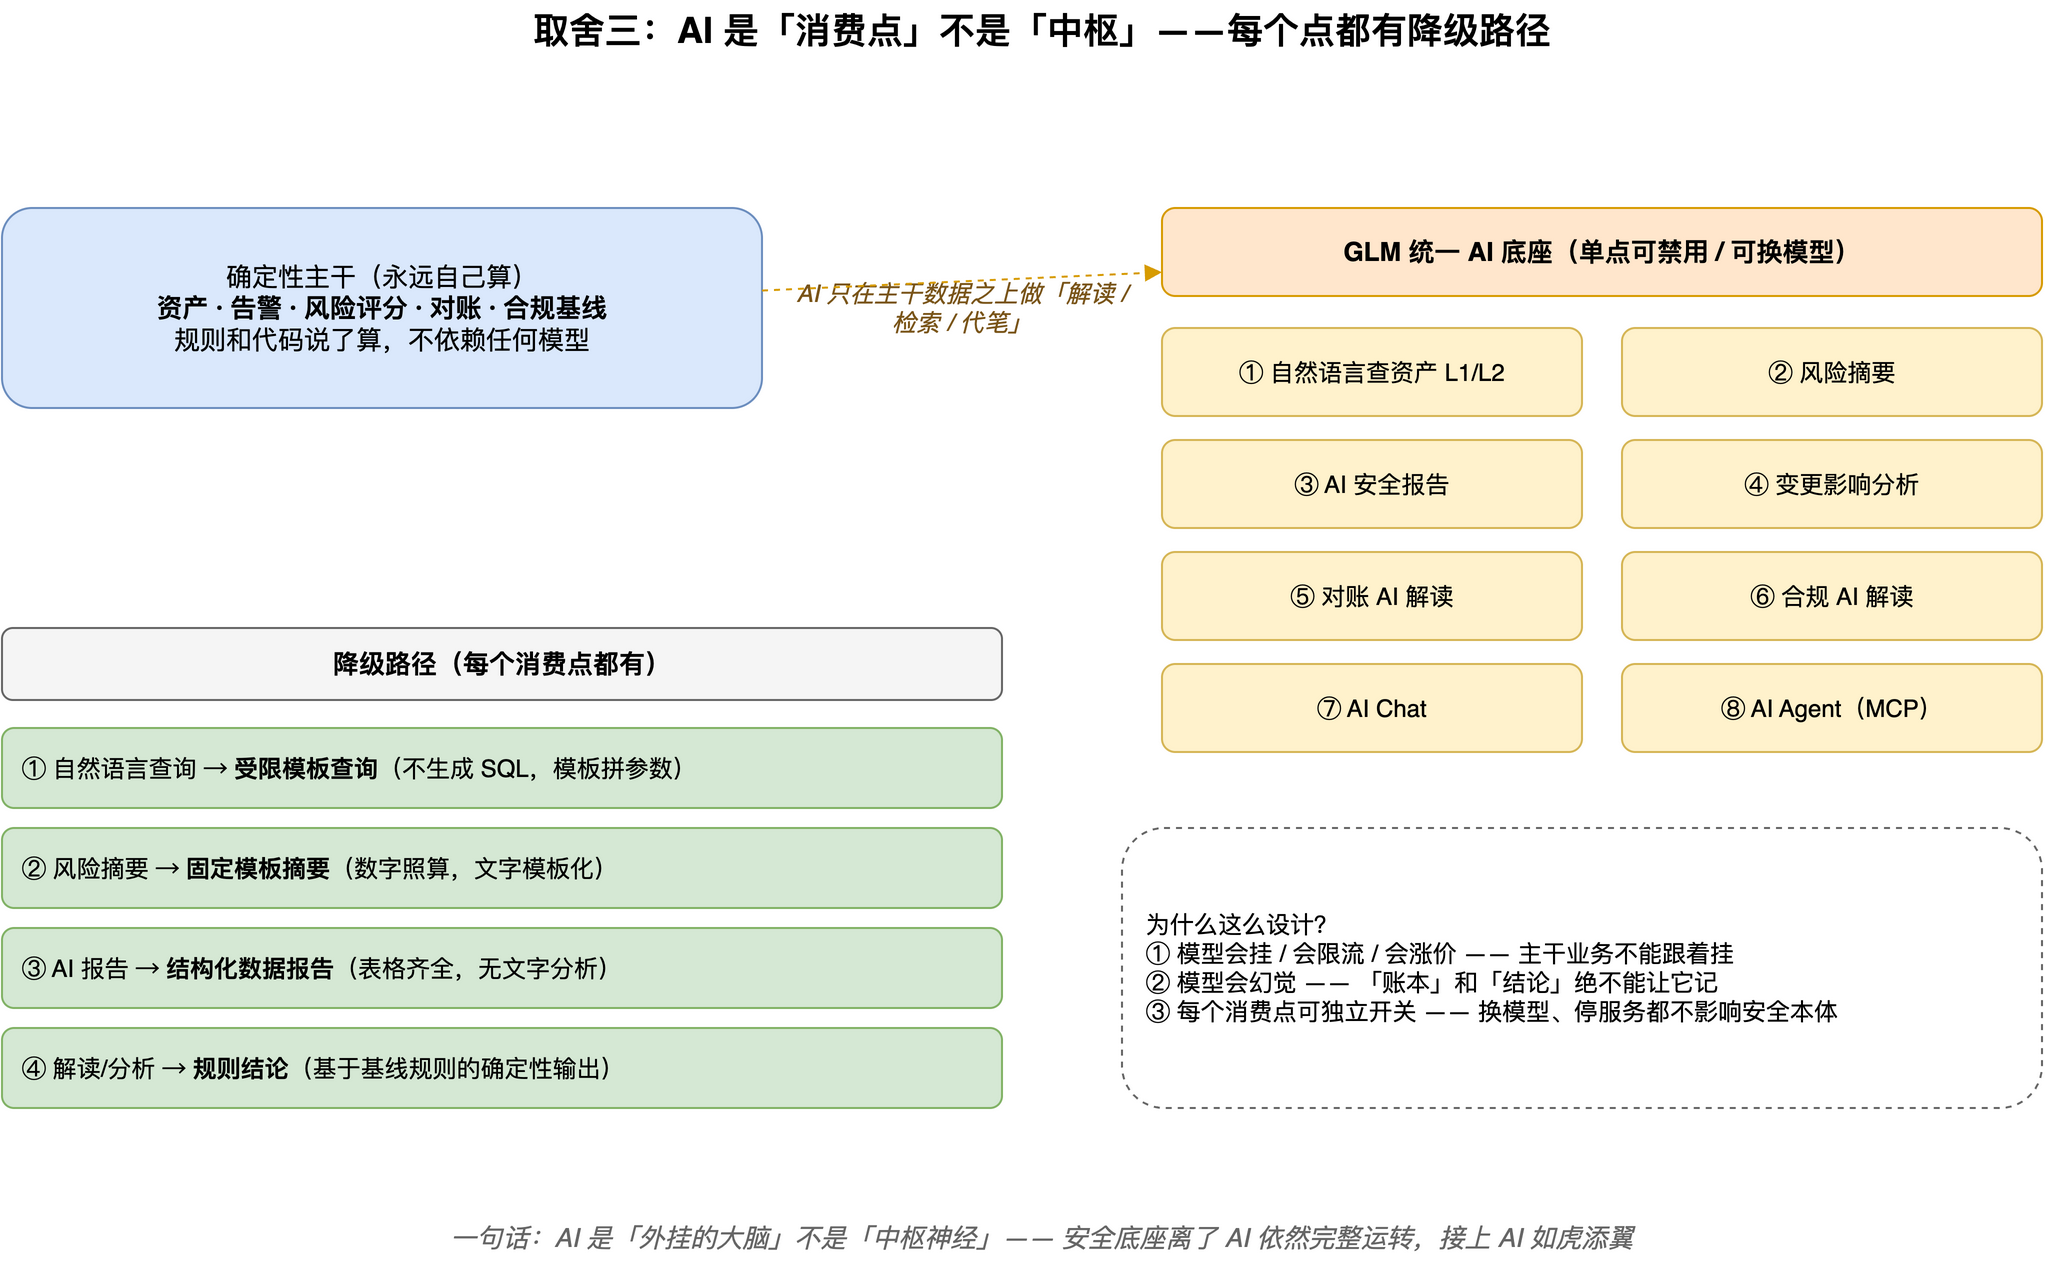
主干——资产台账、告警分级、风险评分、资产对账、合规基线——全部是规则和代码算出来的确定性结果,不依赖任何模型。这些是"账本"和"结论",一个数字都不能错。
AI——大模型底座(GLM或其他国产大模型) 统一底座之上挂了 9 个消费点(自然语言查资产、风险摘要、AI 安全报告、变更影响分析、对账解读、合规解读、AI Chat、AI Agent)——只做三类事:解读、检索、代笔。它让你的效率翻倍,但系统不指望它才能转。
最关键的是右下角那列:每个消费点都有明确的降级路径。模型挂了/限流了/你不想用了,自然语言查询退化为受限模板查询、AI 报告退化为结构化数据报告、风险摘要退化为固定模板——功能还在,只是少了那段"聪明话"。所有降级路径都经过真实演练,不是写在 PPT 上的。
这个话题(什么时候能信 AI、什么时候必须防着它)是整个系列最重要的主题之一,第 (11) 篇《诚实降级》会用一整篇展开。这里你只需要记住结论:
AI 是外挂的大脑,不是中枢神经。安全底座离了 AI 依然完整运转,接上 AI 如虎添翼。
五、账本与实景:资源占用 + 各层真实截图
架构讲完,回到最初的问题——8G 内存到底怎么装下的?空口无凭,直接看生产服务器的实测。free -h 和 docker stats 的输出的资源占用情况:
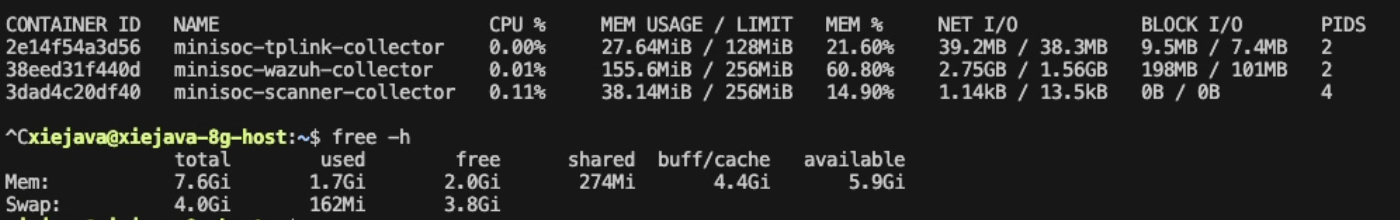
| 组件 | 角色 | 内存占用(实测参考) |
|---|---|---|
| PostgreSQL 16 | 业务账本 | 数百 MB |
| Loki | 日志聚合 | ~200 MB |
| OpenSearch | 告警/脆弱性 | 1~2 GB(可调) |
| Wazuh(Manager+Indexer) | 主机入侵检测 | ~2 GB |
| Grafana | 可视化 | ~200 MB |
| FastAPI 后端 | 业务大脑 | 数百 MB |
| nginx + 前端静态资源 | 控制台 | ~50 MB |
| 采集器(3 个容器) | 数据采集 | ~300 MB |
| 系统 + 余量 | — | ~1 GB |
| 合计 | ≈ 6 GB / 8 GB |
再逐层看实景,证明架构图不是纸上谈兵——
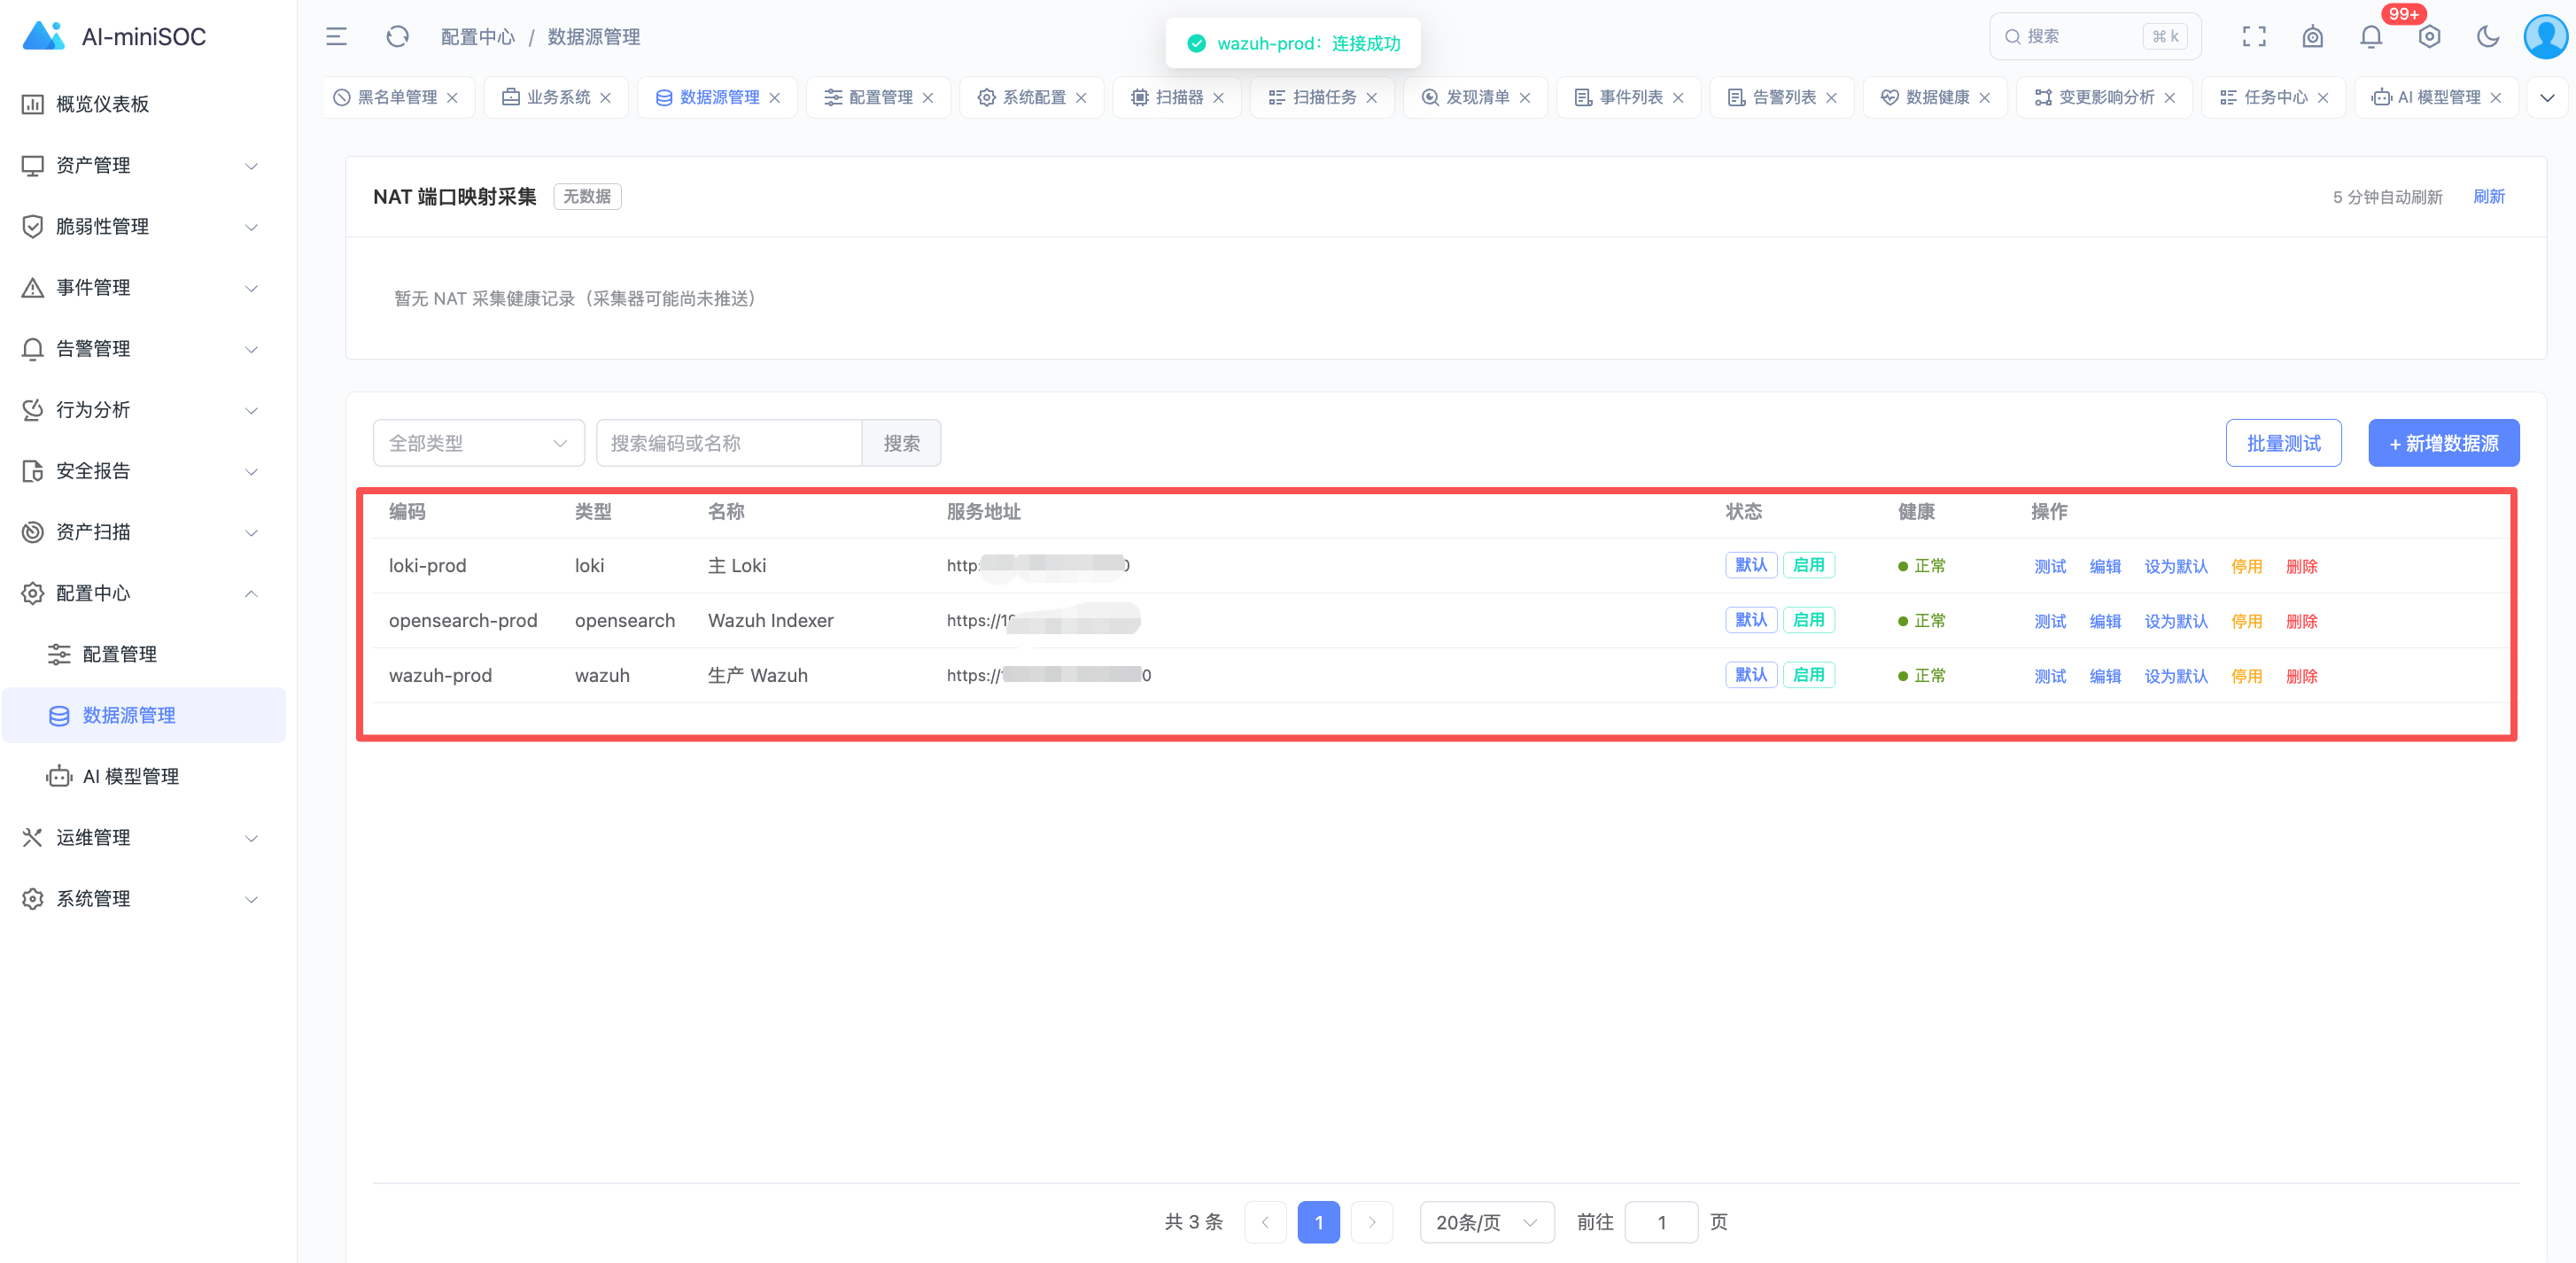
基础设施层·数据源管理:对接的各类数据源状态一目了然(Loki、OpenSearch、Wazuh),哪个组件掉线、哪条链路断了一屏可见——架构图里基础设施层那五个格子,在这里有了"体检表":
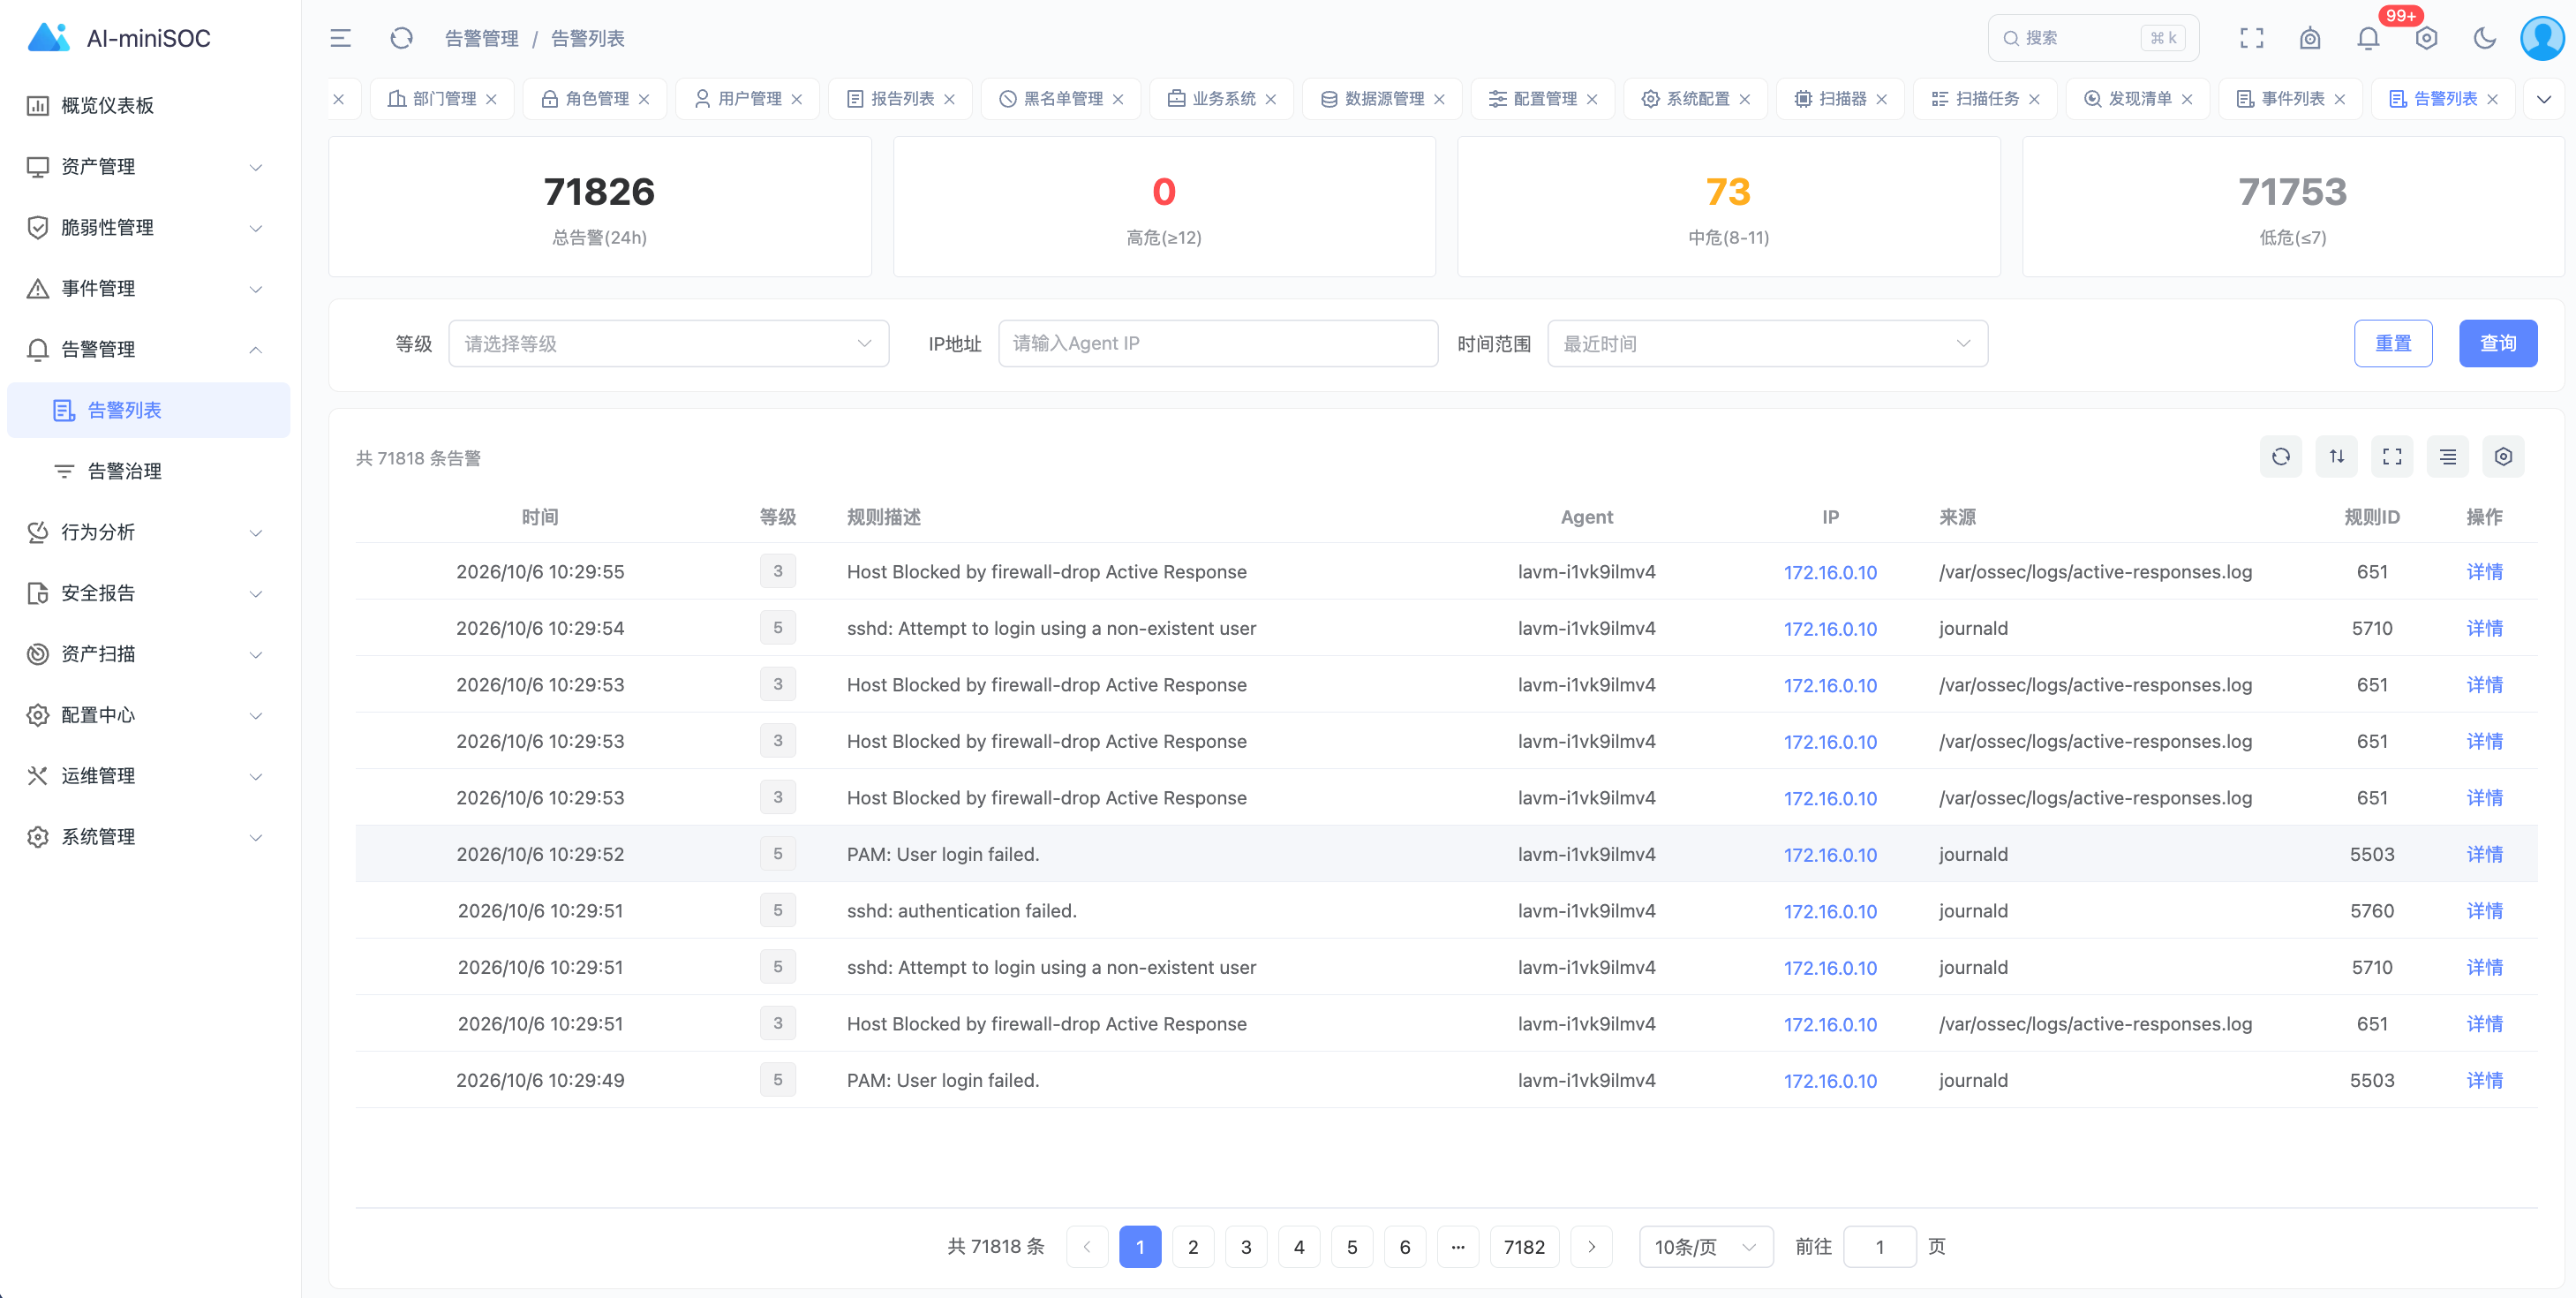
基础设施层·告警底座(OpenSearch):告警查询直接与 Wazuh 的 OpenSearch 集成打通,作为告警的数据底座——架构图里"OpenSearch 承接告警存储"这一格的实景:
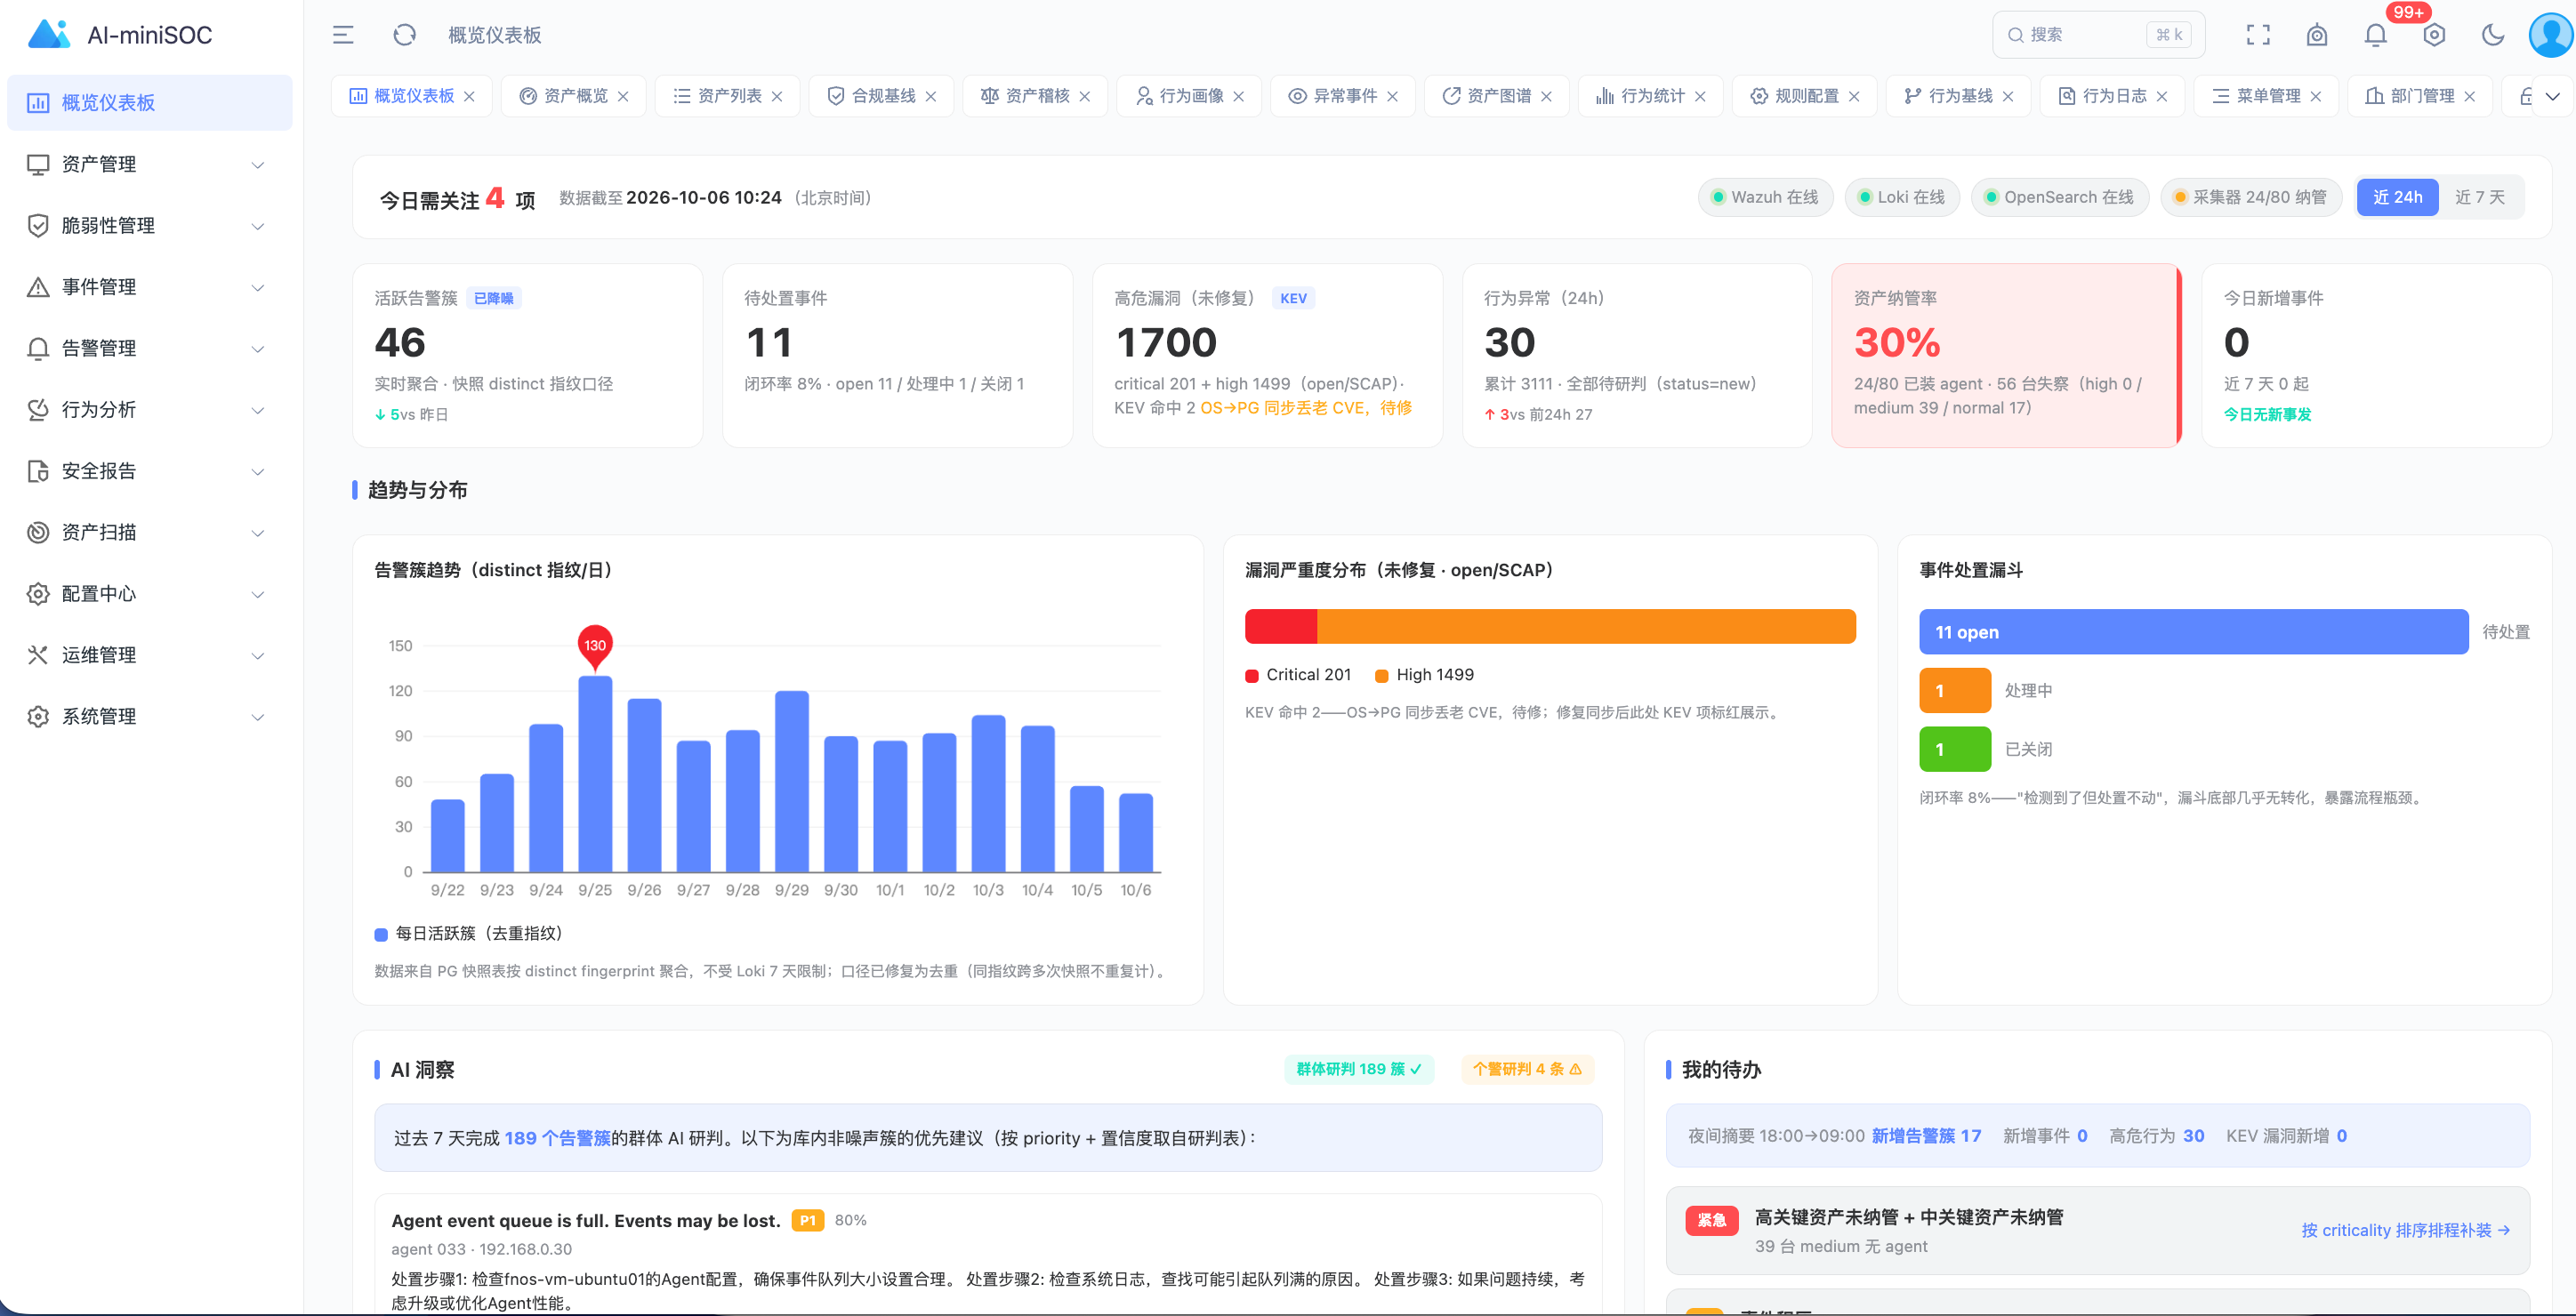
前端层·控制台:AI-miniSOC 登录后的功能菜单和界面,11 个顶级菜单把四层架构的能力最终呈现在一个界面里:
后端层·API 网关(FastAPI):自动生成的接口文档,43 个路由模块全在这份清单里——“平台级"的直接证据:
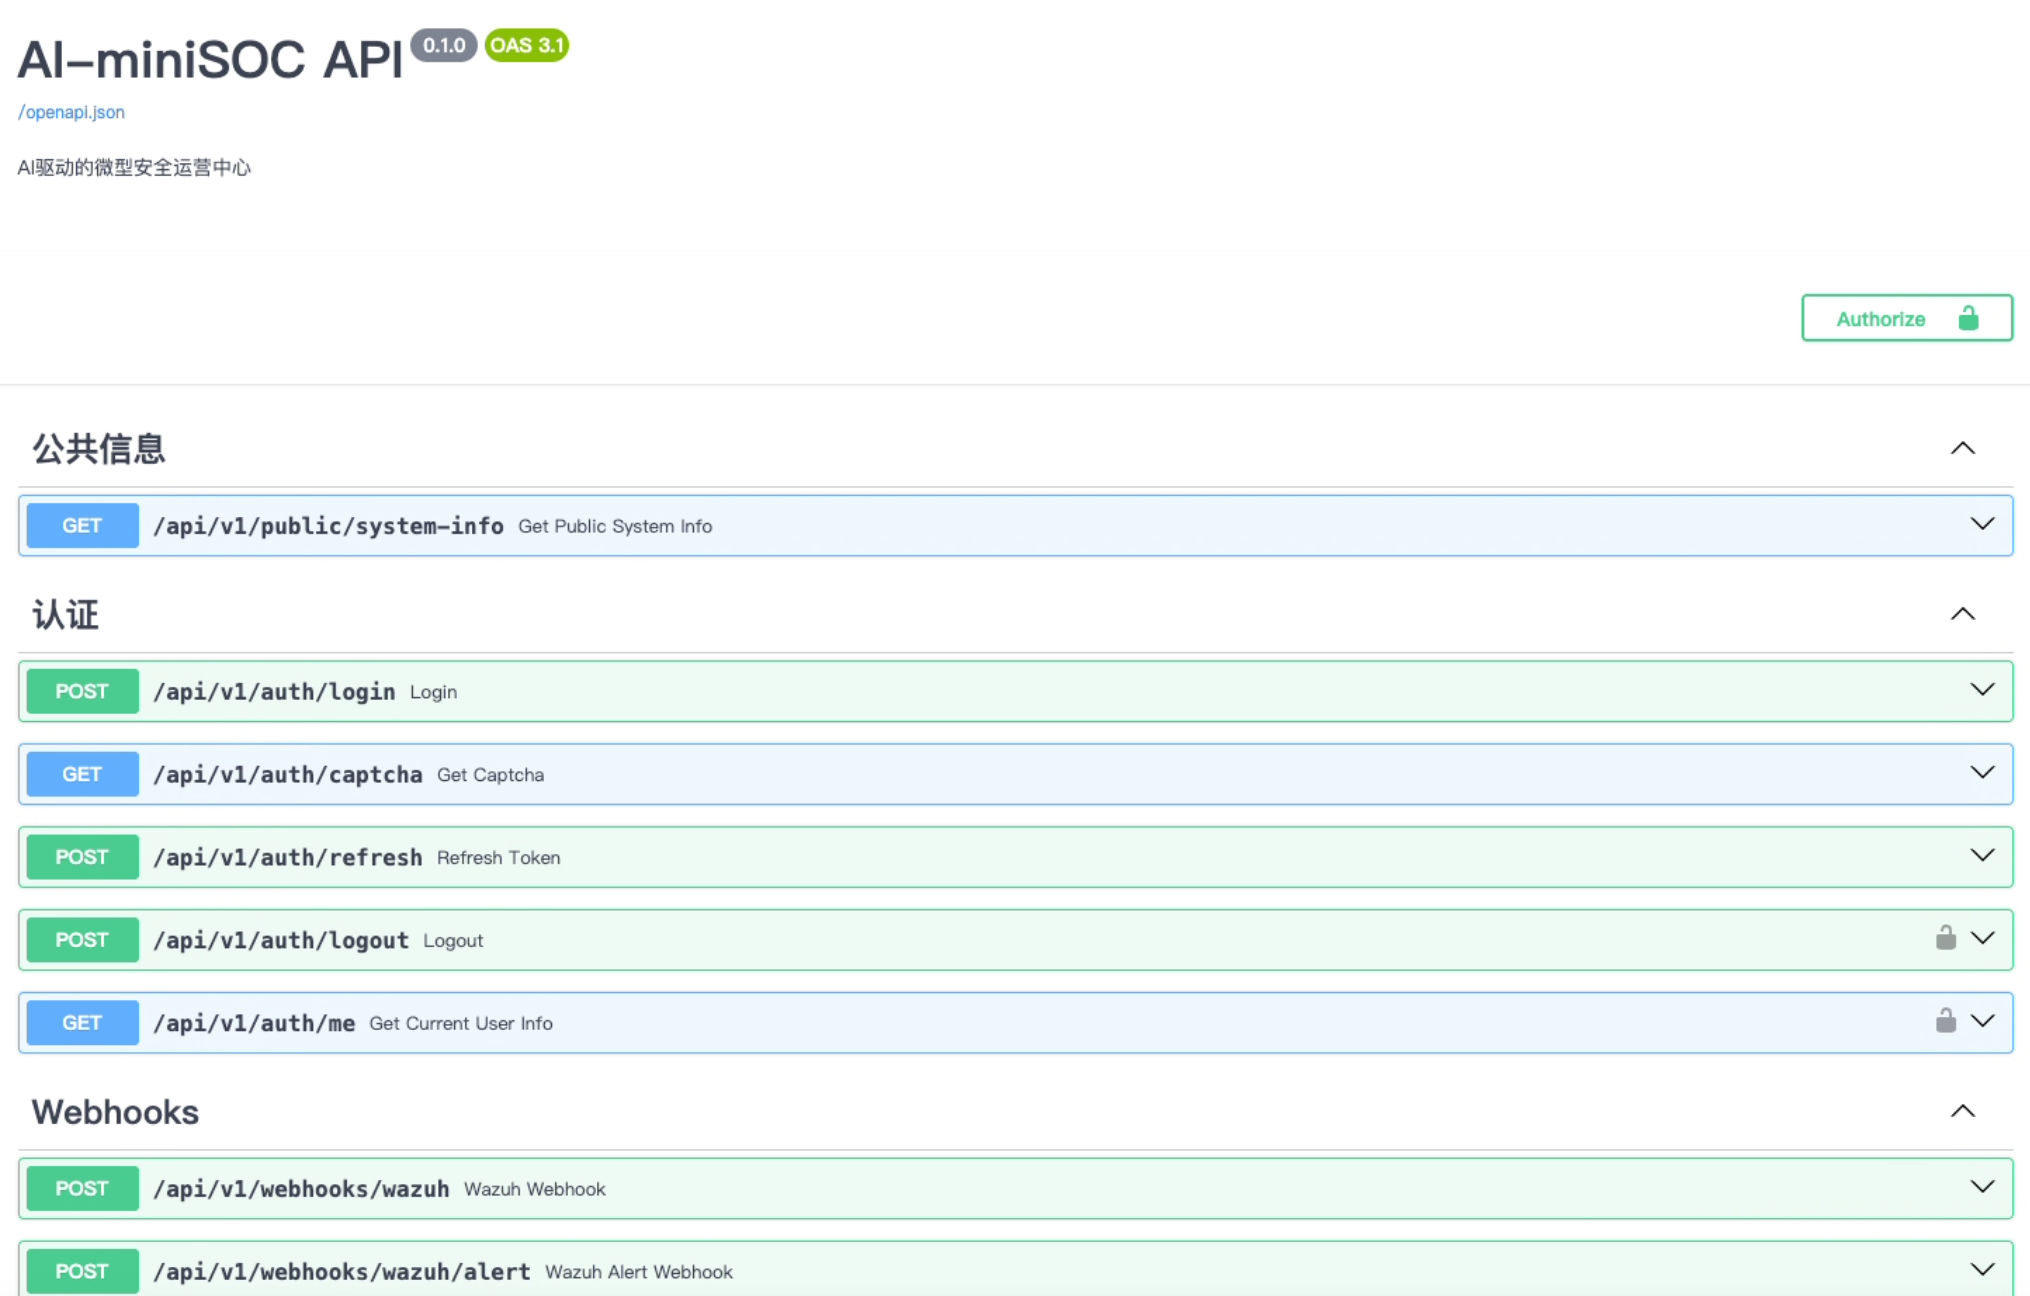
能塞下的秘诀复盘一遍:Loki 管住了日志层的内存欲望(取舍一),组件全是轻量开源软件,AI 调用走外部 API 不占本地算力(取舍三),采集器可以拆到别的机器(取舍二)。如果未来数据量涨了,OpenSearch 和 Wazuh Indexer 可以拆到第二台机器上——架构留了水平扩展的口子,但那是"以后的事”,不是"起步的门槛"。
顺带交代一件容易忽略的事:这套架构里所有组件都是单一职责、可独立替换的。哪天你觉得 Wazuh 不好用换了别的 HIDS,后端和前端完全不用动——采集器框架隔离了数据源差异。这是"平台"和"脚本集合"的本质区别。
六、诚实对照:它有什么、没什么
00 篇承诺过"真实",包括不完美的地方。对照中型商业 SOC,这张表你值得拥有:
| 能力 | AI-miniSOC | 商业 SOC | 说明 |
|---|---|---|---|
| 日志留存 6 个月+ | ✅(告警+结论) | ✅ | 原始流水 7 天,结构化证据长期 |
| 主机入侵检测 | ✅ Wazuh | ✅ | 规则库略少于商业产品 |
| 资产台账与对账 | ✅ | ✅ | 含影子资产稽核 |
| 告警分级治理 | ✅ | ✅ | 聚合+分级+摘要 |
| AI 解读/查询/报告 | ✅ 9 个消费点 | 部分有 | 多数商业产品的 AI 还在 PPT 阶段 |
| 多租户 | ❌ | ✅ | Phase 5 规划中 |
| 高可用集群 | ❌(单机) | ✅ | 小规模够用,大了要拆 |
| 专职售后团队 | ❌ | ✅ | 你自己 + 社区 + 本系列 |
| 价格 | 旧服务器 + 每月几十元 | 数十万级 |
没写的优势不吹,没做的功能不藏。它的设计目标自始至终是"一个人的中小环境",不是替代商业平台。 如果哪天你的环境大到需要多租户和高可用集群,恭喜——那说明公司长大了,该买商业方案或者招人了。
七、总结:架构的哲学
一篇文章四张图,其实就讲了三句话:
- 分级存储——90% 的原始日志只热 7 天,值钱的 10% 才长期保存(Loki + OpenSearch + PostgreSQL 各司其职);
- 拉模型采集——数据源主动出向连接,NAT 和家庭宽带不再是障碍,还不新增攻击面;
- AI 是消费点——确定性主干保证安全底座永远可靠,9 个 AI 消费点每个都有降级路径。
而贯穿三者的元原则只有一条:架构是取舍的艺术,不是堆料的艺术。 “什么都上最好的"是团队和预算的游戏;“每个组件刚好够用、每个决策有明确理由"才是一个人玩得起的 SOC。
对应到你自己的场景:如果公司有 500 台主机、等保三级,按这个架构把 Wazuh 多装几个 agent、磁盘给大点就行;如果你只想监控家里网络,砍掉 OpenSearch 都没问题。架构图是地图,不是牢笼。
写在最后
00 篇结尾说"下一篇,我们用一小时把它跑起来”。现在架构你已经看懂了,台词兑现——
下一篇 (02):从零部署 AI-miniSOC——一小时跑起来的实战与踩坑。我会把部署的每一步、每一个 .env 配置项、每一个我踩过的坑(数据库三个库的纪律、venv 的坑、前端构建的坑)原样奉上。
老李已经把那台 2019 年的旧服务器从库房里搬出来了。你呢?
【系列导航】《一个人的SOC》总目录(持续更新)
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐
https://github.com/xiejava1018/AI-miniSOC
【交流】 对架构有疑问、想讨论自己环境的选型,欢迎去仓库提 Issue——你公司的规模适不适合这套架构,评论区/Issue 里聊。
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!