念稿感的真相:不是你不自然,是你太快了。
先说一个数字:312 字/分。
什么概念?新闻播音员的语速,大约就是每分钟 300 字。
也就是说,我第一遍试讲一段 3 分钟的活动致辞时,开口就是播音员的速度——而且全程匀速,一个磕巴都没有。
听起来很牛?
AI 的点评一盆冷水浇下来:“语速 312 且匀速无波动——这是在背,不是在讲。”
那天,同一份讲话稿,我前后录了 5 遍。从 312 字/分降到 160,中间发生的事,比语速本身有意思得多。
一、背景:一次真实的讲话,不是练习
公司工会搞趣味活动,我是主持人之一,要来一段 3 分钟致辞——欢迎新并入的兄弟团队,介绍一下活动安排。
这是真实待办,讲砸了没有重来的机会。
我的土办法是:每一版都录音,喂给 AI 做量化点评——语速、口头禅密度、重复卡顿、结构、评分,每遍一份报告,改完再录下一遍。
于是有了同一份稿子的 5 个版本,和 5 份数据。
二、五遍的数据,长这样
| 版本 | 时长 | 语速(字/分) | 口头禅密度(次/分) | 综合分 |
|---|---|---|---|---|
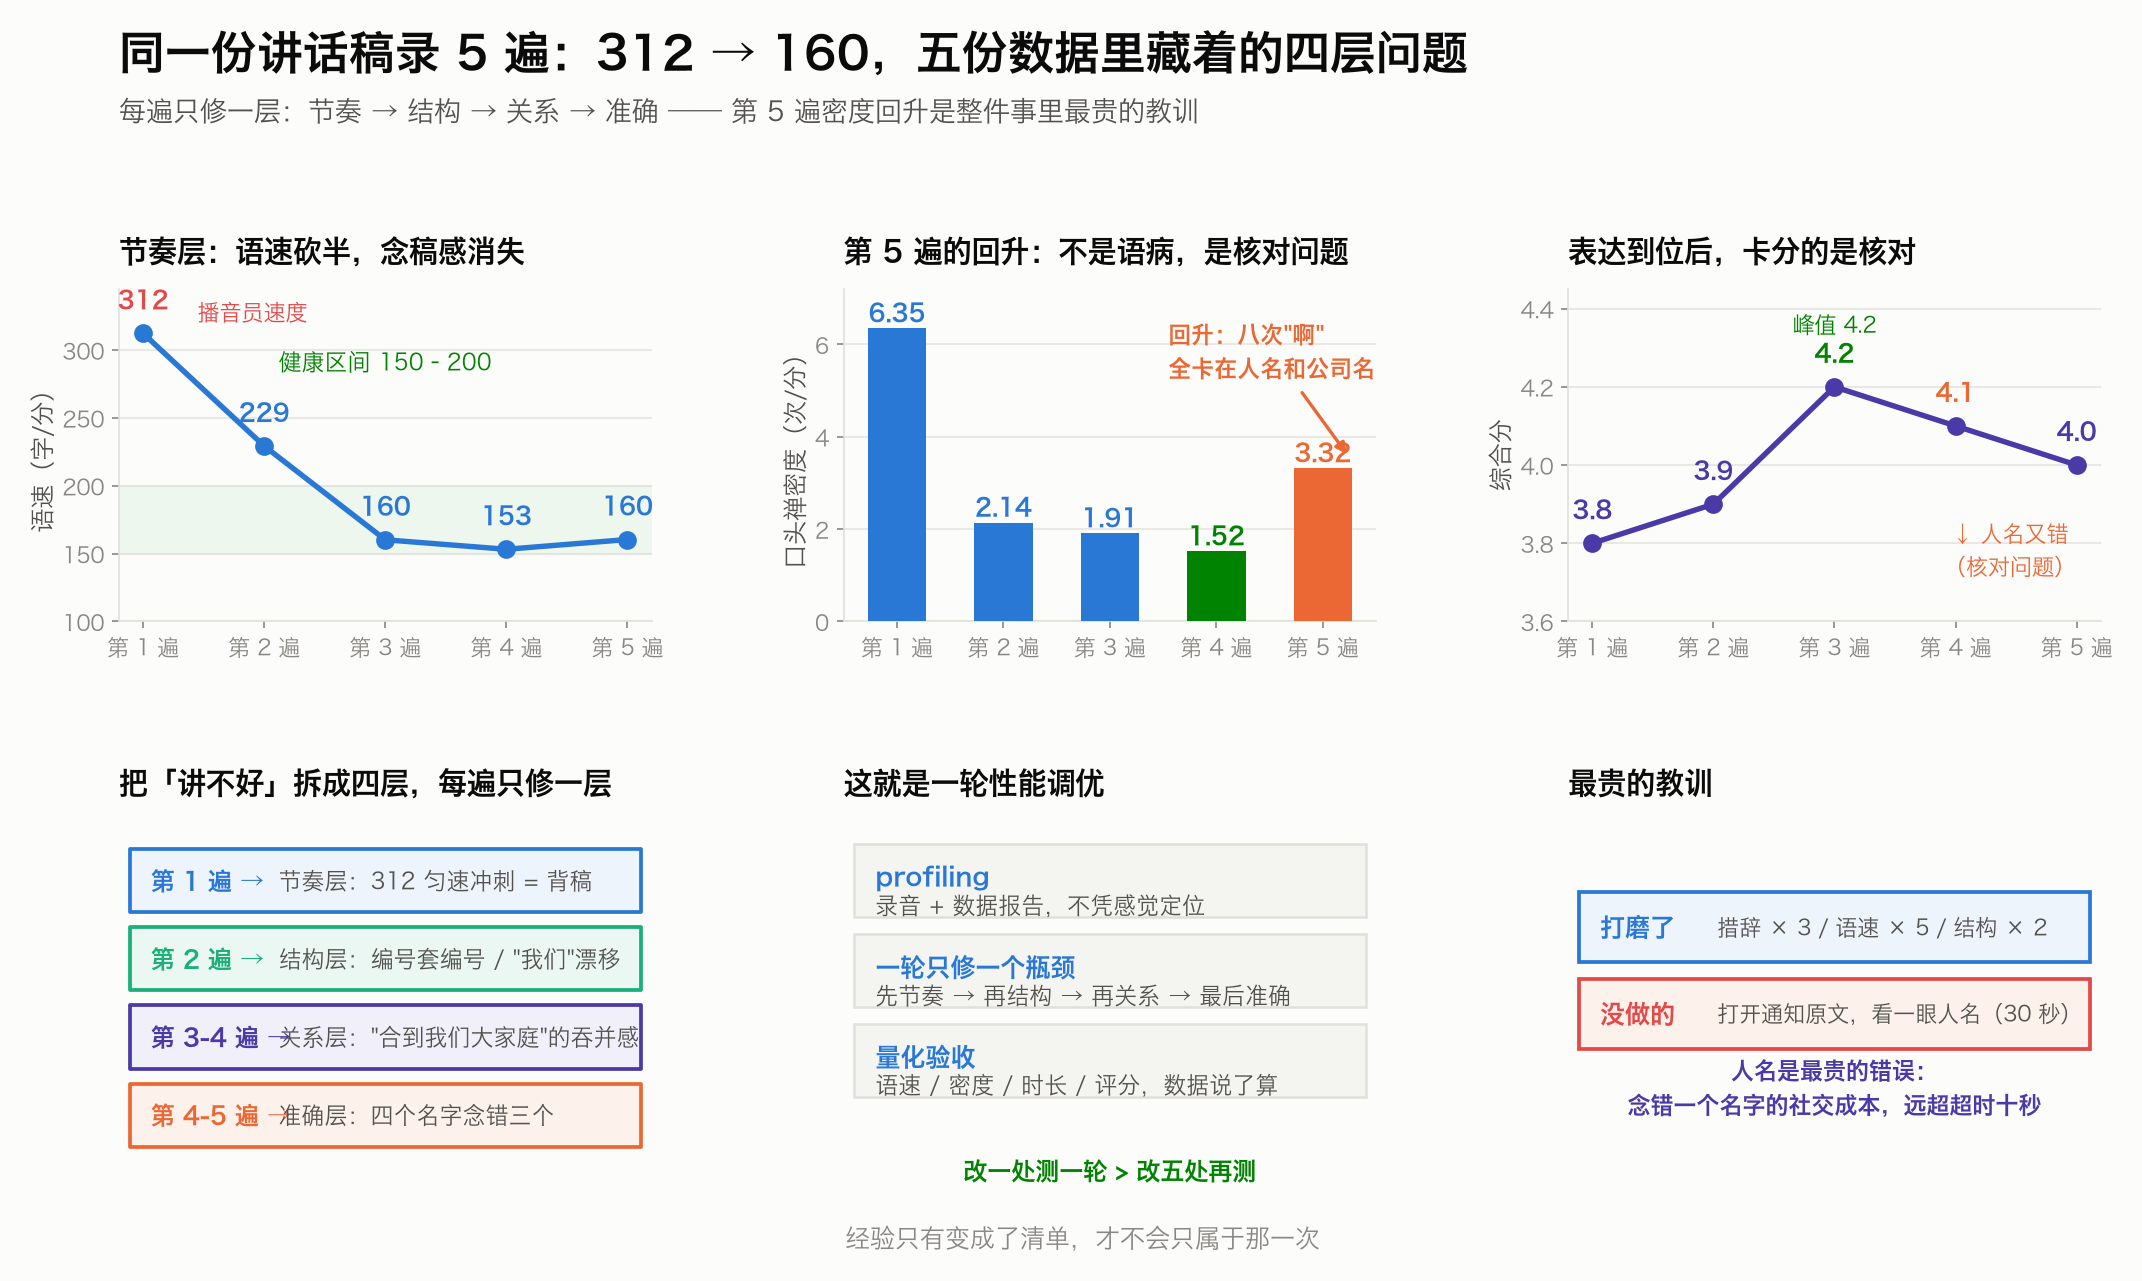
| 第 1 遍 | 1:28 | 312.3 | 6.35 | 3.8 |
| 第 2 遍 | 1:52 | 229.3 | 2.14 | 3.9 |
| 第 3 遍 | 3:08 | 160.2 | 1.91 | 4.2 |
| 第 4 遍 | 3:17 | 153.2 | 1.52 | 4.1 |
| 第 5 遍 | 3:19 | 160.4 | 3.32 | 4.0 |
两个看点:
- 语速从 312 一路降到 160 左右稳定下来——正好降了一半;
- 第 5 遍的密度突然回升,原因后面讲,那是整件事里最贵的教训。
但数据只是结果。真正值得复盘的是:每一遍,我到底修掉了什么。
三、把"讲不好"拆开,其实是四层问题
录到第 5 遍我才看清:所谓"讲话不行",根本不是一个问题,是四层问题叠在一起。
第 1 层:节奏层——“念稿感"的真相
312 字/分的匀速冲刺,听感上就是"在背”。不是我不自然,是我没有快慢变化——真正即兴讲话的语速是波动的,重点处慢,过渡处快,想不起来时停。
从第 1 遍到第 3 遍,语速 312 → 229 → 160,念稿感肉眼可见地消失。
这里还有个体会:声音放大之后,气是顺的,语速自然就下来了——声音小、气若游丝的时候,人反而容易赶。
第 2 层:结构层——编号和主语
第二遍暴露的问题:讲了"三点",讲到第三点里面又冒出"第一、第二",结尾又来一个"第三个"——编号套编号,听众直接迷路。
还有一个更隐蔽的:“我们"的指代在漂移。一段一分多钟的话里,“我们"指过我们部门、指过全公司、指过团队、还指过"大家庭”——我一直在说"我们”,但"我们"到底是谁,一直在换。
修法很土:一段话里,主语钉死一次(“我们研发中心”),后面统一用"大家"“咱们”,中途不换壳。
第 3 层:关系层——“我们大家庭"的吞并感
这是最微妙的一层。致辞对象里有一支新并入的兄弟团队,我的稿子里写的是"合到我们大家庭”。
AI 点出来我才发现:“合到我们"这四个字,是用"我们"这个壳,把对方装了进来——听起来客气,姿态上却是"你们被我们吸收了”。
我改了三次:“合到我们大家庭”→“加入我们这个大家庭”→“我们某某团队”——三次改法,同一个病。
最后改成:"今年我们团队做了调整,兄弟团队和我们一起,今天是全员第一次集体活动"——让对方保持独立主体,吞并感消失。
一句措辞,决定你是在欢迎人,还是在收编人。
第 4 层:准确层——人名是最贵的错误
第一遍,我照着记忆念四位组织者的名字,四个念错三个。
之后每一版都有进步……但有个名字,三版三种错法。直到第 5 遍我才意识到根因,特别扎心:
我从来没有打开那篇通知原文核对过。
一遍遍打磨措辞、语速、结构,却没花 30 秒去看一眼原文。核对之后,四个名字全对。
四、两个反直觉的发现
发现一:表达到位之后,卡分数的不再是表达,是核对。
第 4 遍,时长、语速、密度、结构全部达标——历史最好数据。但因为人名又错了一次,综合分反而从 4.2 回落到 4.1。
表达问题的天花板,比你以为的低得多。到了那个高度之后,剩下的是"念稿核对卡"能解决的事:人名、公司名、时间、地点,抄一页纸,开口前扫 30 秒。
发现二:自己感觉最差的版本,数据最好。
第 4 遍录完,我感觉"越录越差,不如第 3 遍"——结果那遍的硬指标是五个版本里最佳的。
后来想明白了:不是退步了,是耳朵的标准上移了。你听得见问题了,恰恰说明你到了那个水平。进步,经常发生在自己感觉不到的地方。
这个现象后来成了这套训练体系里的一个正式概念——感知阈值上移。它在另一次练习里又撞了一次:我录音问 AI"练了这么久到底有没有提升",那天自我怀疑,AI 却给了两个半月的历史最高分 4.5。两次撞墙之后我立了规矩:**自我怀疑的时候,不看感觉,看数据。**完整的数据视角见《我让 AI 用数据点评我的表达,两个半月后翻账本看是不是有进步》。
五、为什么"同一份稿子录 5 遍"这么有效
干了二十多年软件,我发现这套路子熟得像性能调优:
- 先做 profiling(录音+数据报告),不凭感觉定位瓶颈;
- 每轮只修一个瓶颈:先节奏、再结构、再关系、最后准确——跳层修会返工;
- 量化验收:语速、密度、时长、评分,改没改好,数据说了算。
写代码的人都知道,改一处、测一轮,比改五处再测,效率高一个量级。讲话这件事,一样的。
AI 在这里面干的活很明确:**它管测量,我管判断。**它告诉我"312 且匀速",“我们"漂了四次——但"吞并感"这种微妙的东西,最终是靠人听出来的,然后变成下一版的修改。
还有个意外收获:第 5 遍的密度回升到 3.32,八次"啊”——定位了一下,全卡在人名和公司名上。不确定 → 卡壳 → 用"啊"接住。所以那不是语病,是核对问题又一个症状。核对卡一用,两个病一起治。
这个"机器管测量、人管判断"的分工,后来被固化成了一套完整的系统——五场景标尺、双评打分、进步账本,就是《请不起表达教练,我写了一个 AI-ExpressCoach 的 Skill》里那个开源 Skill。
六、写在最后
如果你最近也有一场躲不掉的讲话,送你三句我从这 5 遍里换来的话:
1. 念稿感不是心理素质问题,是节奏问题。 300+ 的匀速就是背稿,把速度降下来、让它波动,人味儿自然就有了。
2. 讲话问题是四层的:节奏、结构、关系、准确。 从上往下修,每遍只修一层——五遍足矣,别指望一遍全改好。
3. 把力气花在核对上,性价比最高。 措辞改三遍,不如原文看一眼。人名是最贵的错误——念错一个名字的社交成本,远超超时十秒。
那天活动结束,有同事说我"讲得挺自然"。
他不知道的是,那句"挺自然",是 312 字/分砍到 160、四个名字核对了五遍换来的。
评论区聊聊:你有没有哪次讲话,是靠"笨办法"一遍遍练出来的?
延伸阅读(这是表达训练系列的实战篇):
- 请不起表达教练,我写了一个 AI-ExpressCoach 的 Skill —— 系统篇:这套练法后来被固化成的开源 Skill(五场景标尺 + 机器管测量 + 进步账本)
- 我让 AI 用数据点评我的表达,两个半月后翻账本看是不是有进步 —— 数据篇:30 多条记录摊开看,平均分没涨但三件事瞒不住;“感知阈值上移"的完整数据视角
- AI 什么都知道,你的脑子还剩什么用? —— 系列起点:AI 是硬盘,你得有自己的缓存
- 人人都有 AI 之后,你的"目标函数"是什么? —— 同样的 AI,有人杀时间,有人杀出一条路
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!