17 篇讲完成本账本,有读者可能会问:“然后呢?”
系统的下一步是什么?这个项目会一直更新吗?我能参与吗?
这一篇回答这三个问题——也是全系列的真正出口:前 17 篇讲的是"一个人的 SOC 怎么建",这一篇讲的是"它如何走向一群人"。
一、现在到哪了:一张已完成地图
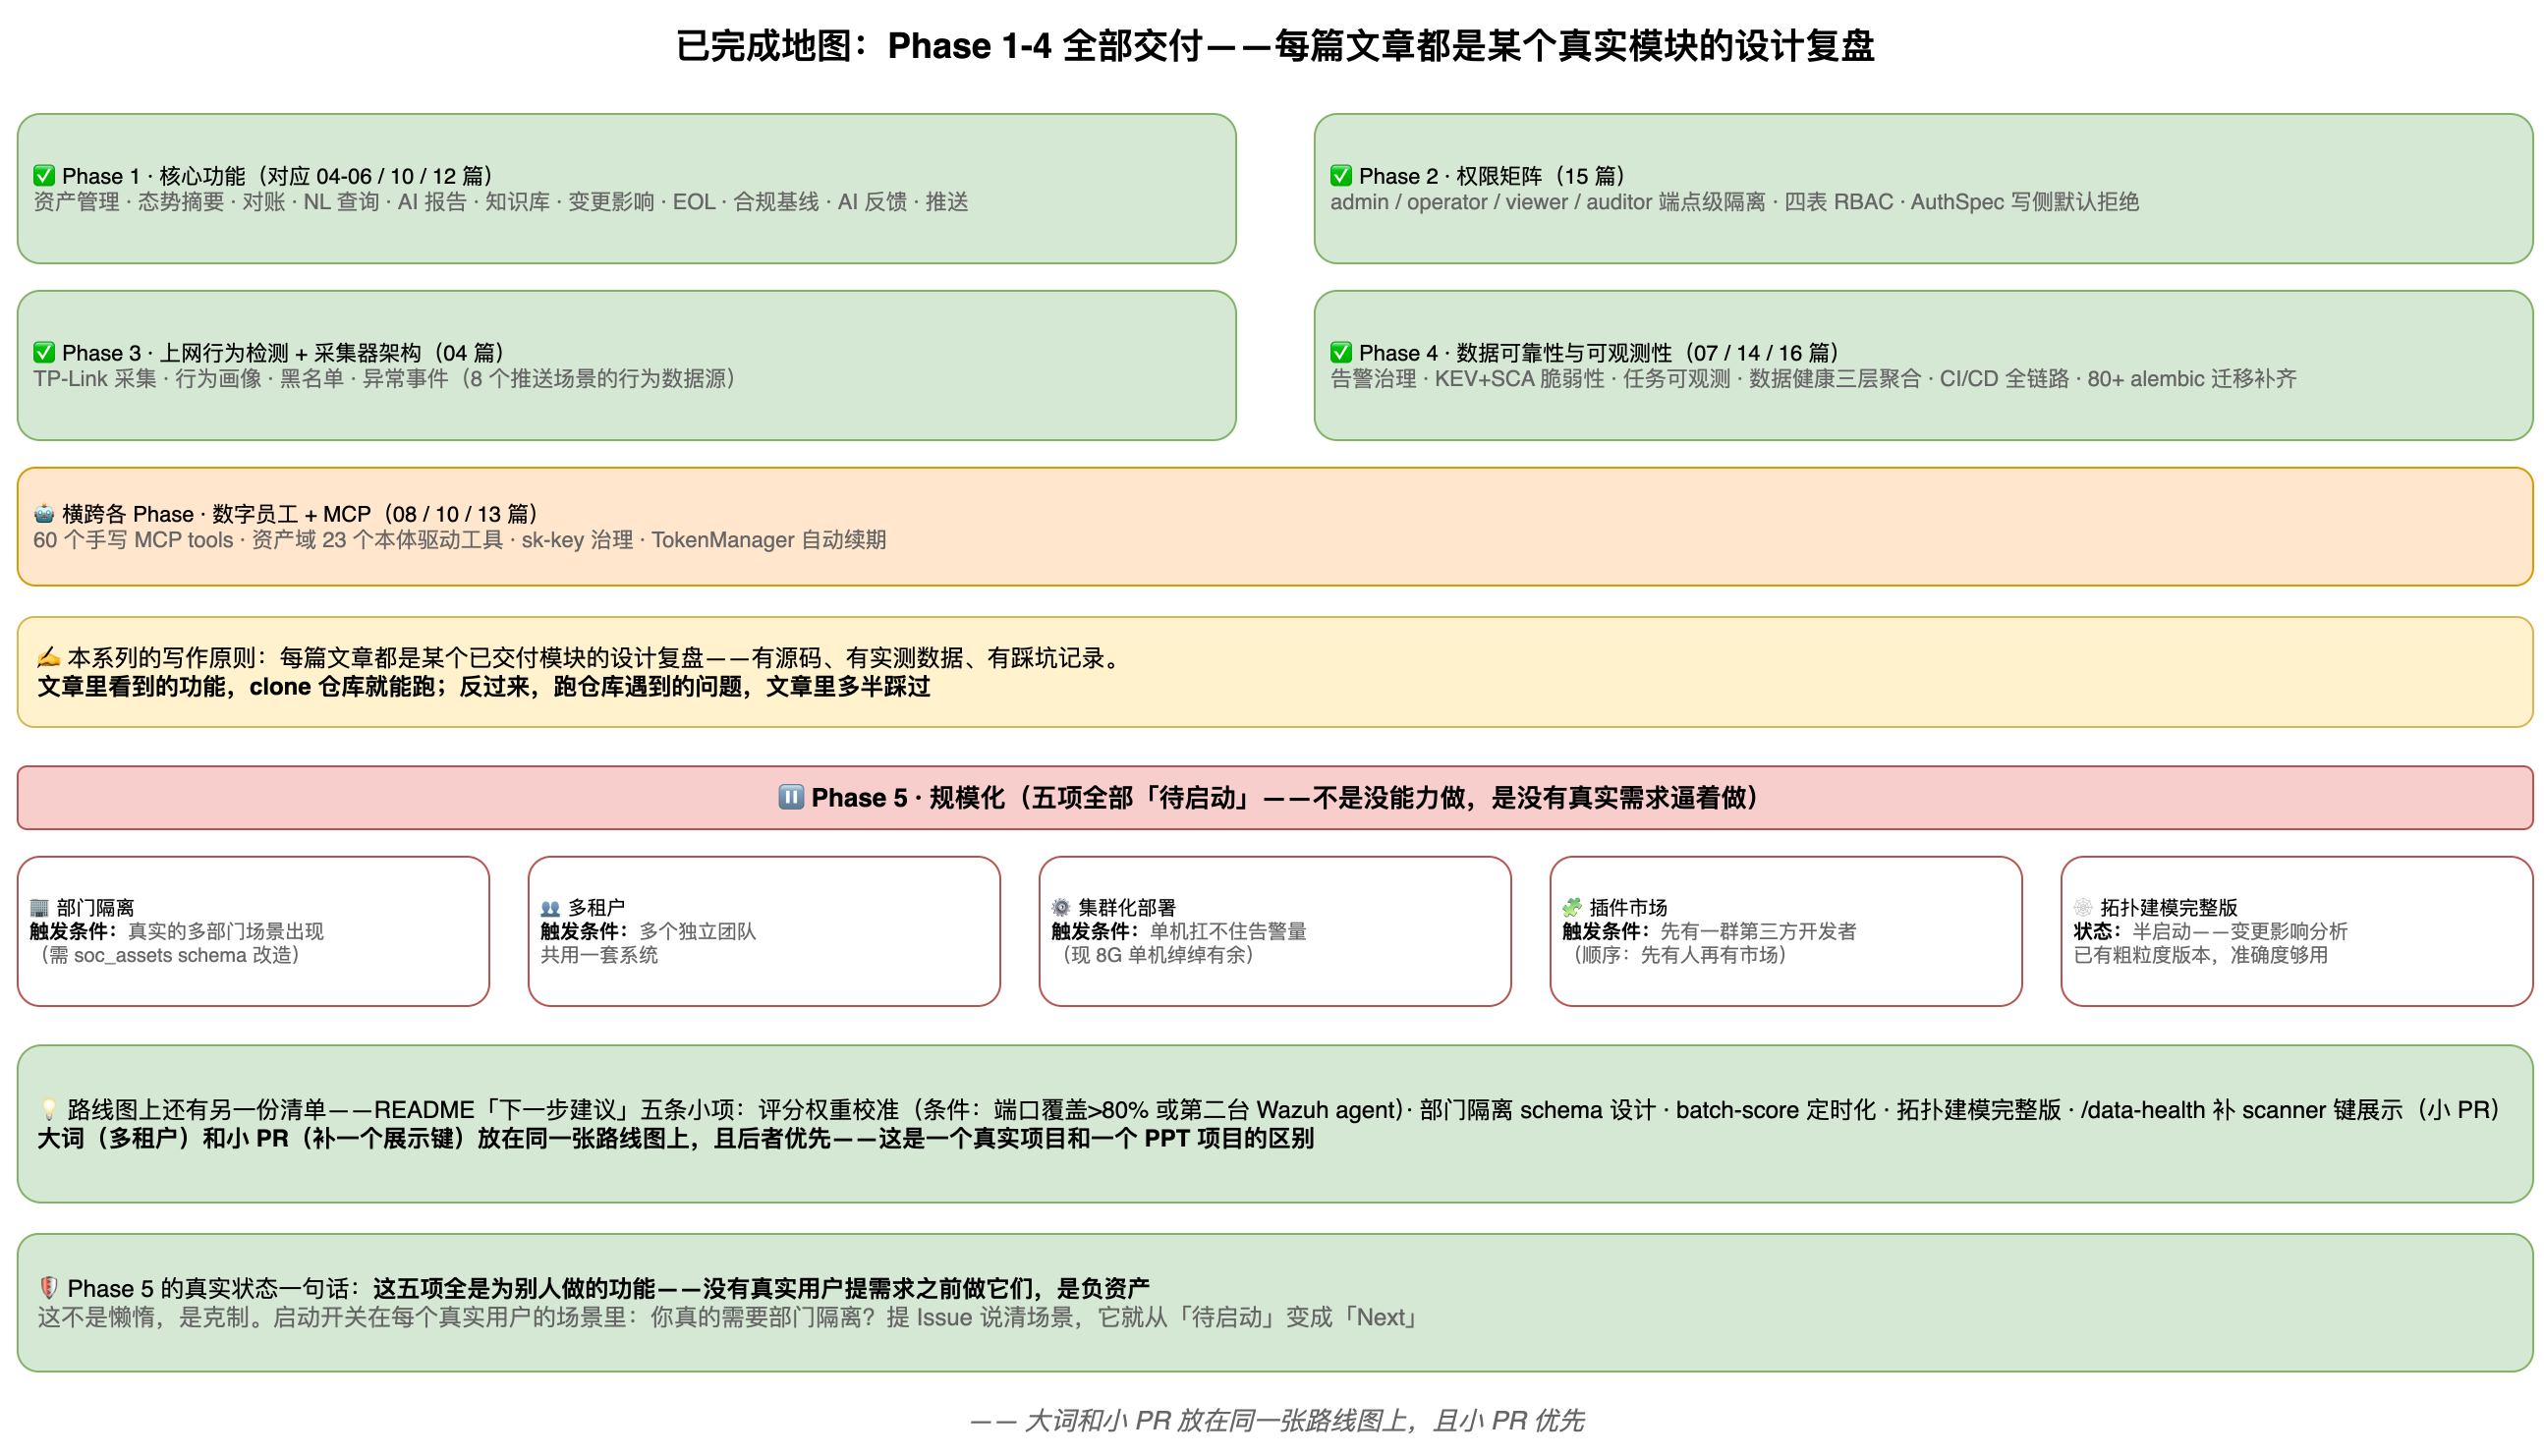
先盘点家底。AI-miniSOC 的仓库路线图上,Phase 1 到 Phase 4 全部交付,每一项都对应着系列里的一篇文章——文章讲的不是计划,是仓库里真实跑着的模块:
| Phase | 交付内容 | 对应文章 |
|---|---|---|
| Phase 1 | 资产管理/态势摘要/对账/NL 查询/AI 报告/知识库/变更影响/EOL/合规基线/AI 反馈/推送 | 04-06、10、12 篇 |
| Phase 2 | 权限矩阵(四角色端点级隔离) | 15 篇 |
| Phase 3 | 上网行为检测、采集器架构 | 04 篇 |
| Phase 4 | 告警治理/脆弱性管理(KEV+SCA)/任务可观测性/数据健康三层聚合/CI/CD 全链路/80+ 迁移补齐 | 07、14、16 篇 |
| — | 数字员工工具集(资产域 23 个 MCP 工具)/ MCP Server(60 tools)/ Key 治理 | 08、10、13 篇 |
这个对应关系是本系列的写作原则:每篇文章都是某个已交付模块的设计复盘——所以每篇都有源码、有实测数据、有踩坑记录。反过来,你读文章时看到的功能,clone 仓库就能跑。
二、往哪走:Phase 5 为什么集体"待启动"
仓库路线图上,Phase 5 列了五项,全部标记"待启动":
- 集群化部署
- 拓扑建模(变更影响分析完整版)
- 部门隔离(资产表 schema 改造)
- 插件市场
- 多租户
如果你是产品经理,会问:为什么这么久还不做?
答案:不是没能力做,是没有真实需求逼着做。 逐个说:
部门隔离——需要 soc_assets 表加 schema 改造。但当前的部署场景里只有"一个部门"(就是你自己管的那摊),“部门 A 看不到部门 B"这个需求不存在。15 篇的 FAQ 里写过同一逻辑:权限建设按真实需求排序,不按完备性排序。
多租户 / 集群化——这两项是"规模过线"才需要的:多租户是"多个独立团队共用一套系统”,集群化是"单机扛不住告警量"。而现状是 75 台资产、日告警 2 万条,单台 8G 机器绰绰有余(09 篇原话:“超 200 台规模再考虑”)。为一个不存在的租户做租户隔离,是为想象中的需求增加今天的复杂度——YAGNI 原则在 15 篇 FAQ 里讲过,这里是它在路线图层面的应用。
插件市场——需要先有一群第三方开发者,而目前项目还没有外部贡献者(下节讲怎么改变这一点)。顺序应该是:先有一群人,再有一个市场。
拓扑建模——这条其实是半启动状态(变更影响分析已有粗粒度版本),完整版要做真实的网络拓扑依赖图。它排在 Phase 5 不是因为难,是因为当前的准确度够用——17 篇的成本账本逻辑:够用的功能不追加投入。
所以 Phase 5 的真实状态可以用一句话总结:
这五项全是为别人做的功能——没有真实用户提需求之前做它们,是负资产。
这不是懒惰,是克制。路线图上有另一份清单更诚实——README 里"下一步建议"的五条小项:
- 评分权重校准(触发条件已写明:端口覆盖 >80% 或接入第二台 Wazuh agent)
- 部门隔离 schema 设计(独立工单)
- batch-score 定时化(免手动触发)
- 拓扑建模完整版
/data-health补 scanner 键展示(小 PR)
大词(多租户)和小 PR(补一个展示键)放在同一张路线图上,且后者优先——这是一个真实项目和一个 PPT 项目的区别。
三、你怎么参与:三种姿势,由浅入深
开源项目的参与门槛没有想象中高。按投入从低到高,三种姿势:
姿势一:用起来 + 反馈坑(门槛最低,价值最高)
clone 仓库 → 照着 02 篇部署 → 在你自己的环境里跑两周。
这个过程中踩的每一个坑、发现的每一个不兼容(不同路由器、不同 Wazuh 版本、不同硬件规格),都是贡献。 AI-miniSOC 在一种环境里跑通了,但世界的多样性远超一台测试机:
- 你的路由器品牌不同(04 篇是 TP-Link,华硕/小米的采集适配是空白)
- 你的 Wazuh 版本不同(规则 ID、字段映射可能有差异)
- 你的资产规模不同(500 台会不会撞到某个隐藏上限?)
这类"实测反馈"比代码 PR 更稀缺——维护者只有一套环境,你的环境就是盲区。仓库已备好 Issue 模板(部署求助/缺陷报告/功能建议/安全上报四类),照着填就行。
仓库的 Issue 模板页长这样——打开仓库点 “New issue”,四个模板直接可选(部署求助 / 缺陷报告 / 功能建议 / 安全上报),空白 Issue 已关闭,不用自己想标题写什么。
姿势二:提功能建议(参与路线图)
Phase 5 那五项"待启动",启动的开关是你。如果你真的需要部门隔离——比如你管两个子公司——提 Issue 说清楚场景(几个部门、多少资产、谁不该看到谁),它就会从"待启动"变成"Next"。
功能建议的模板里特意设计了几个字段:先写真实场景(不是功能名)、写现有功能为什么覆盖不了、写你的规模、以及你是否愿意参与验证。最后那个字段是认真的——Phase 5 每一项落地都需要一个真实环境做验收,你提供场景,项目提供实现,这是最健康的共建。
姿势三:提 PR(代码共建)
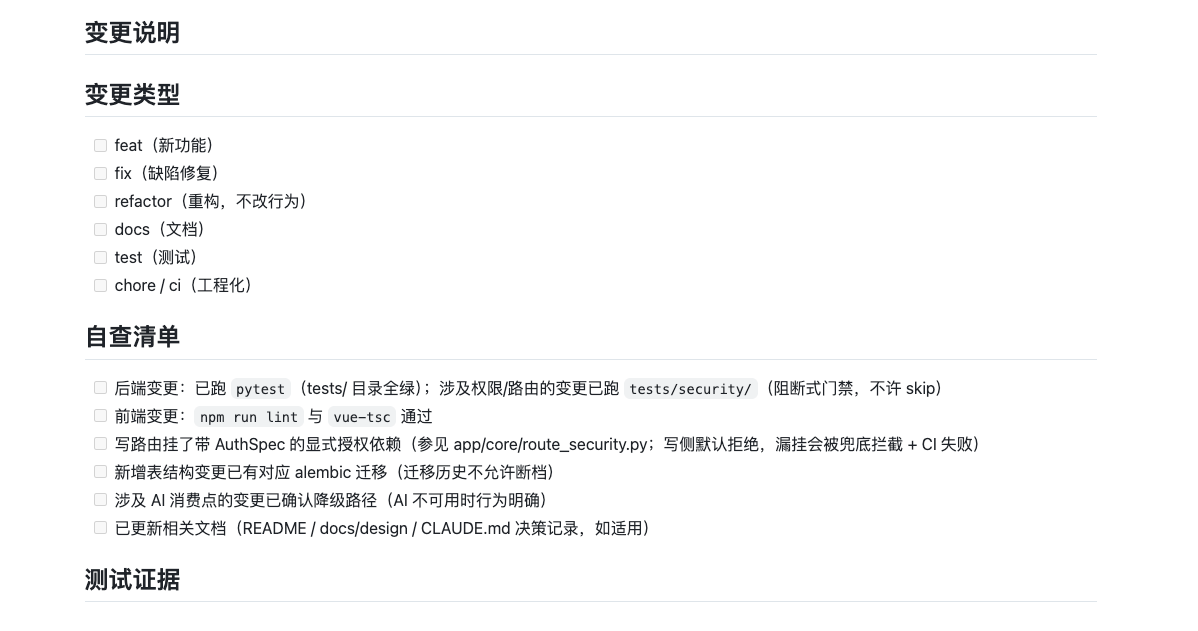
仓库的贡献指南已经就位:Fork + 特性分支、前端 lint / 后端 ruff、补测试、Conventional Commits。PR 模板里还有几条这个项目特有的自查项:
- 涉及权限/路由的变更必须跑
tests/security/(15 篇那 38 个阻断式门禁——权限门禁不认人情,PR 一样拦) - 写路由必须挂 AuthSpec 显式授权(漏挂会被兜底拦截 + CI 失败——默认拒绝在 PR 阶段就生效)
- 涉及 AI 消费点的变更必须确认降级路径(11 篇的降级链不能断)
这套门禁意味着:你不需要"了解维护者的所有习惯"也能提交合格 PR——机器会替维护者把关。 这正是 16 篇说的"工程化让项目不依赖任何人的记性"在共建场景下的价值。
PR 模板的正文长这样——开头是"变更说明 / 变更类型",中间是自查清单。清单里每一条都是这个项目特有的硬约束:
三种姿势合起来就是一张参与阶梯图——从「跑两周提坑」到「提场景推动 Phase 5」再到「代码共建」,每一级都有模板兜着:
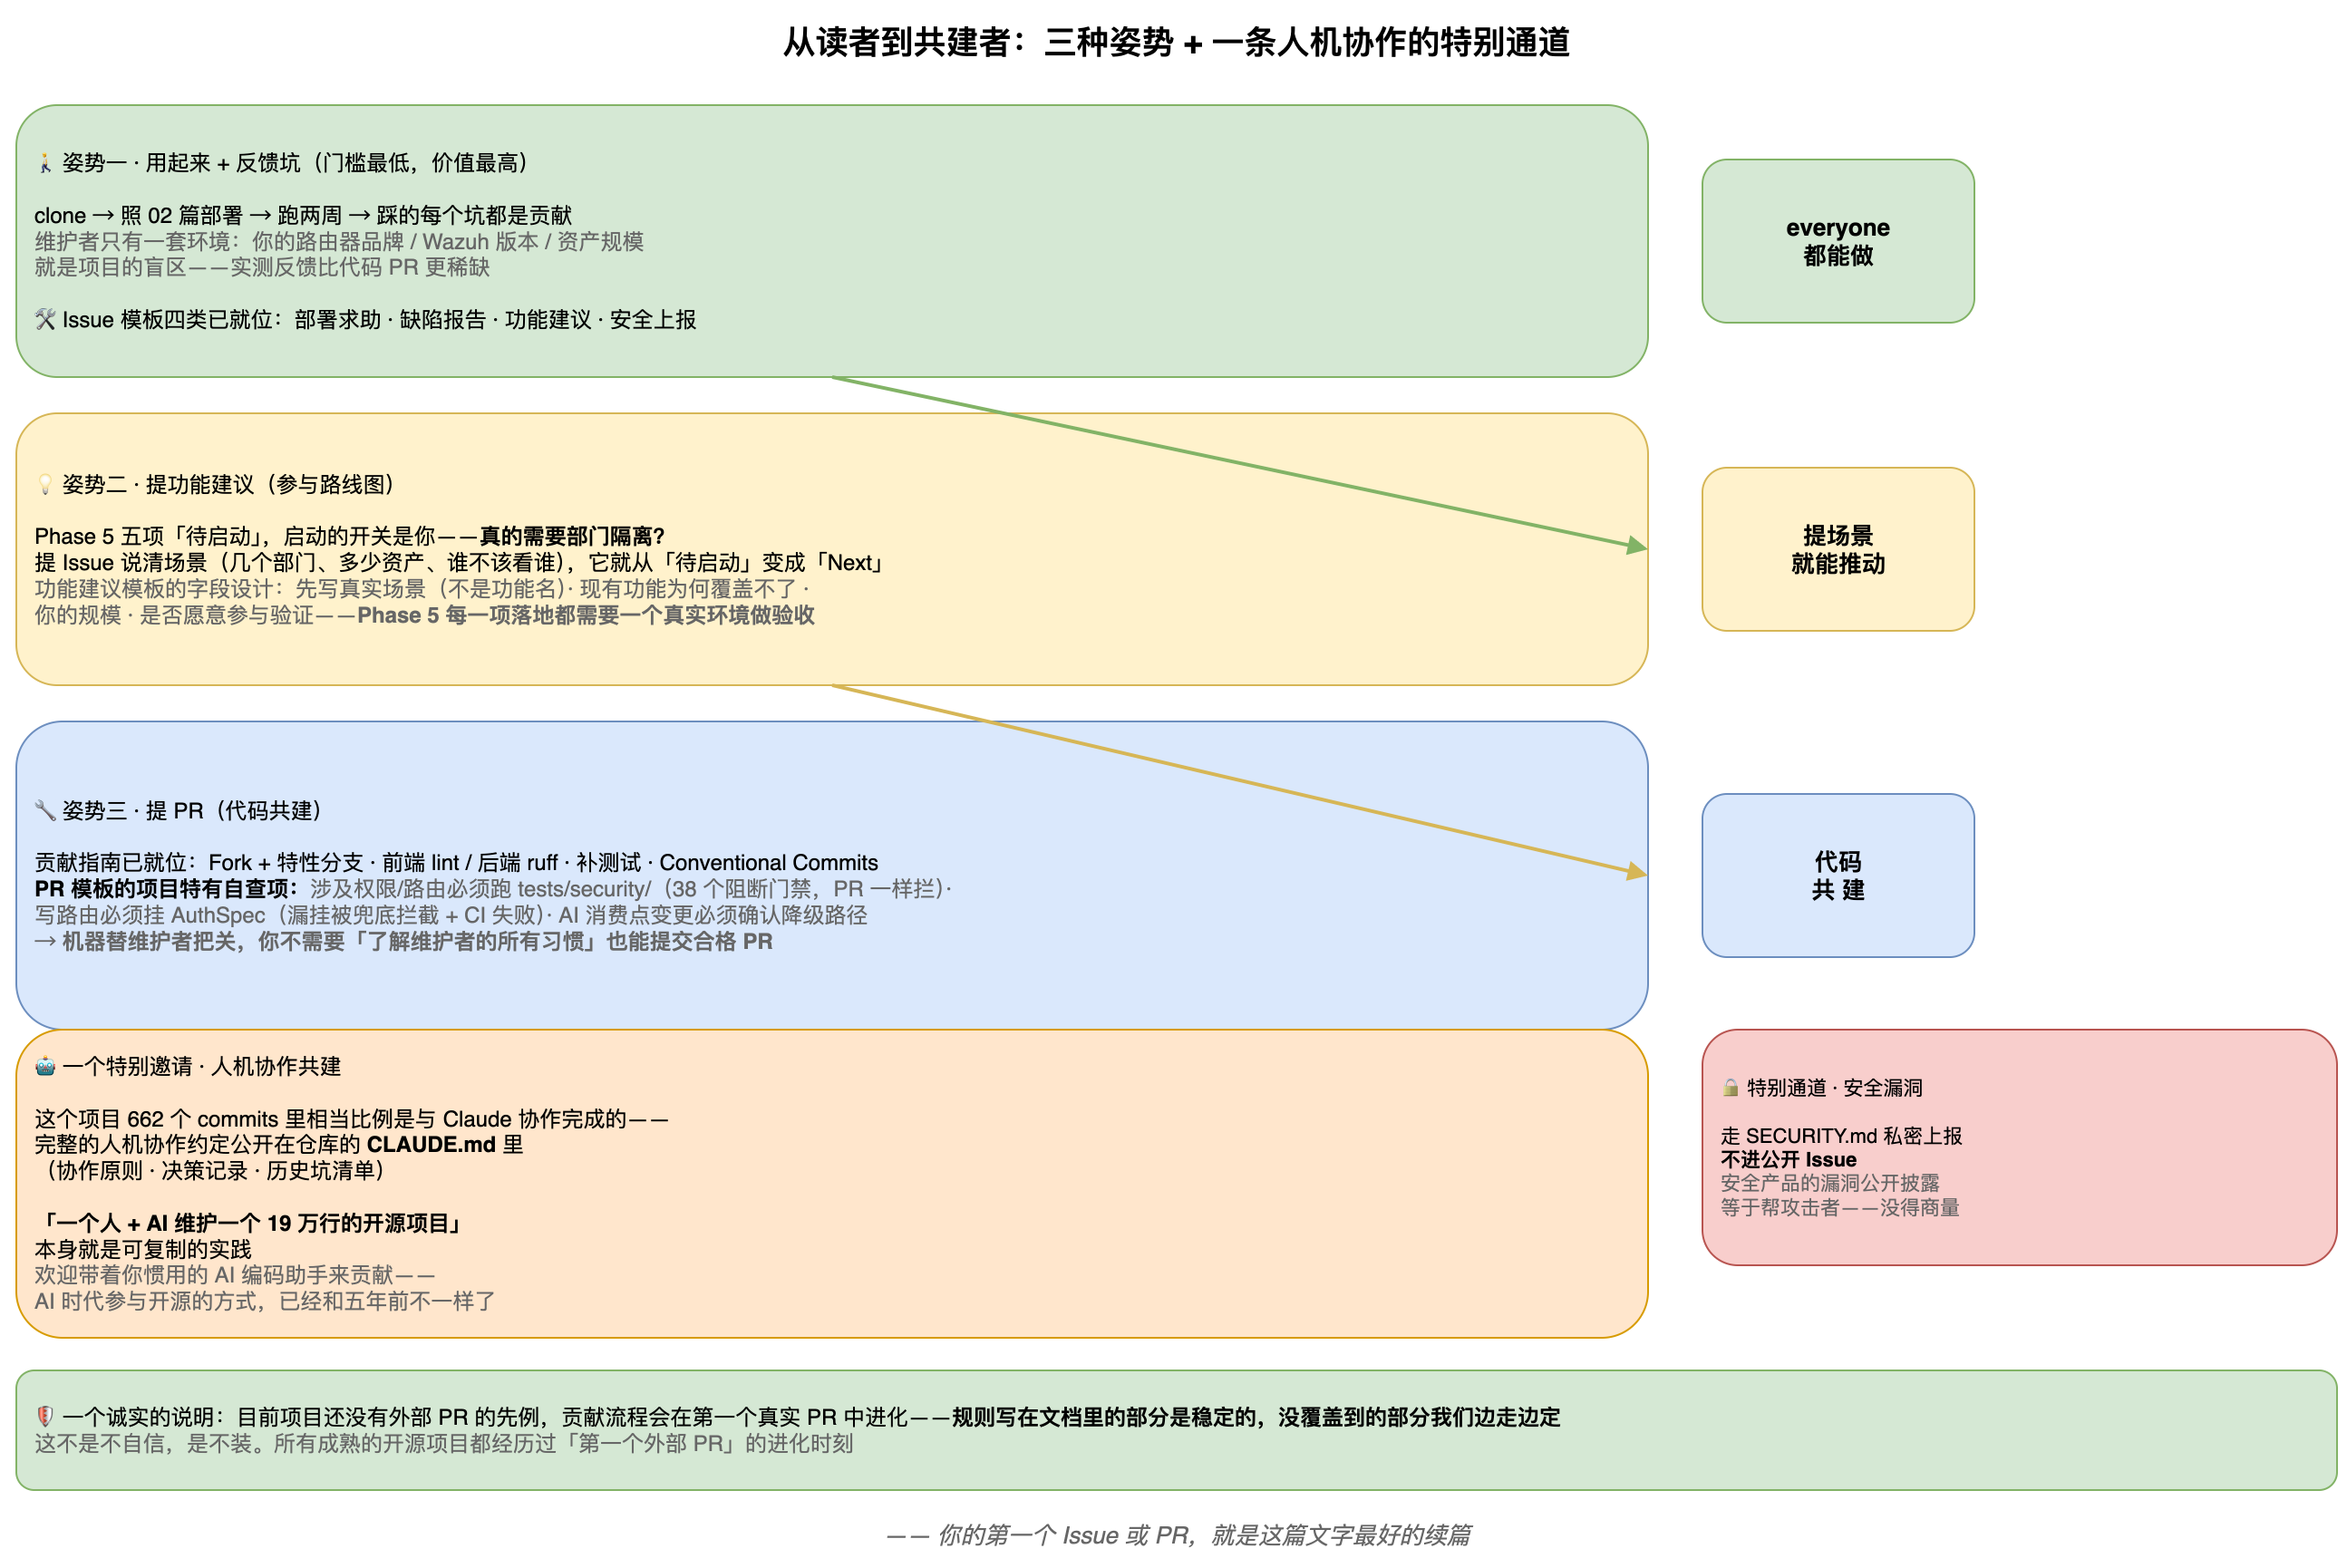
一个诚实的说明:目前项目还没有外部 PR 的先例,贡献流程会在第一个真实 PR 中进化——规则写在文档里的部分是稳定的,没覆盖到的部分我们边走边定。
一条特别通道 + 一个特别邀请
安全漏洞走 SECURITY.md 私密上报,不进公开 Issue——安全产品的漏洞公开披露等于帮攻击者,这条没得商量。
一个特别邀请:这个项目 662 个 commits 里有相当比例是与 Claude 协作完成的——完整的人机协作约定就公开在仓库的 CLAUDE.md 里(协作原则、决策记录、历史坑清单)。“一个人 + AI 维护一个 19 万行的开源项目"这件事本身,就是本系列之外另一个可复制的实践。 欢迎你带着你惯用的 AI 编码助手来贡献——AI 时代参与开源的方式,已经和五年前不一样了。
四、系列总收尾:18 篇的完整地图
| 幕 | 篇目 | 回答的问题 |
|---|---|---|
| 愿景与架构 | 00-01 | 中小企业为什么需要自己的 SOC?8G 机器怎么装下? |
| 从零跑起来 | 02-05 | 部署、接告警、发现资产、扫暴露面 |
| 资产地基 | 06-08 | 对账、数据可靠性、身份可信度 |
| AI 副手五部曲 | 09-13 | 底座、查询、可靠性、报告推送、Agent 外放 |
| 工程化三件套 | 14-16 | 告警治理、权限矩阵、CI/CD |
| 账本与出口 | 17-18 | 花多少钱、然后呢 |
00 篇开篇说"中小企业需要自己的安全运营中心”,17 篇算清了"一年约 6,700 元 + 每周 2 小时",这一篇回答"然后呢"——然后,它从一个人的项目,等一群人来把它变成所有人的。
老李的 SOC 稳定跑着。某天他收到一封 Issue 通知——有人按 04 篇把自己的小米路由器接进了采集器,踩了一个 ARP 解析的坑,连复现步骤带日志贴得清清楚楚。 老李照着日志复现、修复、回了个 patch,顺便把对方的测试环境名字写进了致谢。 那台跑着他 SOC 的 8G 机器没有变,变的是仓库的 contributor 列表——从 1 变成了 2。 又过了几个月,是 5。 一个人的 SOC 最大的浪漫,是它最终不再只属于一个人。
【系列导航】《一个人的SOC》总目录(19 篇完整导航)
【上一篇】(17) 成本账本——运行一年,这套系统到底花多少钱
【系列开篇】(00) 中小企业为什么需要自己的安全运营中心
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐
【Gitee 镜像】 https://gitee.com/xiejava/AI-miniSOC
【共建入口】 Issue 模板已就位(部署求助/缺陷报告/功能建议/安全上报),PR 模板含本项目专属自查清单——你的第一个 Issue 或 PR,就是这篇文字最好的续篇。
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!