00 篇说过一个人的 SOC 最真实的痛:
“老板每周要一份安全报告,公司搞安全的就我一个人。”
传统解法是"忍"——周五下午花两小时截图、拼表格、写周报。更糟的不是写报告,是该报告的事没人报告:某台源 3 小时没采上数据、某资产风险分一周涨了 30 分、某系统悄悄过了 EOL——都是事后翻日志才发现的。
这一篇讲 AI-miniSOC 的答案,两件事一起闭环:
- AI 安全报告(F2.2):周报/月报自动出、事件触发自动出、老板要的时候点一下就有
- 主动推送(F4.2):异常主动找人,而不是等人来看
合起来就是标题里那句话——“报告自动出,异常主动来”,人只负责看和决策。
先看全景:一张图说清两件事
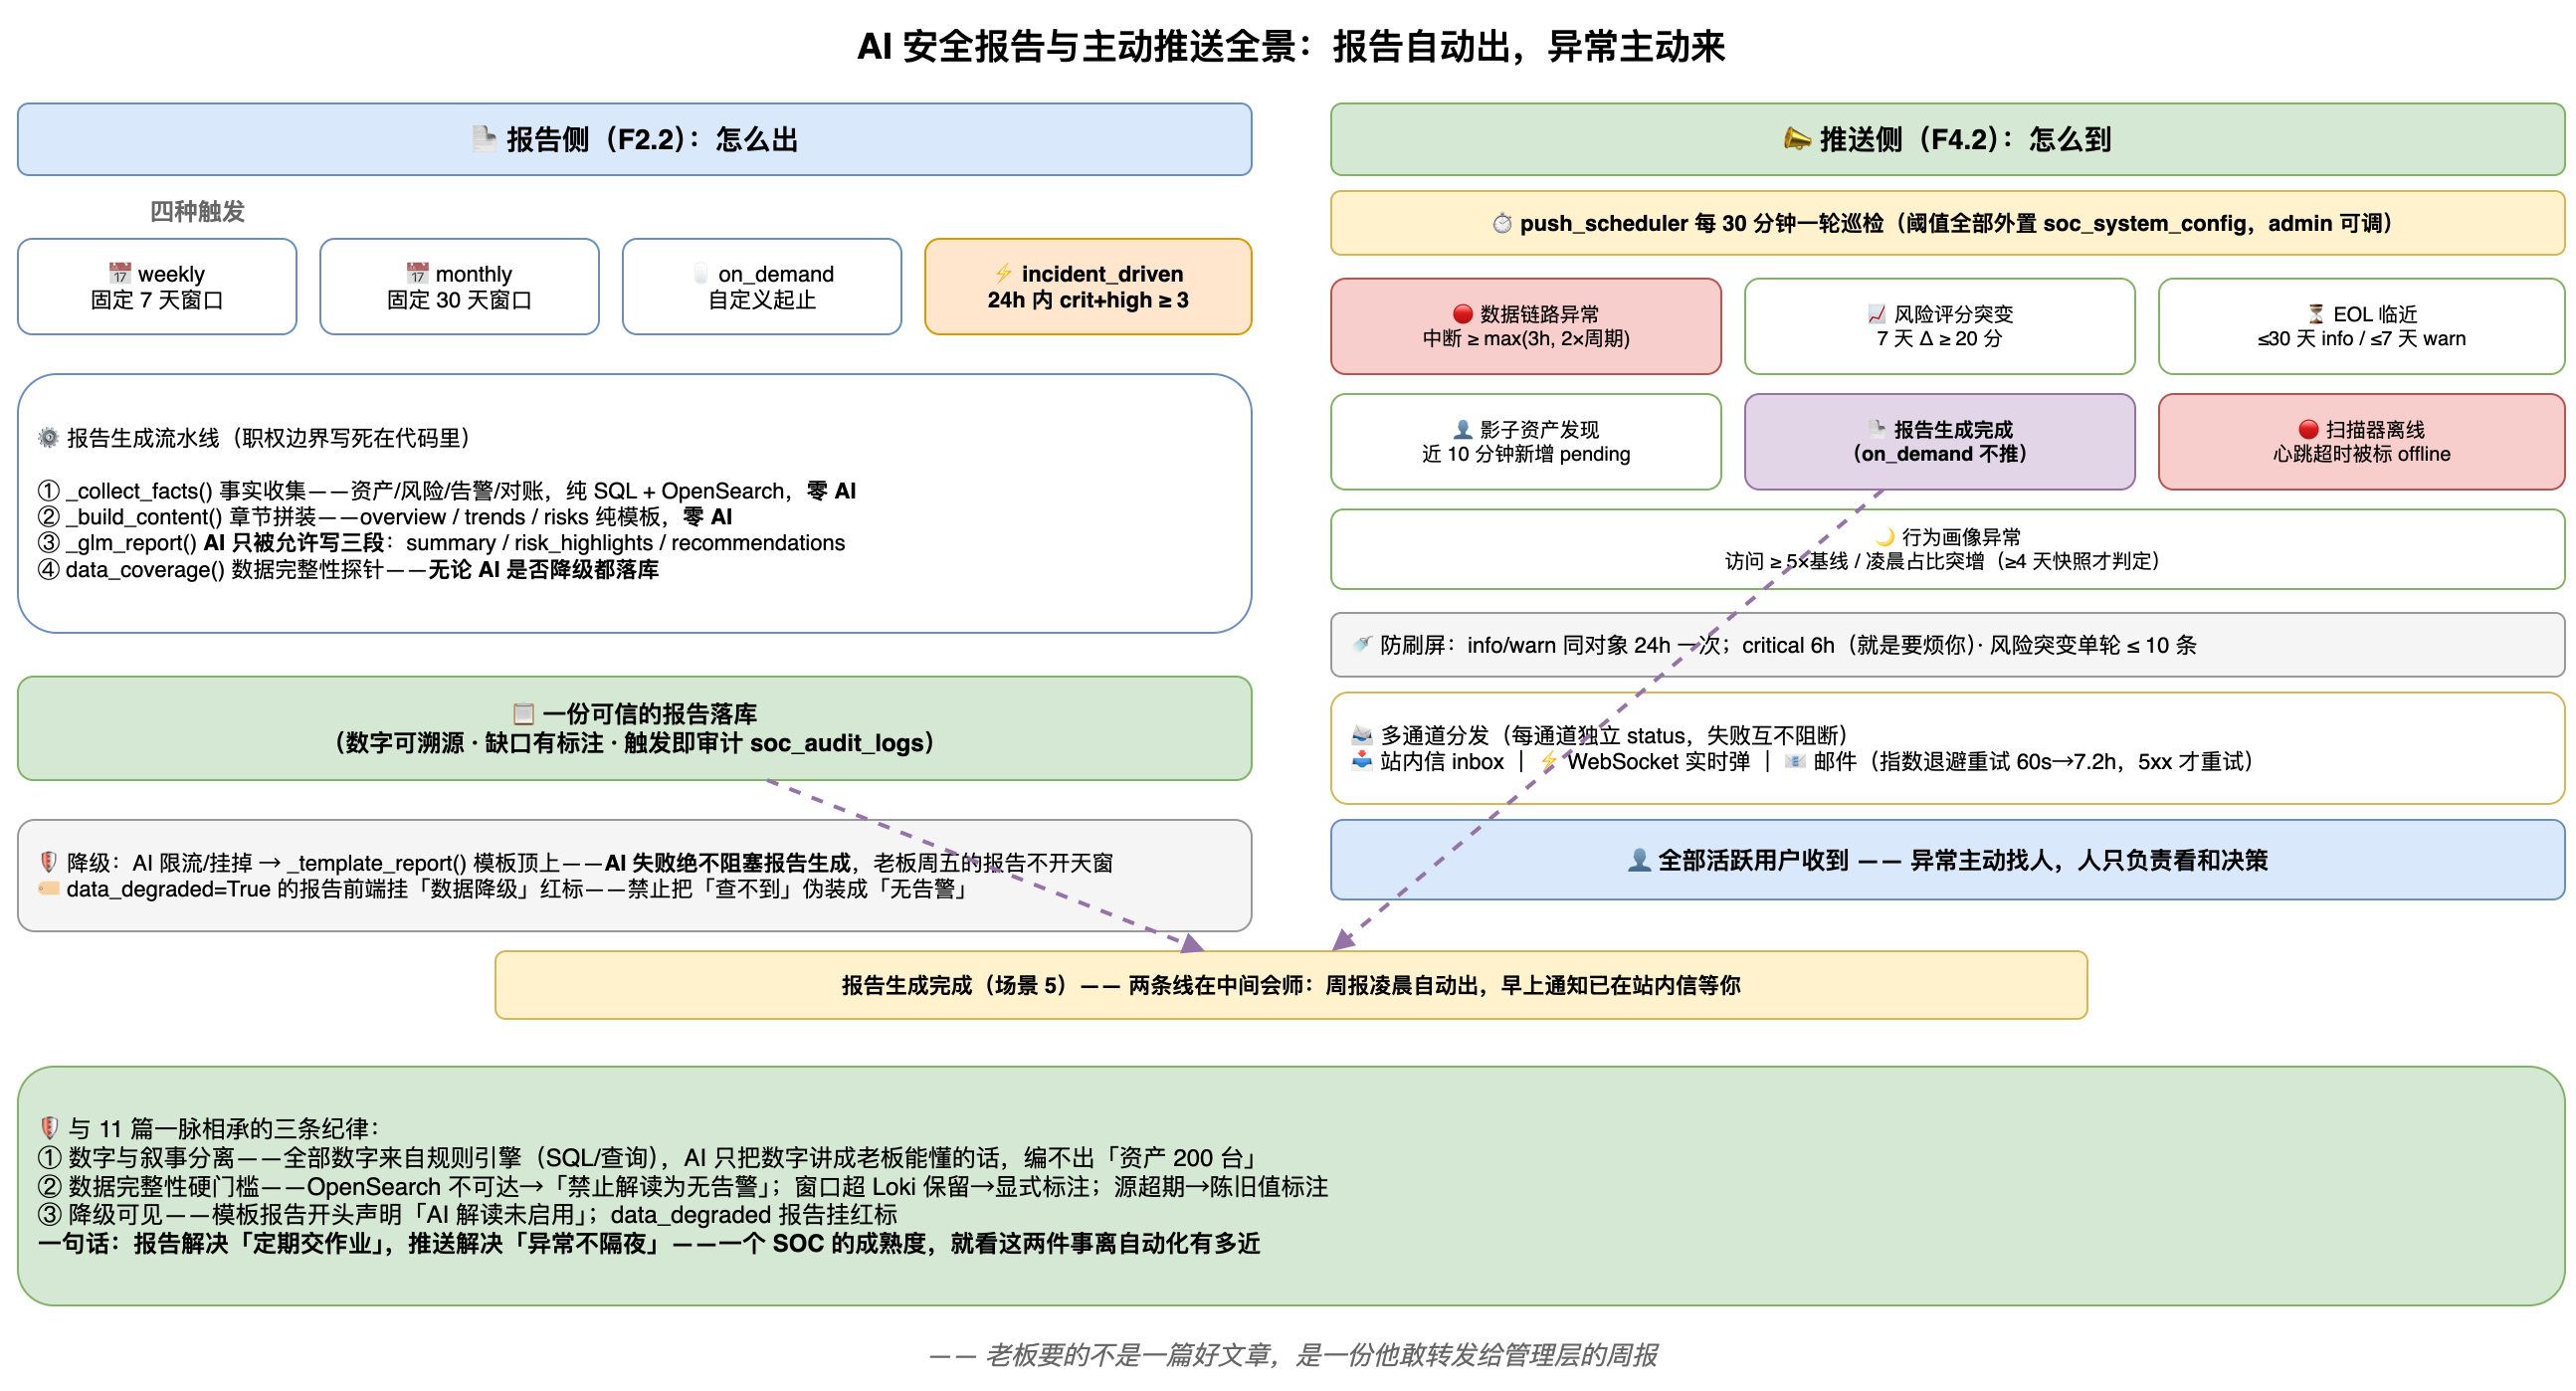
报告侧解决"怎么出":四种触发方式(周报/月报/按需/事件驱动),AI 只负责把数字讲成人话。推送侧解决"怎么到":七个场景每 30 分钟巡检一轮,命中规则就推给所有活跃用户。
两边在中间会师:报告生成完成本身也是一个推送场景——周报凌晨自动生成,早上你打开系统时通知已经在站内信里等你了。
报告侧:AI 只被允许写三段
四种触发类型
先看报告怎么触发(全部来自源码):
| 类型 | 窗口 | 触发方式 |
|---|---|---|
weekly | 固定过去 7 天 | 定时生成 |
monthly | 固定过去 30 天 | 定时生成 |
on_demand | 自定义起止 | 用户点按钮 |
incident_driven | 固定过去 24 小时 | critical+high 告警 ≥ 阈值(默认 3 条)自动触发 |
最有意思的是第四种。传统做法要上消息队列——告警事件入队、消费者订阅、触发报告。一个人的 SOC 不需要这么重:
| |
同步方法,cron 调用或前端按钮触发,达到阈值即落库一份报告。 不引入 Kafka,不引入 RabbitMQ——这是 02 篇"8G 内存装下一个 SOC"哲学的一贯延续:用最简单的机制达到目的,把复杂度留给必要的地方。
AI 的职权边界:三段,仅此而已
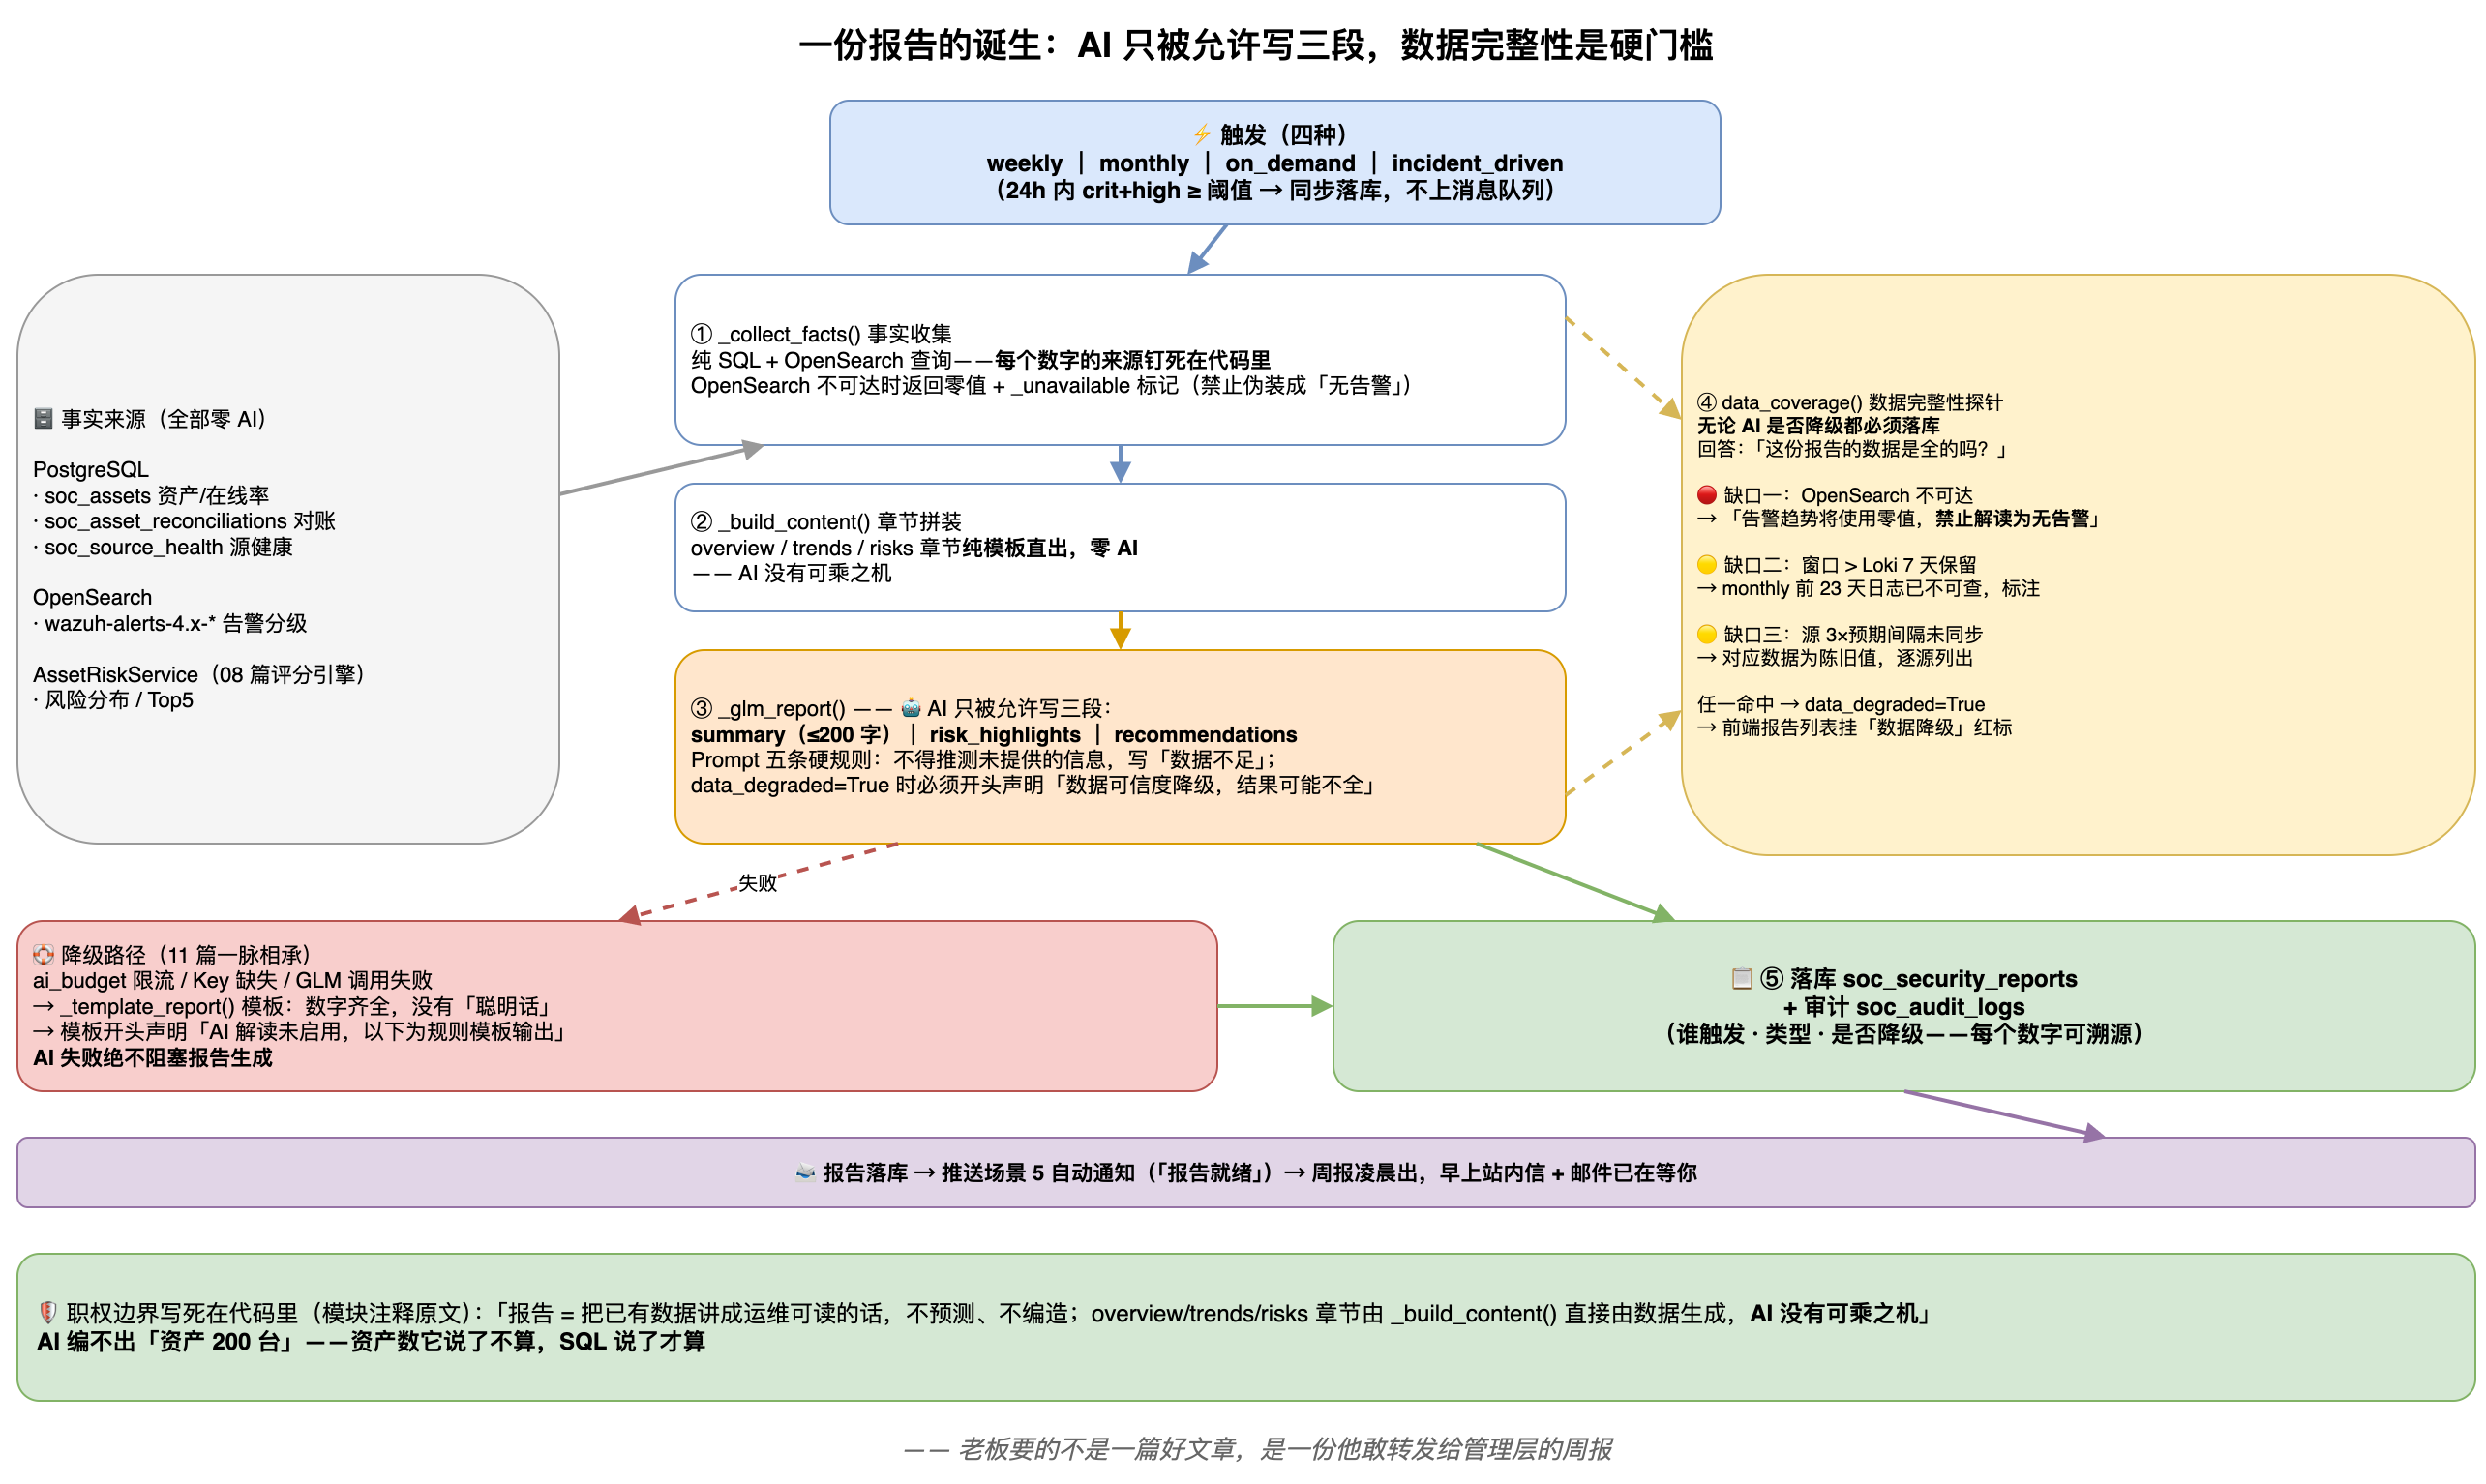
报告内容分两部分,职权边界写得非常死(report_generator.py 模块注释原文):
- 报告 = 把已有数据讲成运维可读的话,不预测、不编造
- overview / trends / risks 章节由
_build_content()直接由数据生成,AI 没有可乘之机- AI 只生成 summary / risk_highlights / recommendations 三段
拆开看每一段的数字从哪来:
_collect_facts()          ← 事实收集(纯 SQL + OpenSearch 查询)
  资产总数/在线率          ← PostgreSQL soc_assets
  风险分布/Top5           ← AssetRiskService(08 篇的评分引擎)
  告警分级计数            ← OpenSearch wazuh-alerts-*
  对账待处理数            ← soc_asset_reconciliations

_build_content()          ← 章节拼装(纯模板,零 AI)
_glm_report()             ← AI 只写:summary / risk_highlights / recommendations
这是 11 篇"数字与叙事分离"铁律的报告版落地——AI 拿到的是已经算好的 facts,它的工作只是把数字讲成老板能懂的话。AI 编不出"资产 200 台"——因为资产数它说了不算,SQL 说了才算。
Prompt 里还有五条硬规则,其中两条值得单独看:
1) 不得推测未提供的信息;如数据不在事实里,写「数据不足」
2) data_degraded=True 时,summary 必须开头先声明「数据可信度降级,结果可能不全」
第 2 条就是 11 篇讲的"降级必须可见"——写进 Prompt 的强制行为,不是靠模型自觉。
data_coverage:数据完整性的硬门槛
这是报告侧我认为最值钱的设计。每份报告落库时都带一个 data_coverage 字段,无论 AI 是否降级都必须有——因为它回答的是一个老板不会问但必须有人回答的问题:“这份报告的数据是全的吗?”
三类缺口会被显式标注:
OpenSearch 不可达 → 告警趋势章节用零值填充,且 impact 写明:
“告警趋势章节将使用零值,禁止解读为「无告警」”
这一句是给未来的你看的。凌晨三点翻到一份"本周告警 0 条"的周报,如果没有这个标注,你会高兴 5 秒钟然后吓出一身冷汗。
报告窗口超过 Loki 保留期 → monthly 报告窗口 30 天,但 Loki 只保留 7 天,前 23 天的上网行为日志已不可查——gaps 里写明"窗口前段的上网行为日志已不可查(仅靠 OpenSearch 告警)"。
数据源超期未同步 → 每个源检查"3 倍预期间隔无成功记录",超期的列入 gaps:“对应源相关的数据为陈旧值”。
前端报告列表页上,data_degraded=True 的报告直接挂红标"数据降级"——这又是 11 篇三条铁律的延续。
把整条生成流水线画出来——注意职权边界和 data_coverage 探针的位置,这是全篇最核心的一张图:
降级路径:与 11 篇一脉相承
AI 不可用时(预算限流 / Key 缺失 / 调用失败),报告照常生成,落 _template_report() 模板——数字齐全,只是没有那句"聪明话"。模板摘要开头也会声明:
数据可信度降级,结果可能不全。(或)AI 解读未启用,以下为规则模板输出。
源码里的降级判断,注意最后一行注释:
| |
AI 失败绝不阻塞报告生成——老板周五要的报告,不会因为模型厂商限流而开天窗。
看真实产出:两份不同触发的报告
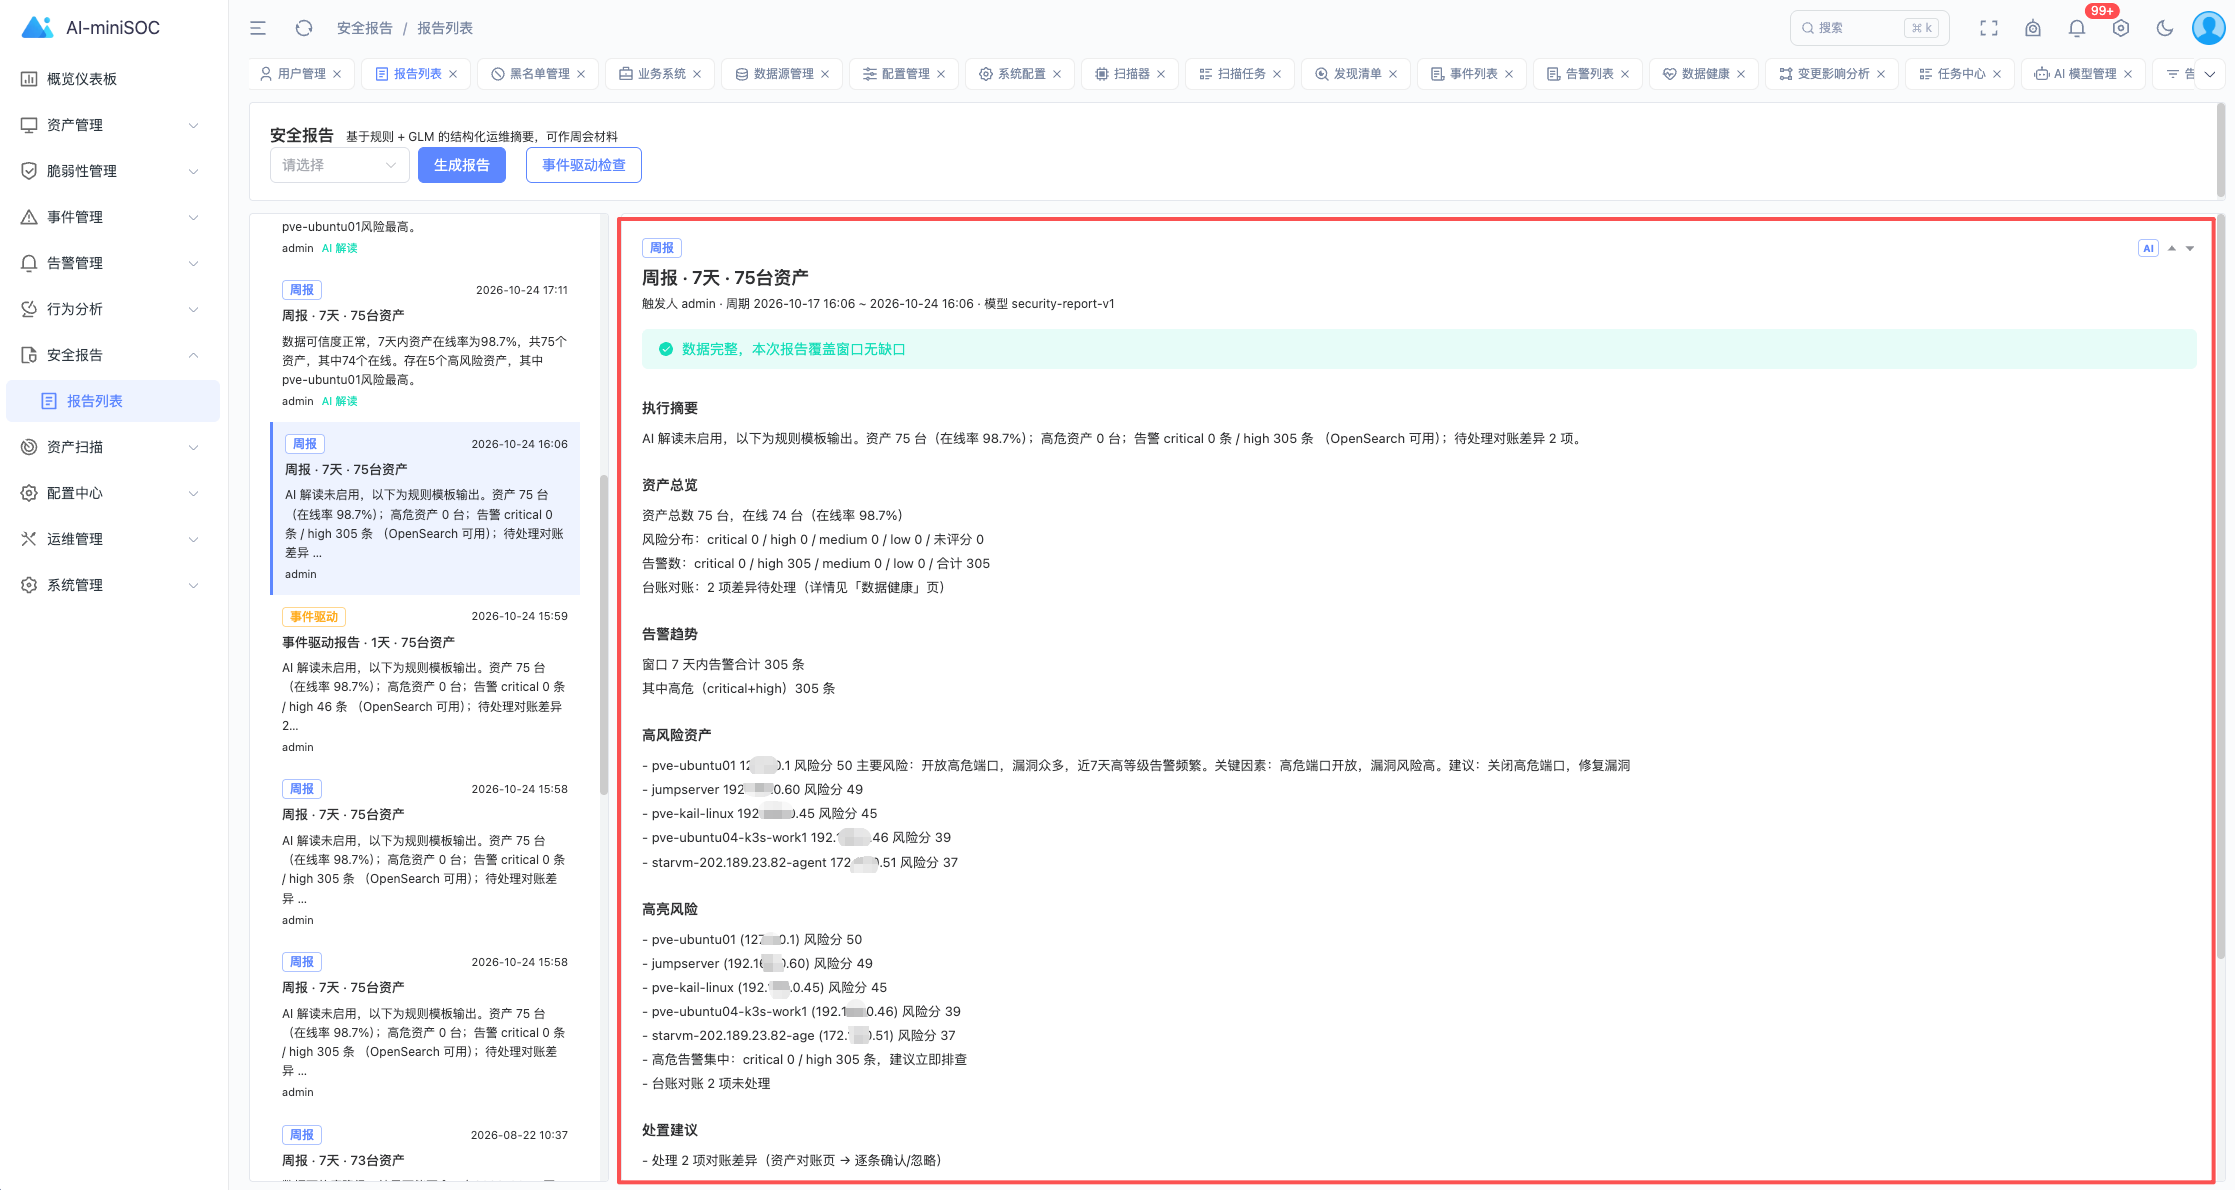
周报(定时触发)。报告列表里按类型归档,每周一份自动落库——周报、月报、事件驱动各成序列,谁触发、何时生成、窗口多长,列表页一目了然:
事件驱动报告(incident_driven)。点开一份 24h 内 critical+high 告警达阈值的报告详情:摘要由 AI 写成一段人话,章节表格的数字全部来自规则引擎——注意 AI 摘要开头那句"数据可信度降级"声明,正是 data_coverage 探针在工作:
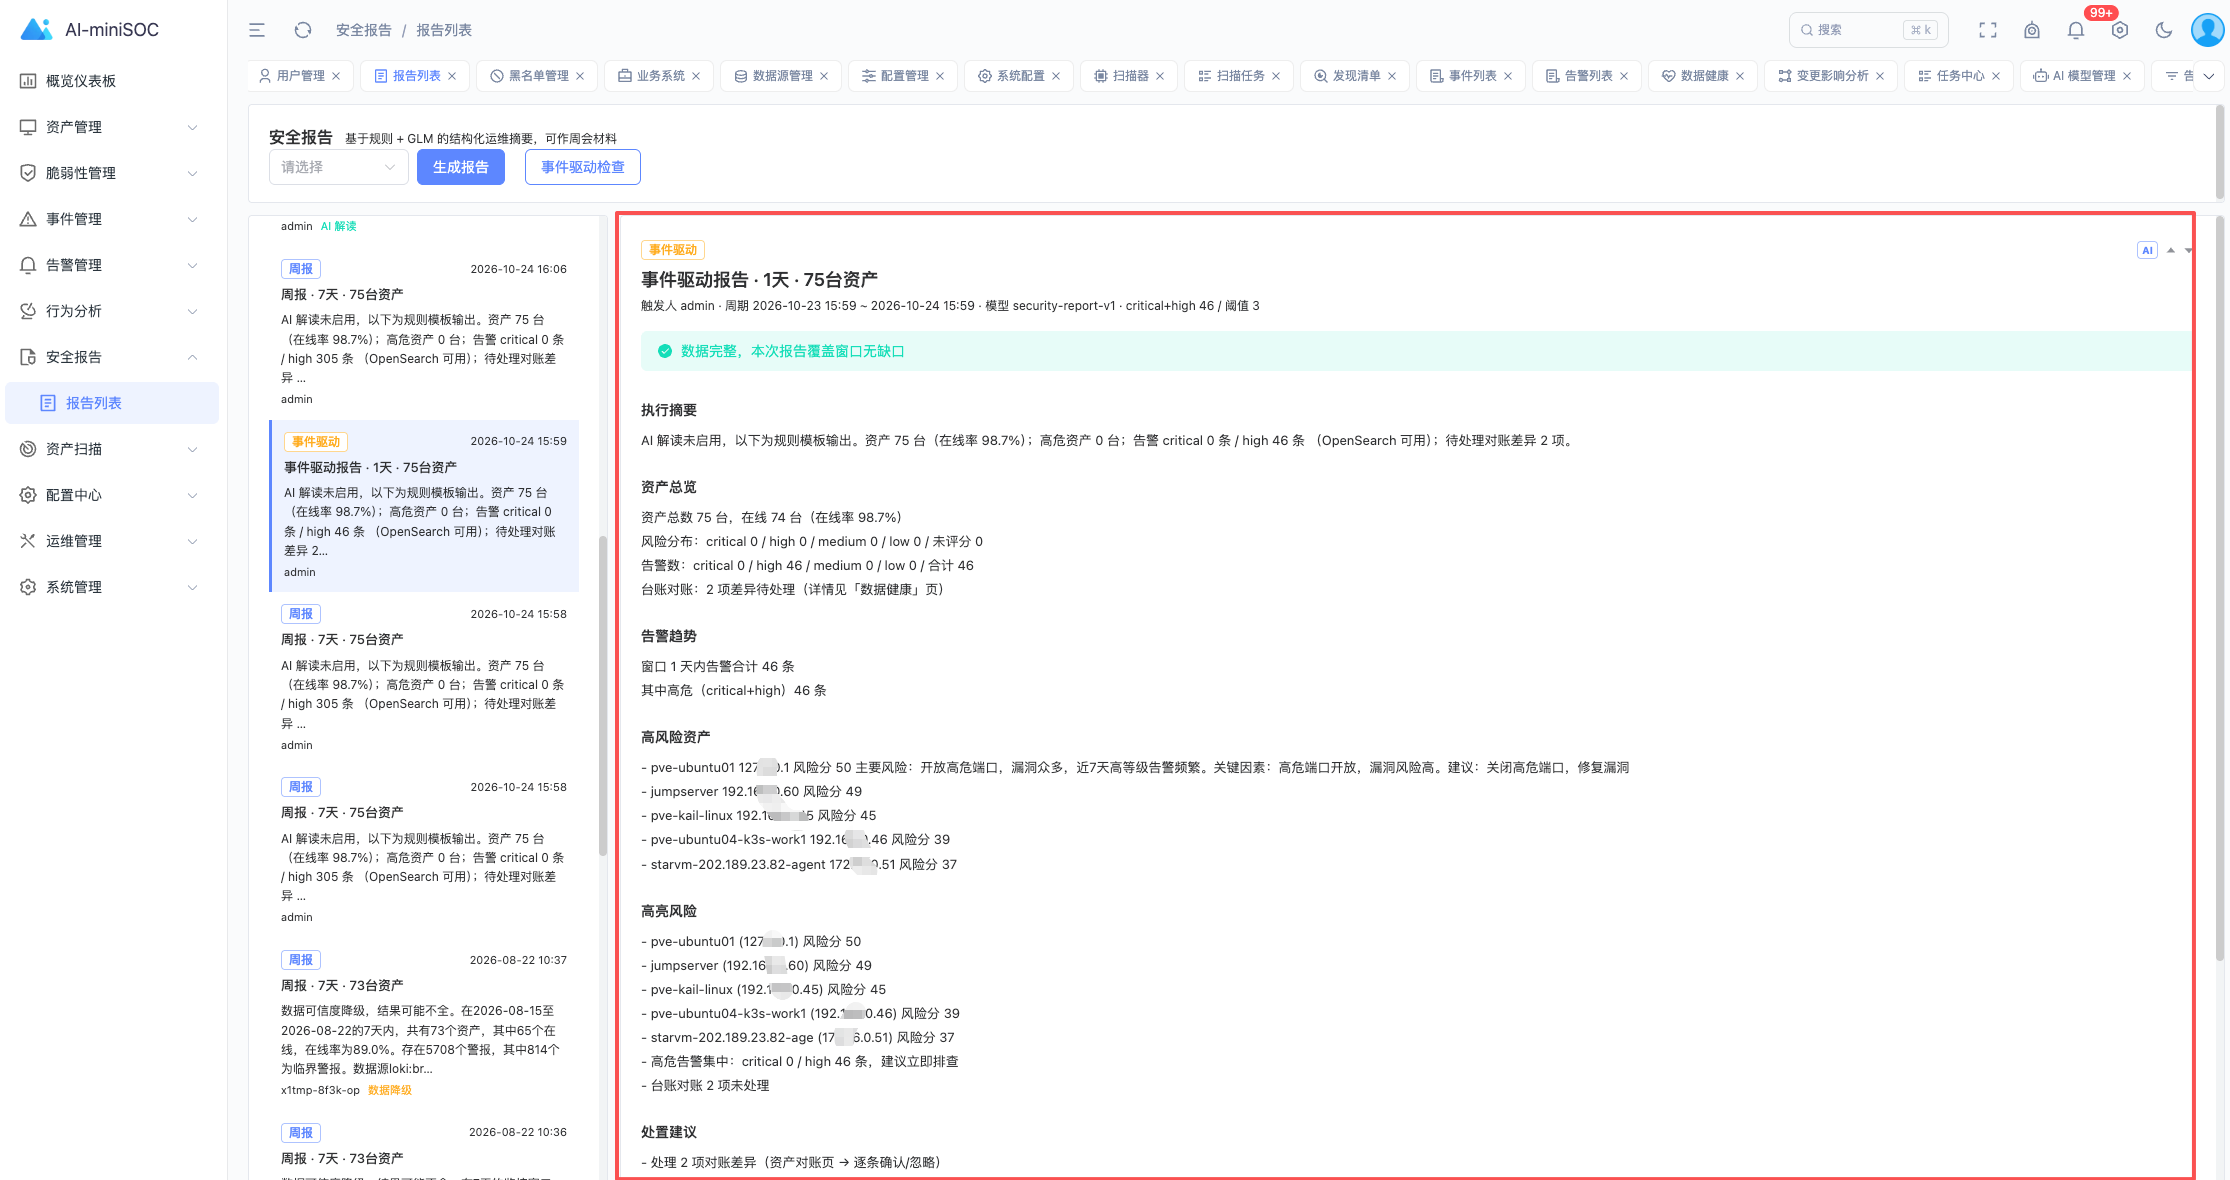
两份报告放在一起看:定时报告解决"定期交作业",事件报告解决"出了事留档案"——事后复盘时,你需要的不是一段描述,而是一份触发时刻的完整快照。
推送侧:七个场景的主动巡检
场景全景
推送服务(push_notification_service.py)每 30 分钟跑一轮巡检,命中规则就推给全部活跃用户(站内信 + WebSocket 实时弹)。规划时叫"五种场景",实际交付时已经长到七个(还有第八个复用场景 1 自动覆盖):
| # | 场景 | 级别 | 触发条件 |
|---|---|---|---|
| 1 | 数据链路异常 | critical | 源中断 ≥ 3h(有预期间隔时取 max(3h, 2×周期)) |
| 2 | 风险评分突变 | warn | 7 天窗口内评分上升 ≥ 20 分 |
| 3 | EOL 临近 | info→warn | 距 EOL ≤30 天 info;≤7 天或已超期 warn |
| 4 | 影子资产发现 | warn | 近 10 分钟新增 pending shadow 差异 |
| 5 | 报告生成完成 | info | weekly/monthly/incident_driven 落库 |
| 6 | 扫描器离线 | critical | agent 心跳超时被标 offline |
| 7 | 行为画像异常 | warn | 访问量 ≥ 5 倍基线,或凌晨占比突增 ≥ 40% |
| — | scanner 源异常 | critical | 复用场景 1,scanner:* 键自动覆盖 |
逐个看设计要点(都在源码注释里):
场景 1 的阈值为什么是 max(3h, 2×周期):一个每 5 分钟采一次的源断了 3 小时肯定有问题;但一个每天采一次的源,3 小时不叫事——阈值自动放大到 2 个周期。一刀切的阈值是懒人设计,好的阈值要跟着采集节奏走。
场景 2 的"单点跳过":窗口内历史评分不足 2 条的资产直接跳过——单点无趋势可言,一次评分从无到有不叫"突变 40 分",是基线还没建立。
场景 7 的冷启动保护:行为画像不足 4 天快照的主体不判定——“1 天当天 + ≥3 天基线”,否则新接入的设备第一天必然"激增"(基线是空的)。且只输出信号不定性:“可能为批量下载/爬取/失陷外联,请人工复核”——推送负责叫人,定性是人的事。
场景 5 的贴心细节:on_demand 报告不推——那是你自己点的,你当然知道它生成完了。推送的天职是告知"你不知道的事",用户主动发起的动作再推一遍就是噪音。
不只是站内信。通知分发器走多通道设计——inbox(站内信)+ WebSocket 实时弹 + 邮件,每个通道独立 status、失败互不阻断。邮件通道在「系统管理 → 通知通道」配置:SMTP 参数加密存储,保存前可先「连接测试」「发送测试邮件」验证;下方模板表列出了每类通知的主题模板——数据链路中断、EOL 临近、风险突升、影子资产四类场景有专门的邮件模板,且支持 DB 覆盖内置(改坏了删掉覆盖即回退):
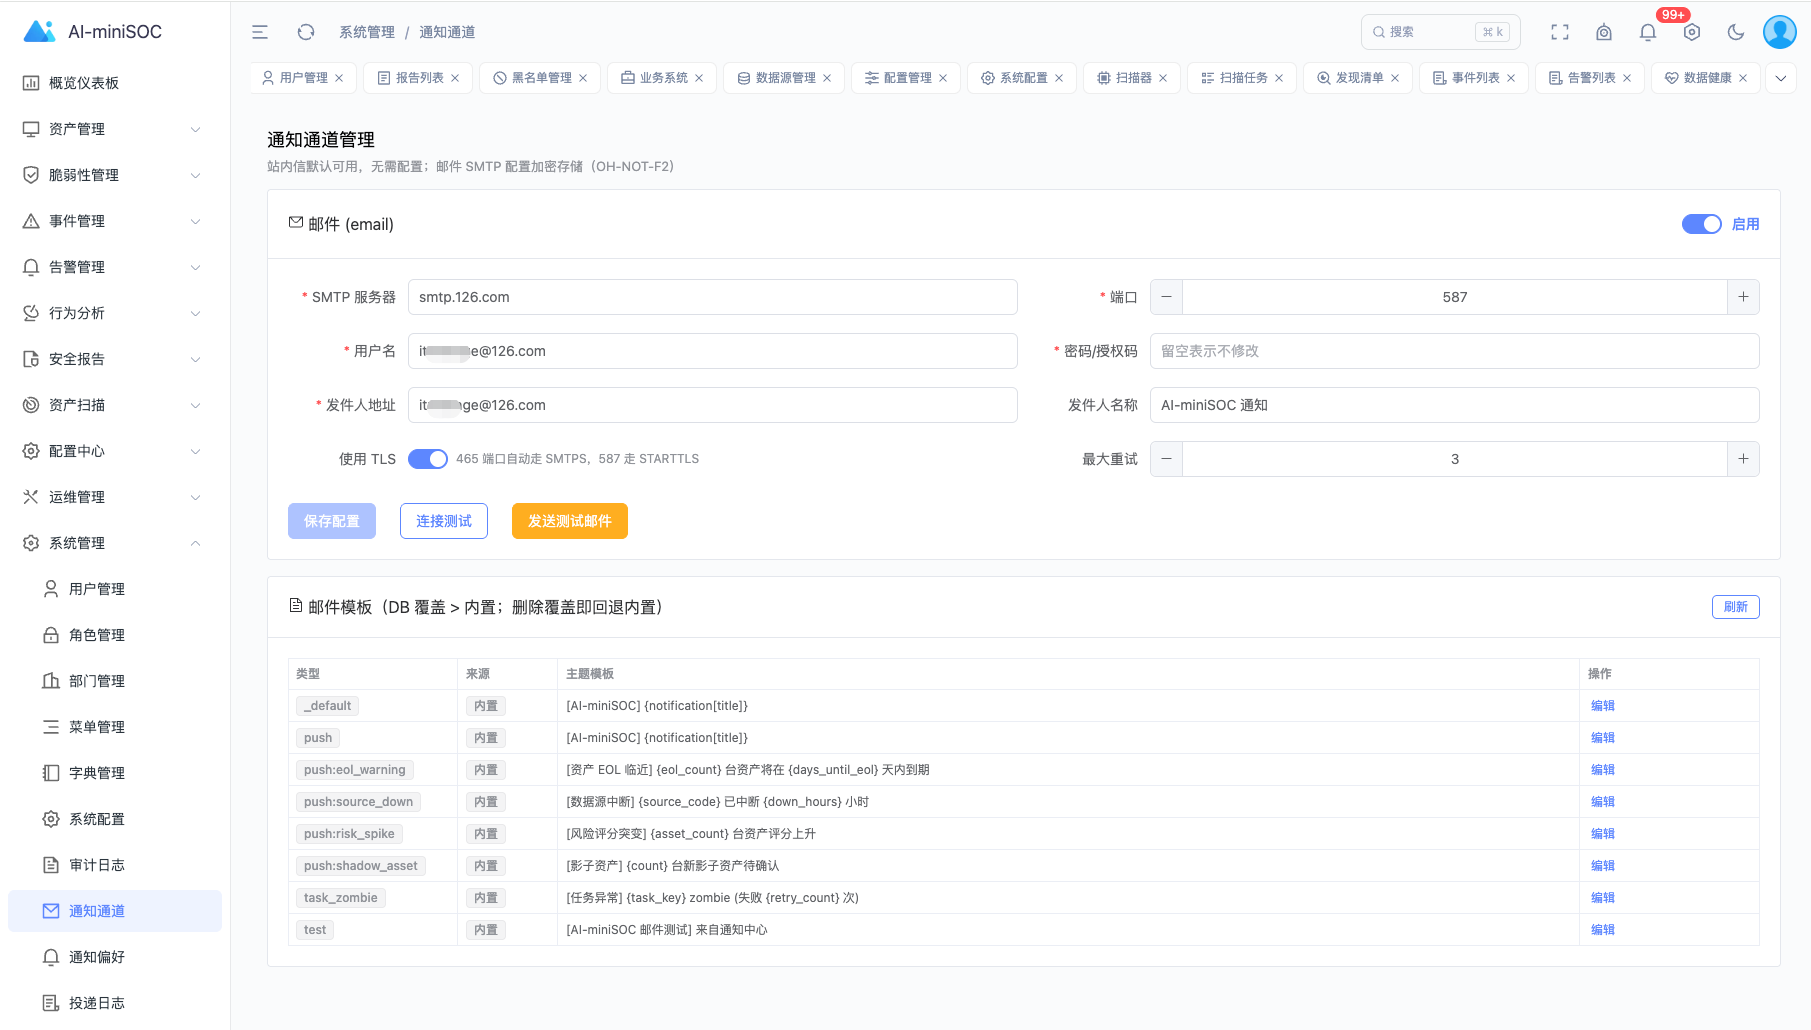
投递侧的工程细节:邮件走独立 worker,60 秒一轮扫 pending 队列,指数退避重试(60s / 300s / 1500s / 3600s / 7200s,达到最大重试次数后标 failed),5xx 才重试、4xx 不浪费重试——配置页上那个"最大重试"步进框控制的就是它。
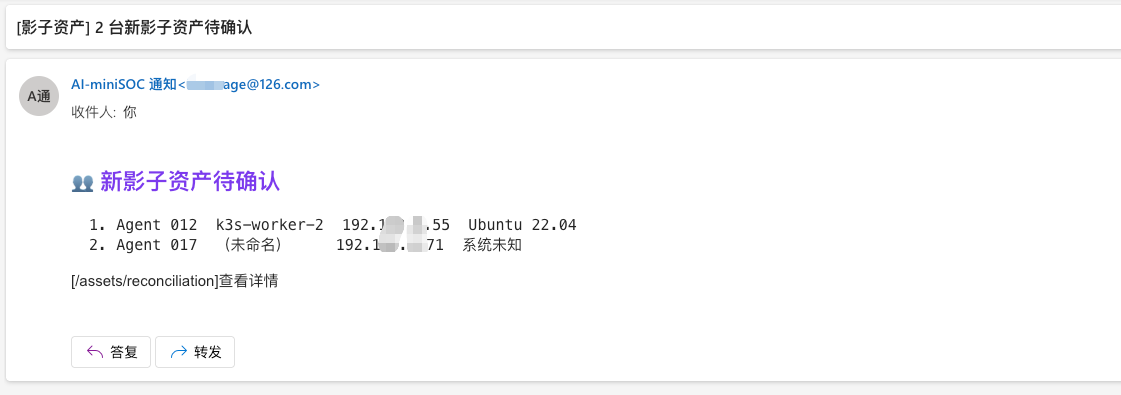
实际投递效果。下面这封"影子资产待确认"邮件就是场景 4 的产出——两台 Wazuh 里存在、台账里没有的机器(一台 k3s 工作节点、一台未命名主机),等你确认:
场景 3(EOL)的手机端实收效果。一台 Windows 11 机器过了 EOL 十二天没人管——如果不是巡检主动发邮件,大概率要等某次漏洞爆发才想起来。注意邮件细节:资产名、IP、系统版本号、EOL 日期、超期天数、处置建议(升级/下线)一应俱全,红色告警样式 + 「查看详情」直达资产页:
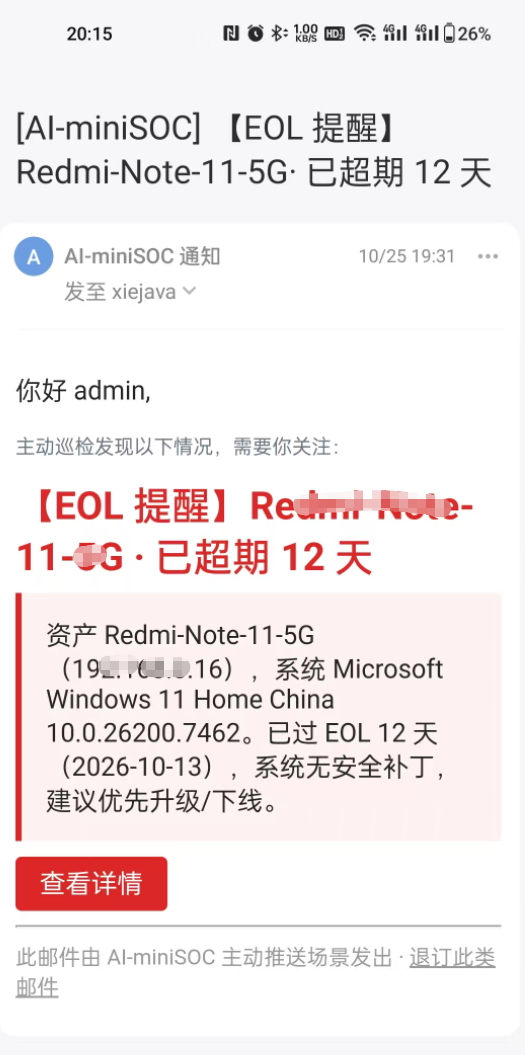
这就是"异常主动来"的完整闭环:巡检发现问题 → 邮件推到你手机 → 点「查看详情」进入处置——你不在电脑前,SOC 也不会哑。
防刷屏:去重设计
一个人的 SOC 也怕狼来了。同类通知去重规则:
- info / warn:同对象 24 小时内只推一次
- critical:6 小时窗口,允许重复提醒(critical 就是要烦你,直到你处理)
去重键(dedup_title)的设计有个真实踩坑,后面踩坑节展开。
规则外置:admin 可调,不用改代码
所有阈值不在代码里写死,而是外置到 soc_system_config(category='push_rules'),深合并默认值后生效:
| |
觉得风险突变 20 分太敏感?admin 接口改成 30,60 秒缓存过期后生效。EOL 提醒想只保留 warn 档?把 info_days 改成 7。 每个场景有独立开关——报告推送关掉、链路告警留着,随你。
工程约束:为什么扫描器离线告警不走 watchdog
源码注释里有个值得抄的设计决策。扫描器心跳是 scanner_watchdog_scheduler 每 60 秒判定的,但通知不在 watchdog 里发:
通知不在 watchdog 里发(后台线程调 async _push 会 RuntimeWarning),统一由 push_scheduler 每 30min 调本方法负责。
watchdog 只负责判定并标红,push_scheduler 统一负责告知。判定和告知分离——每个后台任务只干一件事,异步调用的边界也干净了。
17 个单测:推送逻辑的回归底线
这套推送有 17 个单测(test_push_notifications.py),覆盖表直接抄测试文件头注释:
- 源健康异常:中断超阈值 / expected_interval 双周期 / 从未成功
- 风险突变:7 天 Δ≥20 触发 / 单点跳过 / 低于阈值不触发
- EOL 临近:30 天 info / 7 天 warn / 已超期 warn / 窗口外不推
- 频控去重:窗口内第二轮 0 发送;规则关闭 0 发送
- 规则存取:深合并保存/读取
- 接收人:仅 active 用户
注意"窗口内第二轮 0 发送"——去重是有测试保护的,不是"应该没问题"。改去重逻辑跑一遍测试,刷屏回归无所遁形。
踩坑记录:五个真实翻车点
坑一:EOL 去重键里带天数,每轮巡检都重推。 最初去重键是"【EOL 提醒】xxx 剩 7 天"——第二天变成"剩 6 天",字符串不同,去重失效,每 30 分钟推一遍,一上午被同一个资产的 EOL 提醒轰炸。修法:去重键只用稳定前缀(资产名),变动部分(剩余天数)放 title 尾部。源码注释原话:“变动部分放尾部,否则每轮巡检都会重复推送”。
坑二:告警章节零值被误读为"无告警"。 OpenSearch 挂了,告警查询返回空,早期版本的报告里就真的显示"本周 critical 0 条"。看报告的人(包括未来的自己)无从知道这是"没有"还是"查不到"。修法:_unavailable 标记 + data_coverage 强制 gap + “禁止解读为无告警"写进 impact。
坑三:monthly 窗口 30 天 > Loki 保留 7 天。 月报前 23 天的上网行为日志物理上已不存在,但报告不会告诉你。这不是 bug 是基础设施现实(Loki 默认 7 天保留,应用层改不了),修法是接受约束并文档化:gaps 里显式标注"窗口前段日志已不可查”,报告的数据说明章节可见。
坑四:后台线程直接调 async 推送函数。 watchdog 在后台线程里跑,直接 await 推送会触发 RuntimeWarning(事件循环不在线程里)。修法就是上面说的判定/告知分离——所有推送收敛到 push_scheduler 的异步循环里。
坑五:行为画像冷启动误报。 新设备接入第一天访问量必然"远超基线"(基线为空),凌晨占比也没有历史可比。修法:≥4 天快照才判定 + min_total=500 过滤小样本噪音——宁可晚几天开始监控,不制造第一天就报警的狼来了。
为什么这套东西比"AI 自动写周报"的产品靠谱
市面上"AI + 报告"产品的卖点是"AI 多能写"——千字分析、图表解读、趋势预测。但安全报告的第一属性不是文采,是可信。
AI-miniSOC 反着做:
- AI 只被允许写三段,章节结构、全部数字由规则引擎产出
- data_coverage 硬门槛——数据缺一段就必须明说,“禁止解读为无告警”
- 触发即审计——每次报告生成落
soc_audit_logs(谁触发的、类型、是否降级)
再叠加 11 篇的降级设计:模型挂了模板顶上,报告永远出得来、数字永远对、降级永远可见。
老板要的不是一篇好文章,是一份他敢转发给管理层的周报。 敢转发的底气来自:每个数字可溯源,每处数据缺口有标注。
常见问题
Q:周报/月报什么时候自动生成?
A:推送调度器每 30 分钟巡检一轮(PUSH_SCHEDULER_INTERVAL_MINUTES 可调),事件驱动检查有独立接口 POST /reports/check-incident-trigger 供 cron 或前端按钮调用。自动生成的报告落库后,场景 5 会推通知告诉你"已生成"——早上打开系统,周报和通知都在等你。
Q:推送会不会很吵?
A:三层防吵:同类去重(info/warn 24h、critical 6h);每场景独立开关(不关心的场景直接关);单轮上限(风险突变单轮最多推 10 条,防一次资产批量变更刷屏)。实际跑下来一天通常是个位数的通知,且 critical 类值得被吵。
Q:推送发到哪?只有站内信的话我不在线就看不到了?
A:三通道并行:站内信(inbox)+ WebSocket 实时弹 + 邮件。用户可按通道设置偏好,每个通道投递状态独立落库(soc_notification_dispatch_logs),任一通道失败不影响其他通道。邮件带退订链接,5xx 自动指数退避重试、4xx 不浪费重试。人不在系统前,critical 也会到邮箱里找人。
Q:为什么推送只发站内信 + WebSocket,不接钉钉/微信?
A:渠道抽象已经就位(notification_dispatcher 多通道设计,每通道独立 status 互不阻断),Phase 1 先落 inbox + WebSocket 是零新增基础设施的务实选择。邮件 worker、外部 IM 是后续按需打开的事——架构留了口子,但不为"将来可能要"提前写代码。
Q:incident_driven 的阈值 3 条会不会太高/太低?
A:外置在 soc_system_config(category='reports'),改配置即生效,不用动代码。告警基线大的环境调高些,安静环境调低——阈值是运营参数,不是架构常量,这也是全系列一贯的"规则外置"打法。
Q:怎么给我的系统加这套?
A:报告侧三步:① 先写 _collect_facts()——把所有数字来源钉死在 SQL/查询里;② 写 data_coverage 探针——数据不全必须显式标注;③ 才轮到 AI 写三段。推送侧两步:① 场景函数只做"判定 + 组装文案";② 去重、发送、频控收敛到一个 _push() 基础设施。顺序不能反——先有可信的数字,才有资格谈推送。
收尾:12 在系列中的位置
| 系列主线 | 篇目 |
|---|---|
| AI 底座 / 消费点 / 可靠性 | 09 / 10 / 11 |
| AI 报告与推送(成果输出) | 12(本篇) |
| AI Agent 与 MCP | 13 |
| 工程化(告警治理/权限/CI-CD) | 14-16 |
到这里,“AI 副手"从底座(09)、到用法(10)、到可靠性(11)、到成果输出(12)走完了完整闭环:数字来自规则引擎,人话来自 AI,异常主动找人,人只负责决策。 13 篇把视角再拉高一层——让 Claude 通过 MCP 直接操作你的 SOC。
老李现在每周五不再写周报了。 周五早上打开系统,站内信躺着一条 info:【报告就绪】安全周报(10.19–10.25)。 点开:资产 187 台在线率 94%,critical 告警 2 条已处置,风险分 Top1 是那台该退役的 CentOS 6。 他花五分钟核对数字(数字都来自规则引擎,他核的是"要不要给老板加一句话”), 转发,收工。 而上周三凌晨,真正救他的是另一条推送:【数据链路异常】tplink 已 3.2h 无成功—— 那天路由器的采集脚本挂了,如果没有主动推送,他要到周五写周报时才会发现整整两天没数据。
报告解决"定期交作业",推送解决"异常不隔夜"。一个 SOC 的成熟度,就看这两件事离自动化有多近。
【系列导航】《一个人的SOC》总目录(持续更新)
【上一篇】(11) 诚实降级——当 AI 不可靠时,SOC 的兜底设计
【系列开篇】(00) 中小企业为什么需要自己的安全运营中心
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐
【Gitee 镜像】 https://gitee.com/xiejava/AI-miniSOC
【交流】 你的环境里最该主动推送的是哪个场景?欢迎来 Issue 对答案——被"事后才发现"坑得最惨的一次,值得写成一个推送场景。
下一篇(预告):(13) AI Agent 与 MCP——让 Claude 直接操作你的 SOC(连载中,敬请关注)
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!