上一篇 (08) 身份可信度评分收掉了资产主题——你的 SOC 到这里已经能"看得见、看得真、不被骗、信得对"。
但看见之后呢?
00 篇算过那笔账:传统 SOC 需要 5-10 人的团队三班倒,盯屏、分诊、溯源、写报告。一个人的 SOC 凭什么转得动? 答案从这一篇开始兑现:
LLM 当你的副手。你干"拍板"的活,它干"读和写"的活。
具体替你干什么?10 件事,每一件都是安全运营里真实的工时:
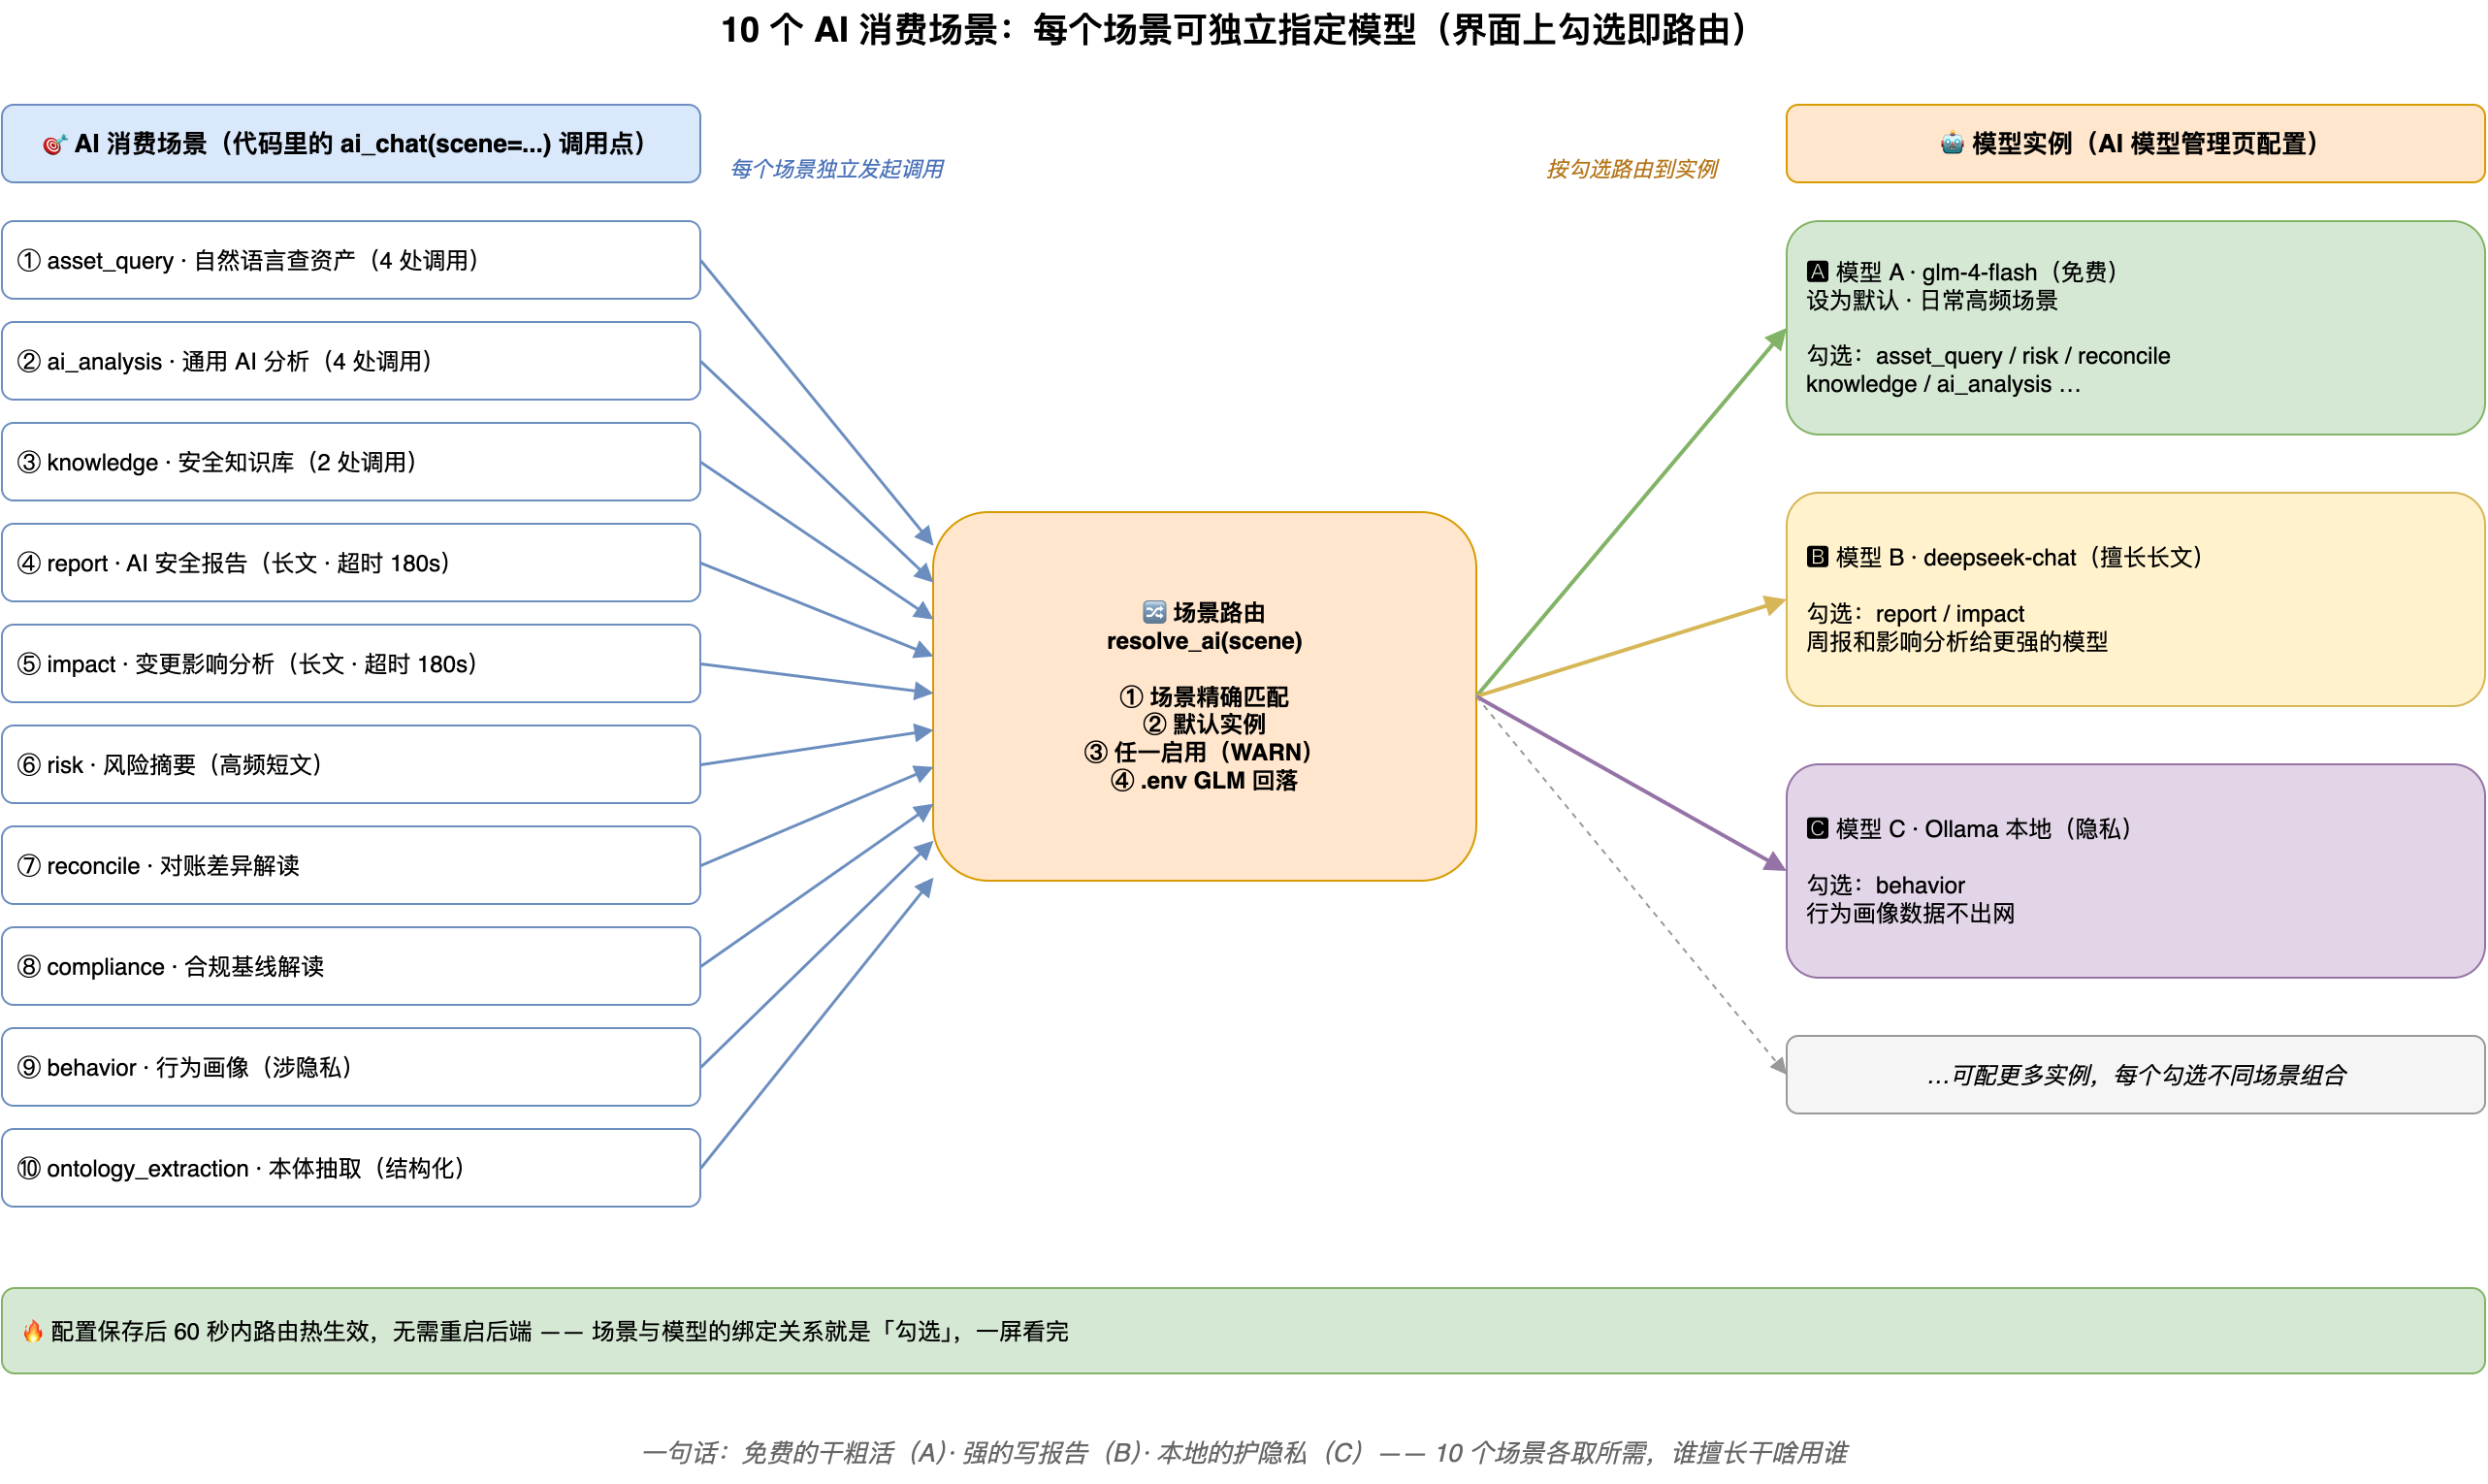
10 个场景:LLM 替你干的活
先看全景。这 10 个场景覆盖了安全分析师日常"读和写"的全部工作面:
查:把"查数据"变成"问一句话"
| 场景 | 你以前要做的 | 现在你只要 |
|---|---|---|
asset_query 自然语言查资产 | 记 SQL/过滤器语法,拼查询条件 | 输一句"找出所有 Windows 系统的主机" |
knowledge 安全知识库 | 翻文档、搜收藏夹 | 问"等保对日志留存的要求是什么" |
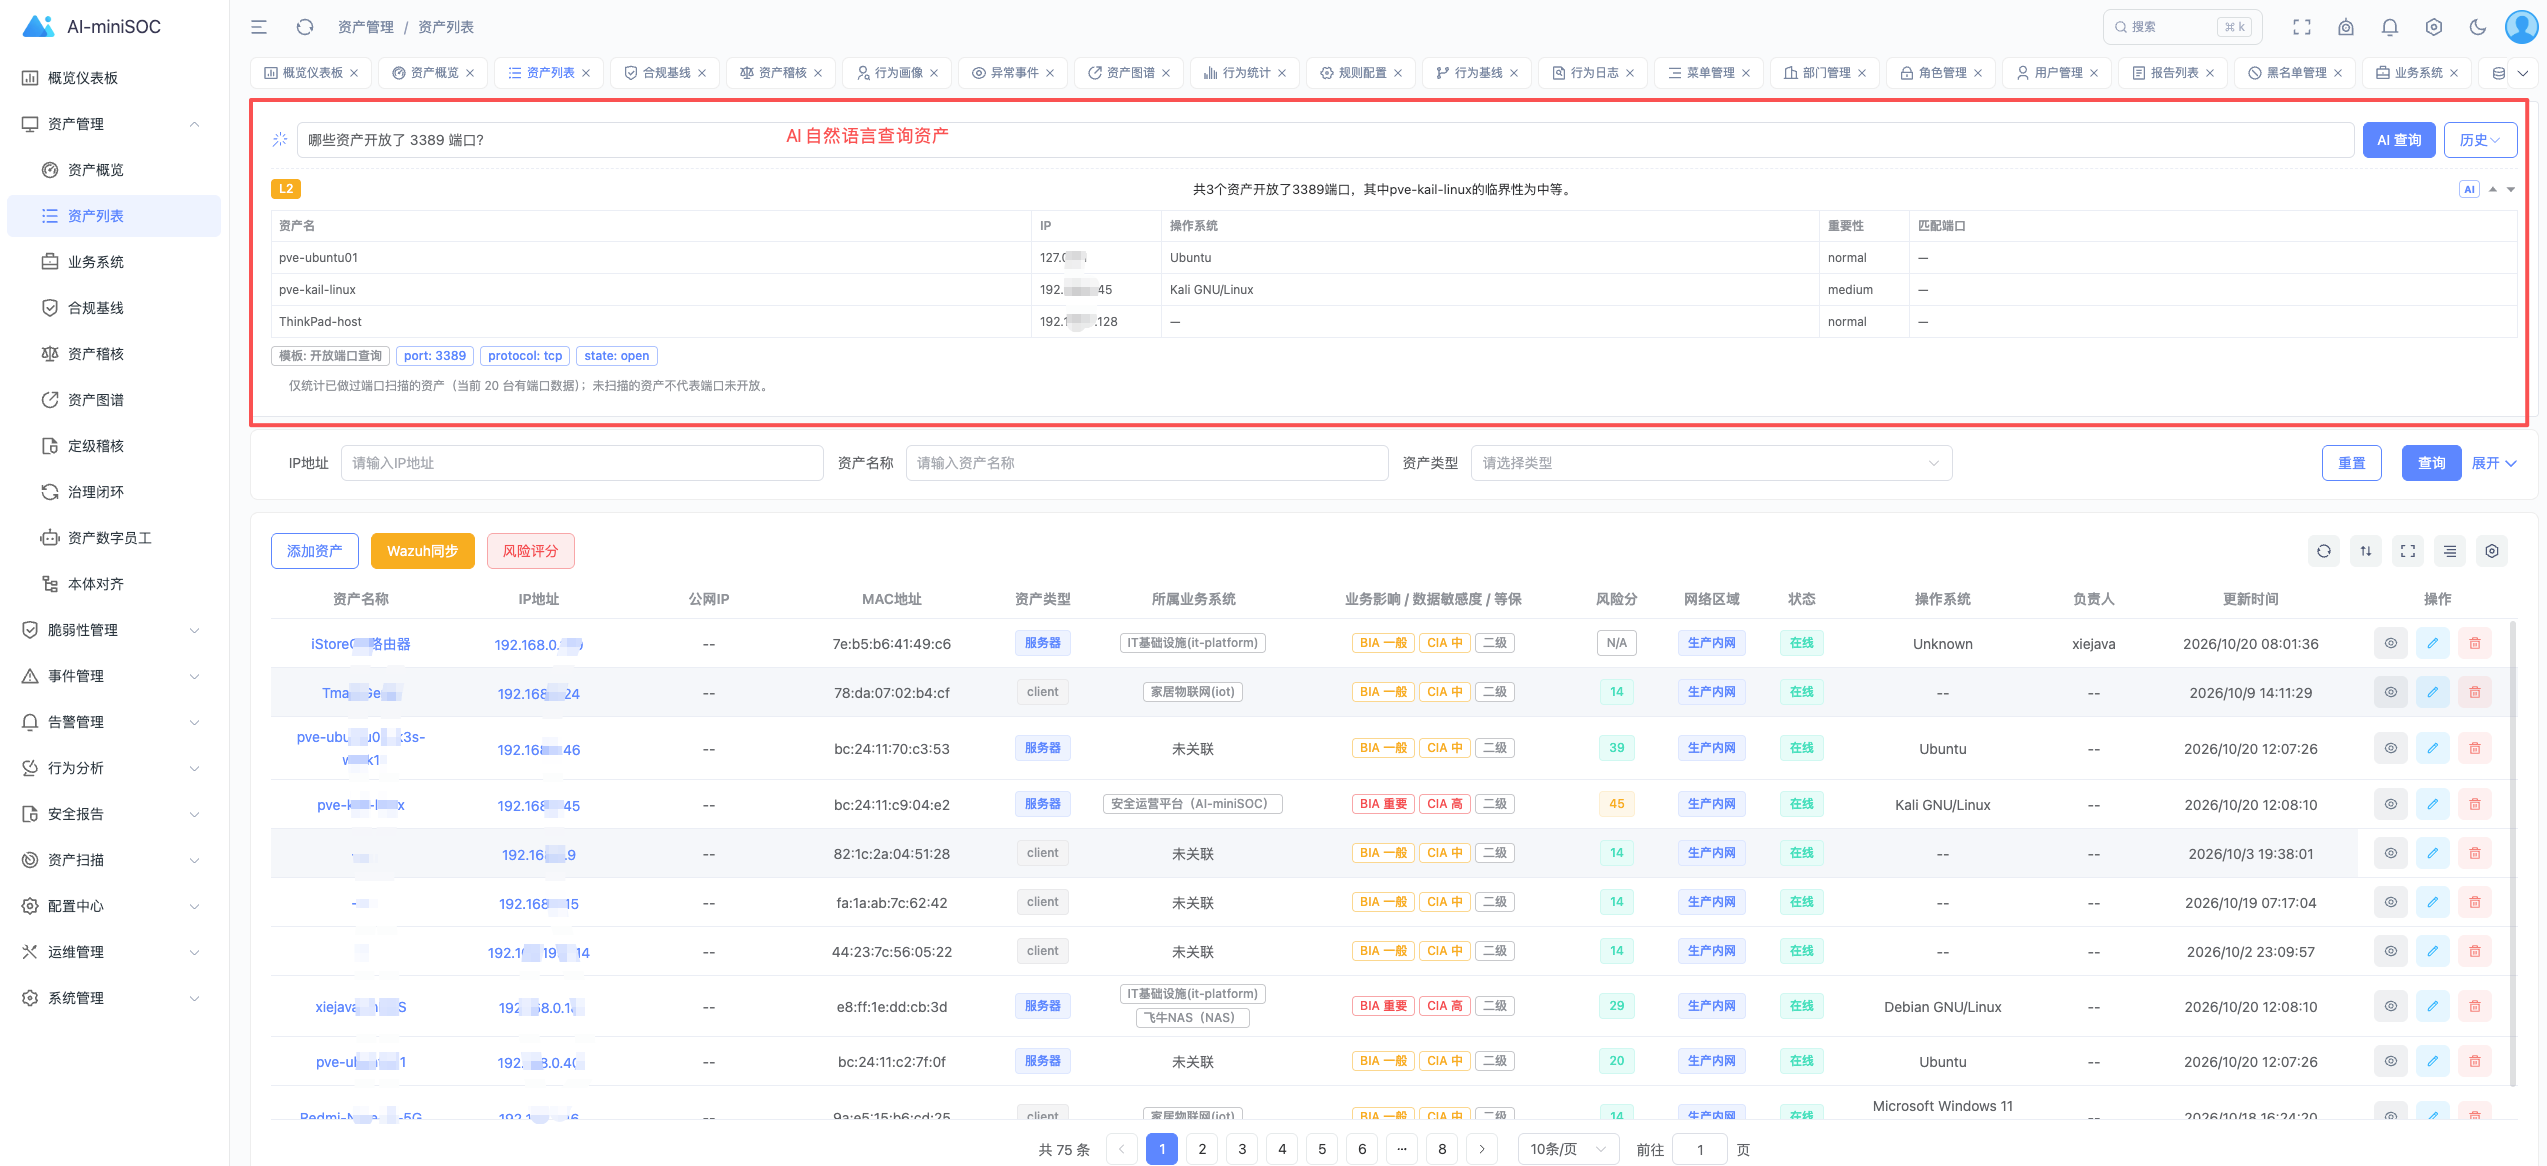
asset_query 是用得最勤的场景(后端 4 处调用点)——资产台账几十上百条时,“哪些资产开放了3389端口"这种问题,一句话出答案。
判:把"逐条看告警"变成"AI 先筛一遍”
| 场景 | 你以前要做的 | 现在你只要 |
|---|---|---|
risk 风险摘要 | 打开风险页逐条读数字 | 看一段人话摘要:“本周风险上升主因是 3 台主机开放了公网 SSH” |
reconcile 对账差异解读 | 对着 06 篇的三类差异表逐行判断 | AI 告诉你"这批 shadow 大概率是 DHCP 重新分配,建议纳管" |
compliance 合规基线解读 | 逐条对照基线规则打勾 | AI 列出"当前 3 项不达标,最优先补日志留存" |
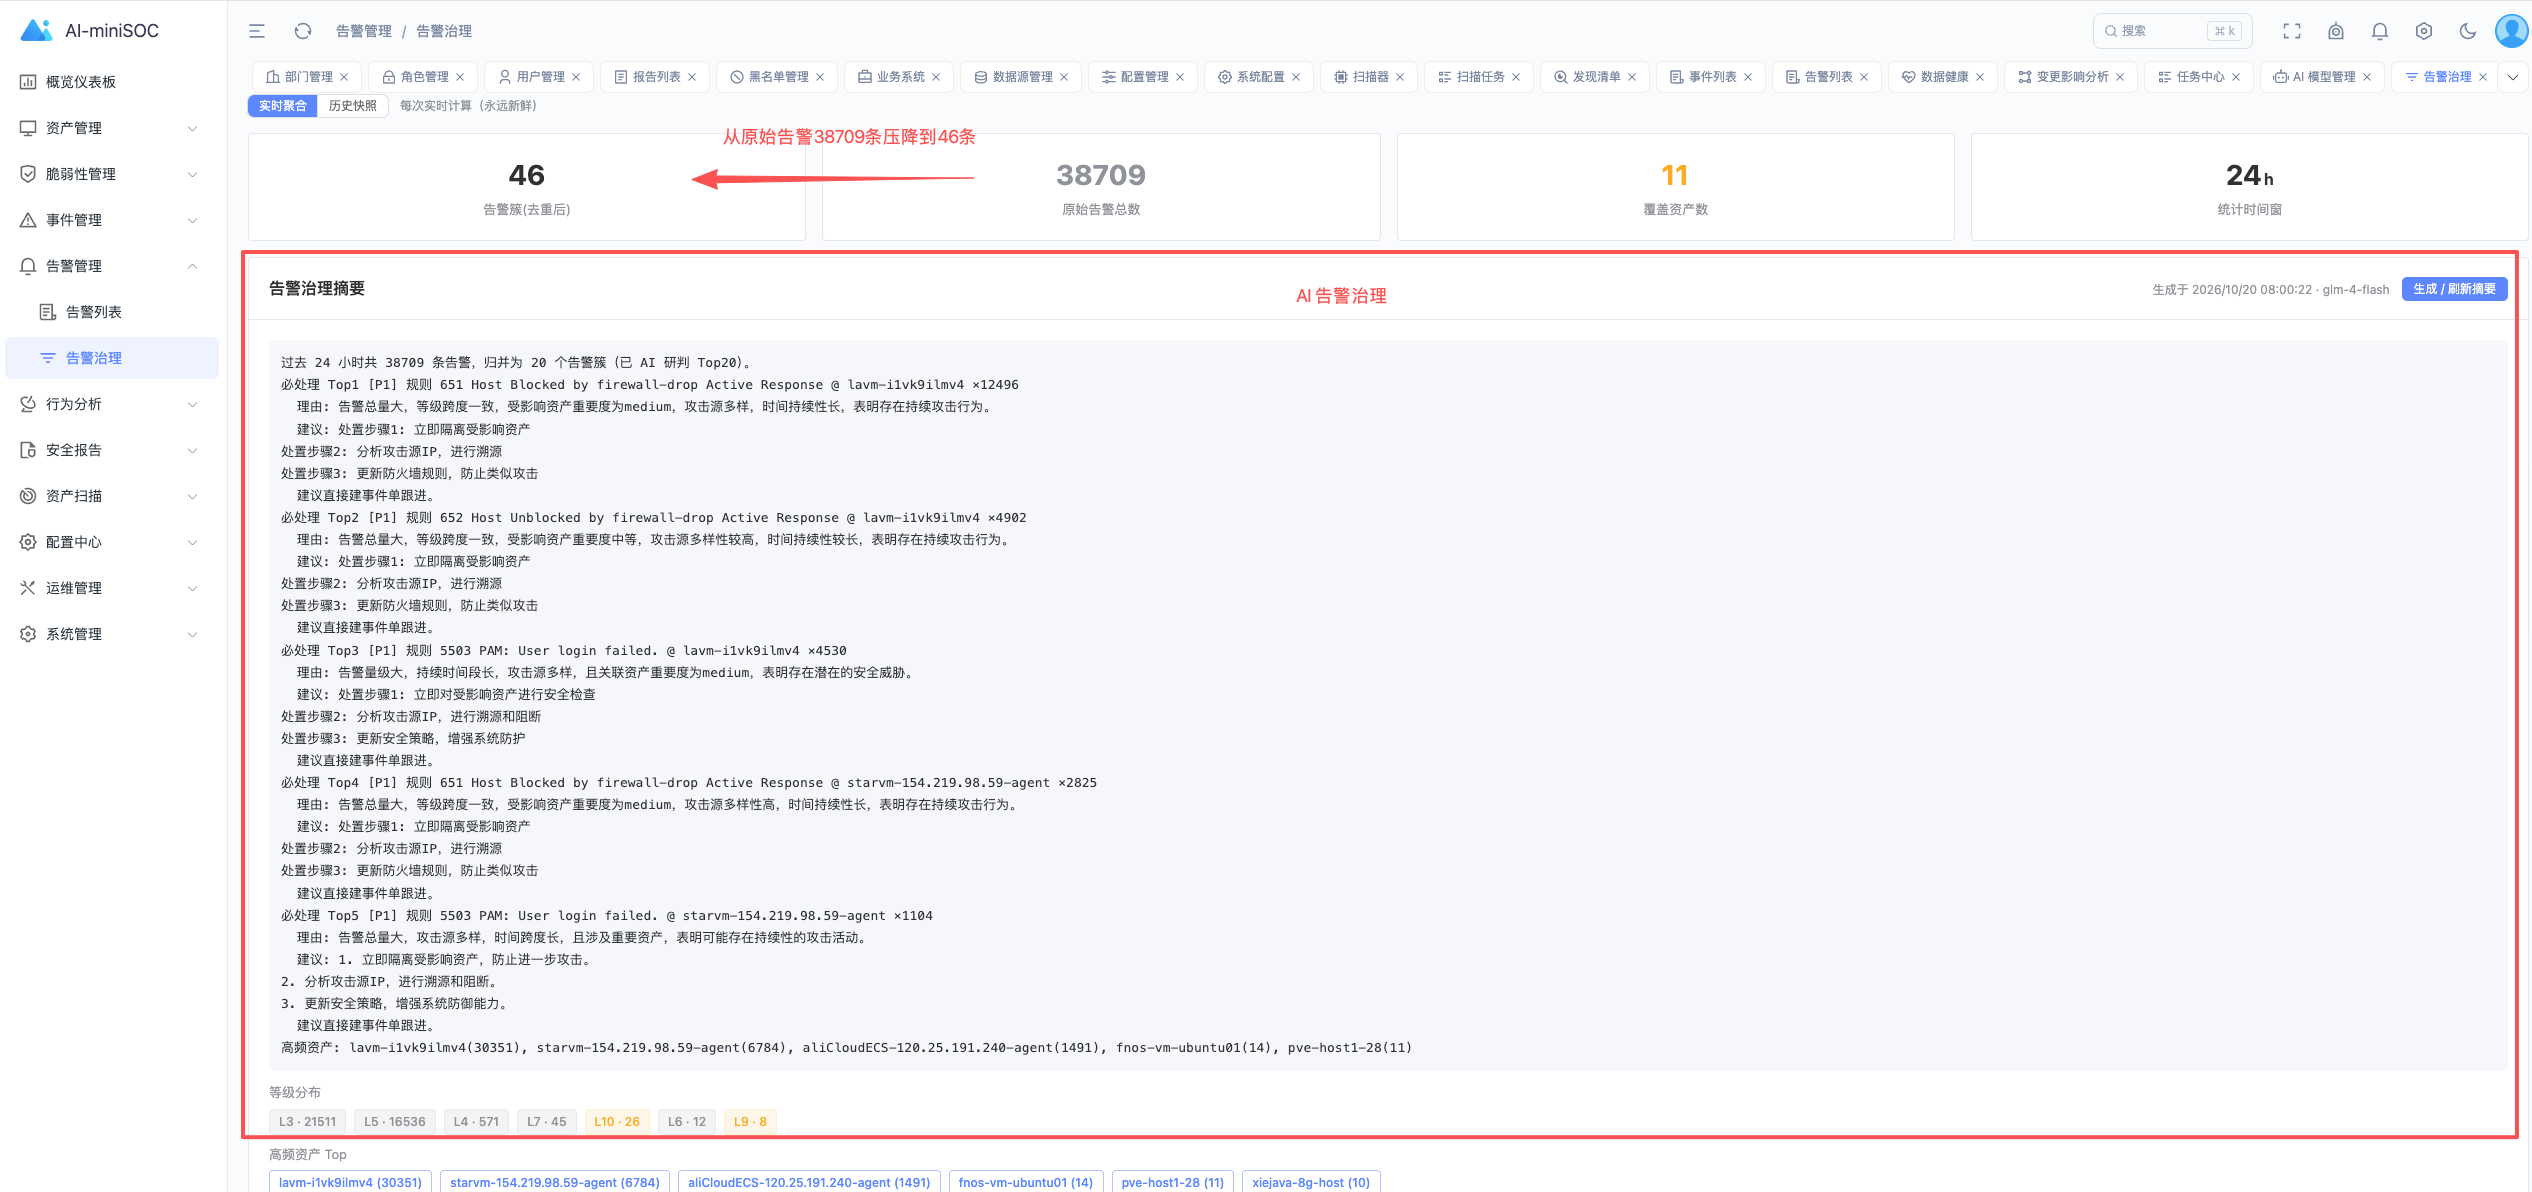
这三个场景是分诊——LLM 读的活,正是 00 篇说的"从几万条告警里挑出真正要管的"。
写:把"周五写周报"变成"一键生成"
| 场景 | 你以前要做的 | 现在你只要 |
|---|---|---|
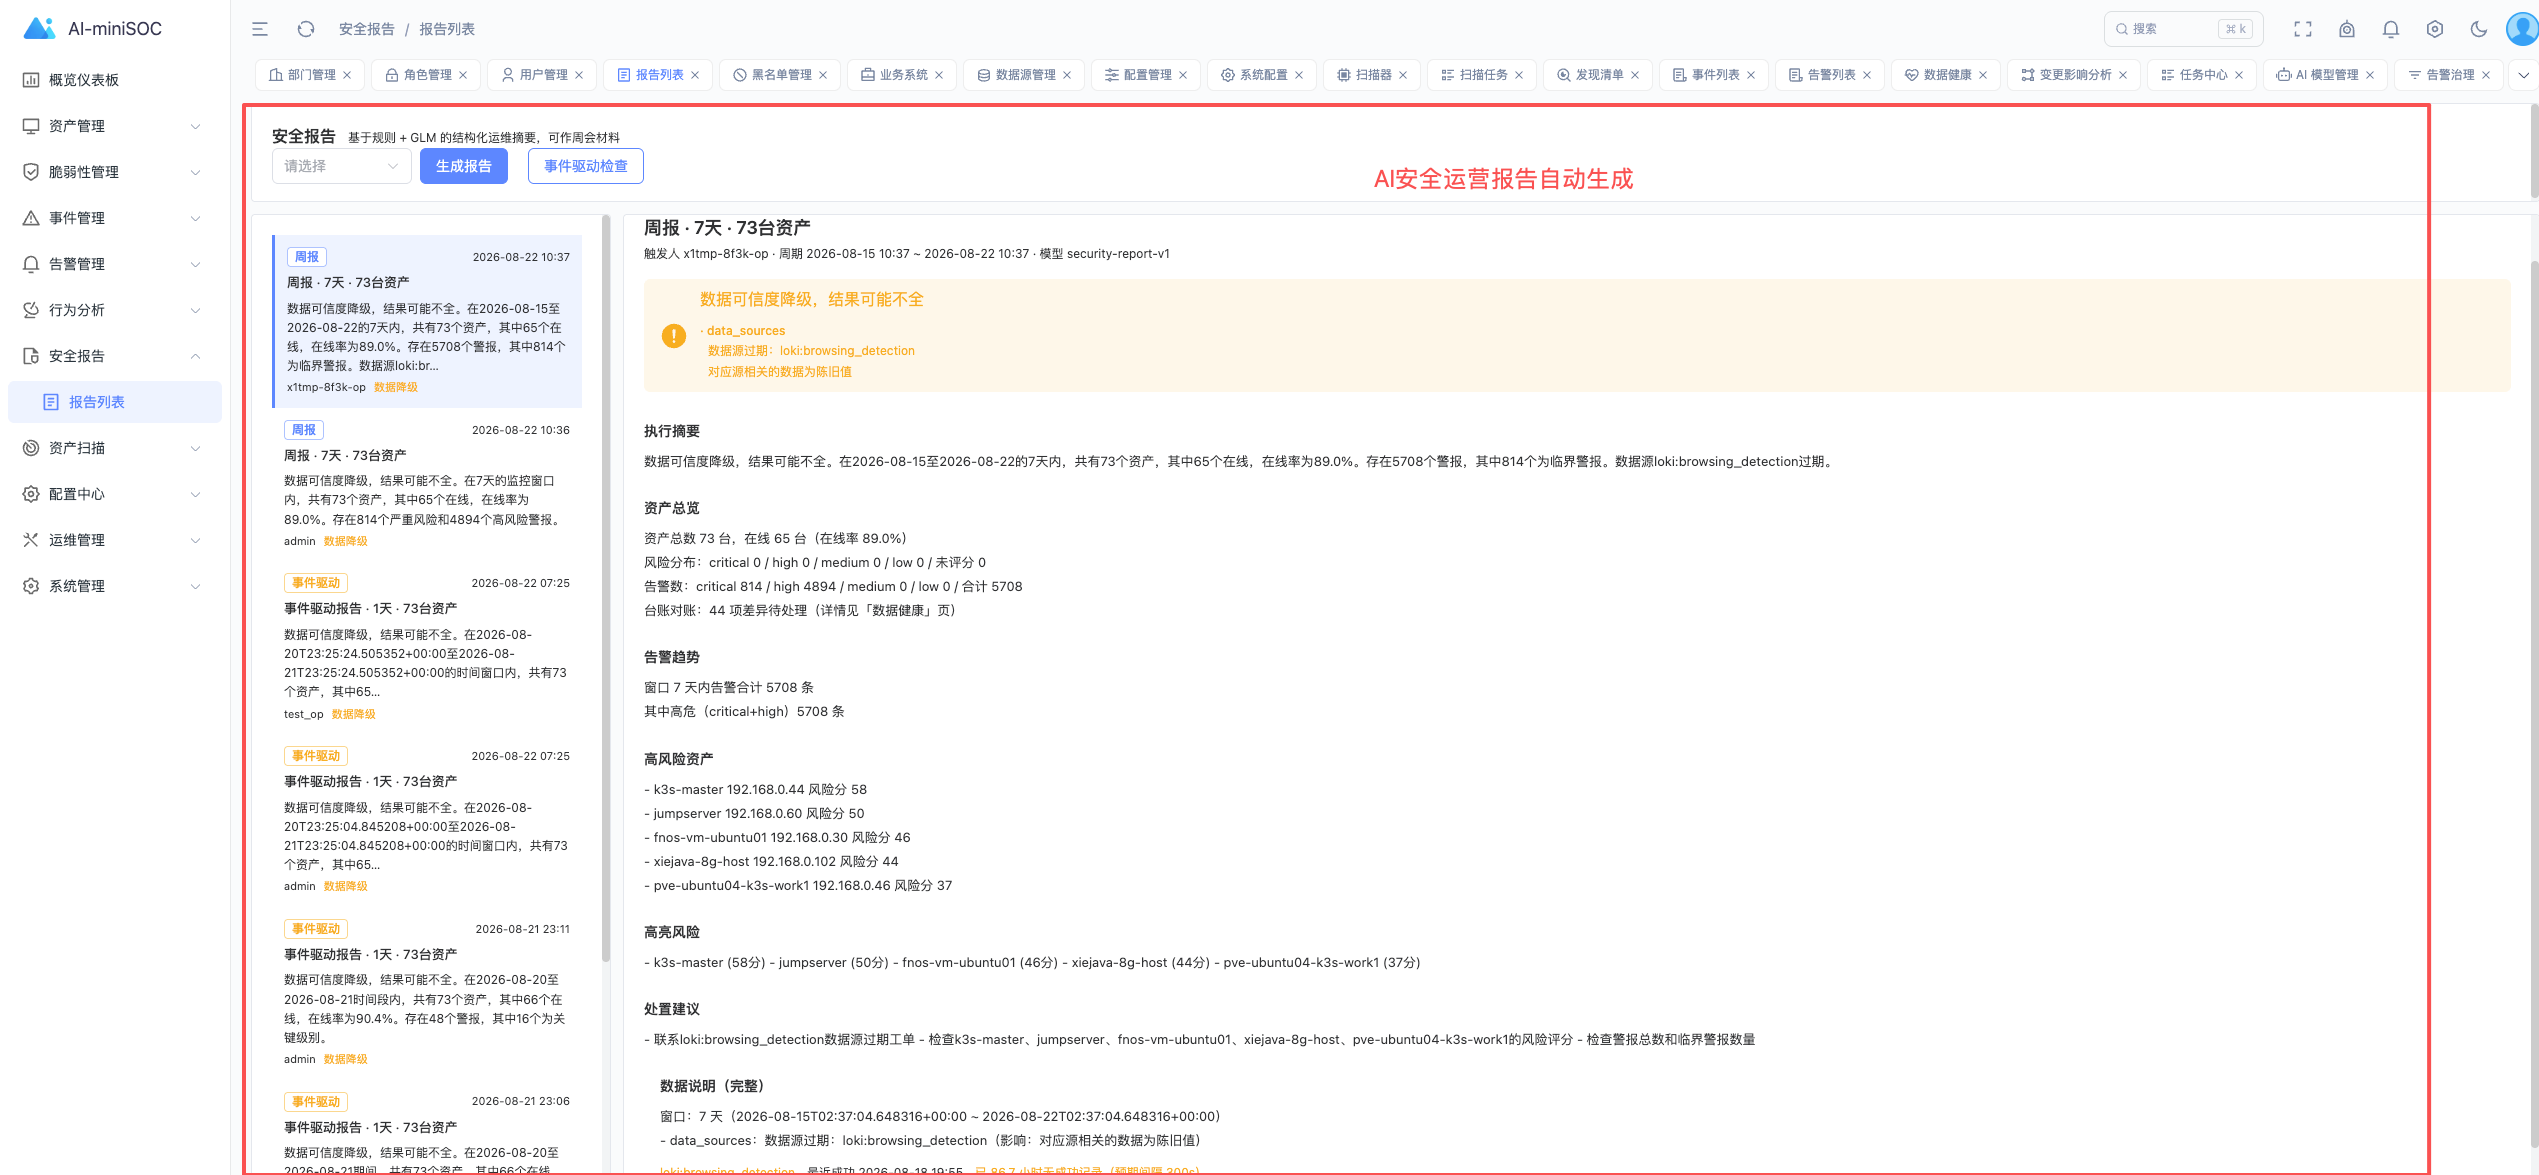
report AI 安全报告 | 周五下午 2 小时攒周报 | 点一下"生成",审一遍发出(长文场景,超时给到 180s) |
impact 变更影响分析 | “要下线这台服务器影响谁"翻台账问同事 | 输入变更描述,AI 关联资产出影响报告 |
report 是给老板看的——00 篇老李"测评来了交白卷"的解药,就在这个场景。
看:把"盯日志"变成"画像呈现”
| 场景 | 你以前要做的 | 现在你只要 |
|---|---|---|
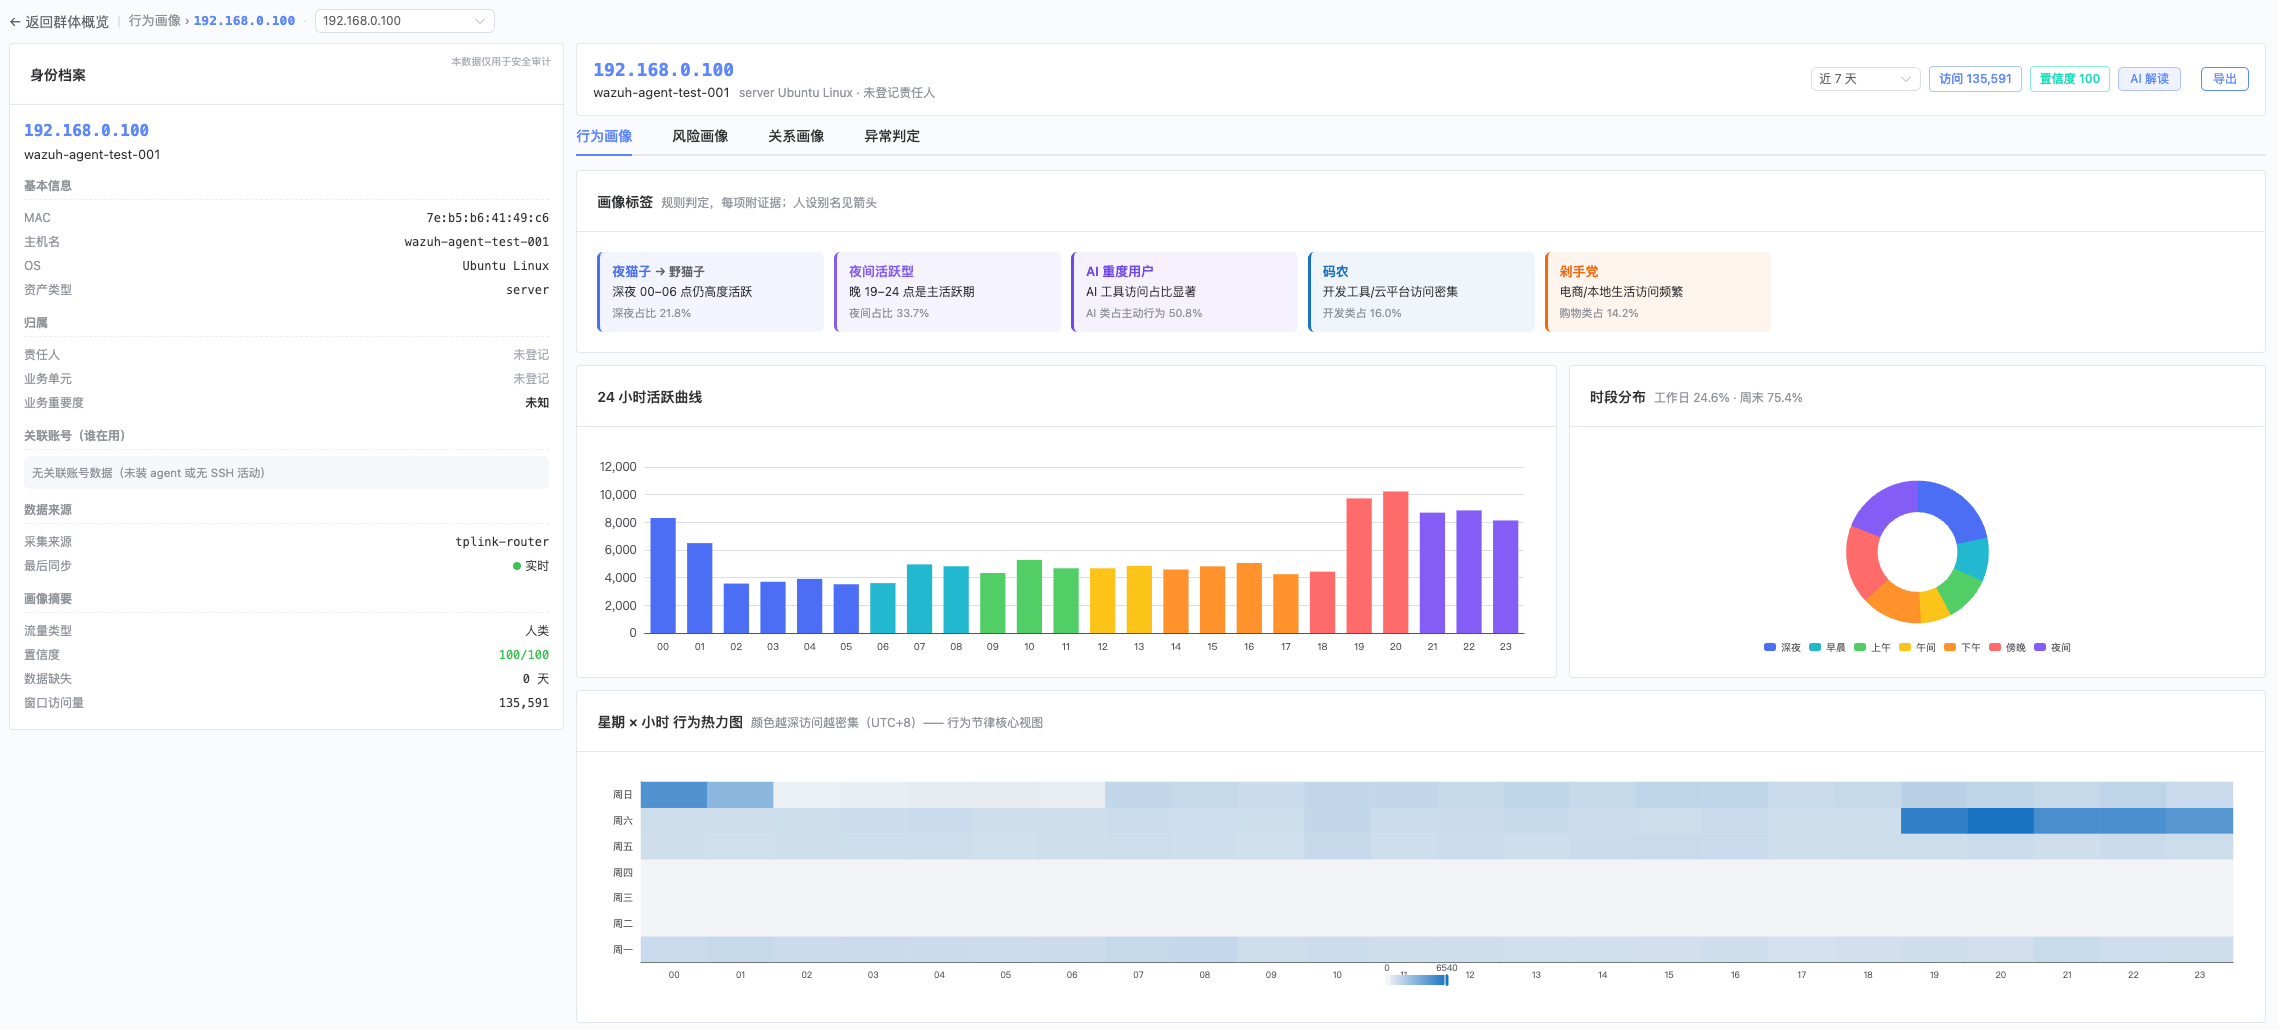
behavior 行为画像 | 想知道"这台设备半夜在干啥"只能翻原始日志 | 打开画像页,时段/域名/习惯一目了然(04 篇讲过) |
ontology_extraction 本体抽取 | 手工整理资产关系表 | AI 从多源数据抽结构化关系 |
兜底:ai_analysis 通用分析
以上场景没覆盖的临时 AI 需求(4 处调用点)走通用分析——副手永远在线。
💡 数一下工时:查资产(每天 N 次)+ 风险摘要(每天 1 次)+ 周报(每周 1 次)+ 对账解读(每周)+ 影响分析(每次变更)——这正是一个初级安全分析师的周工作量。LLM 副手不是替代你,是把这些"读和写"全接走,只剩"拍板"留给你。
副手随便换:模型界面配置,60 秒生效
看到这里你可能有个担心:“这些 AI 场景绑死某家模型吗?模型限流/涨价/想换怎么办?”
这正是统一底座解决的第二件事——副手稳定干活的前提,是"换副手"的成本足够低:
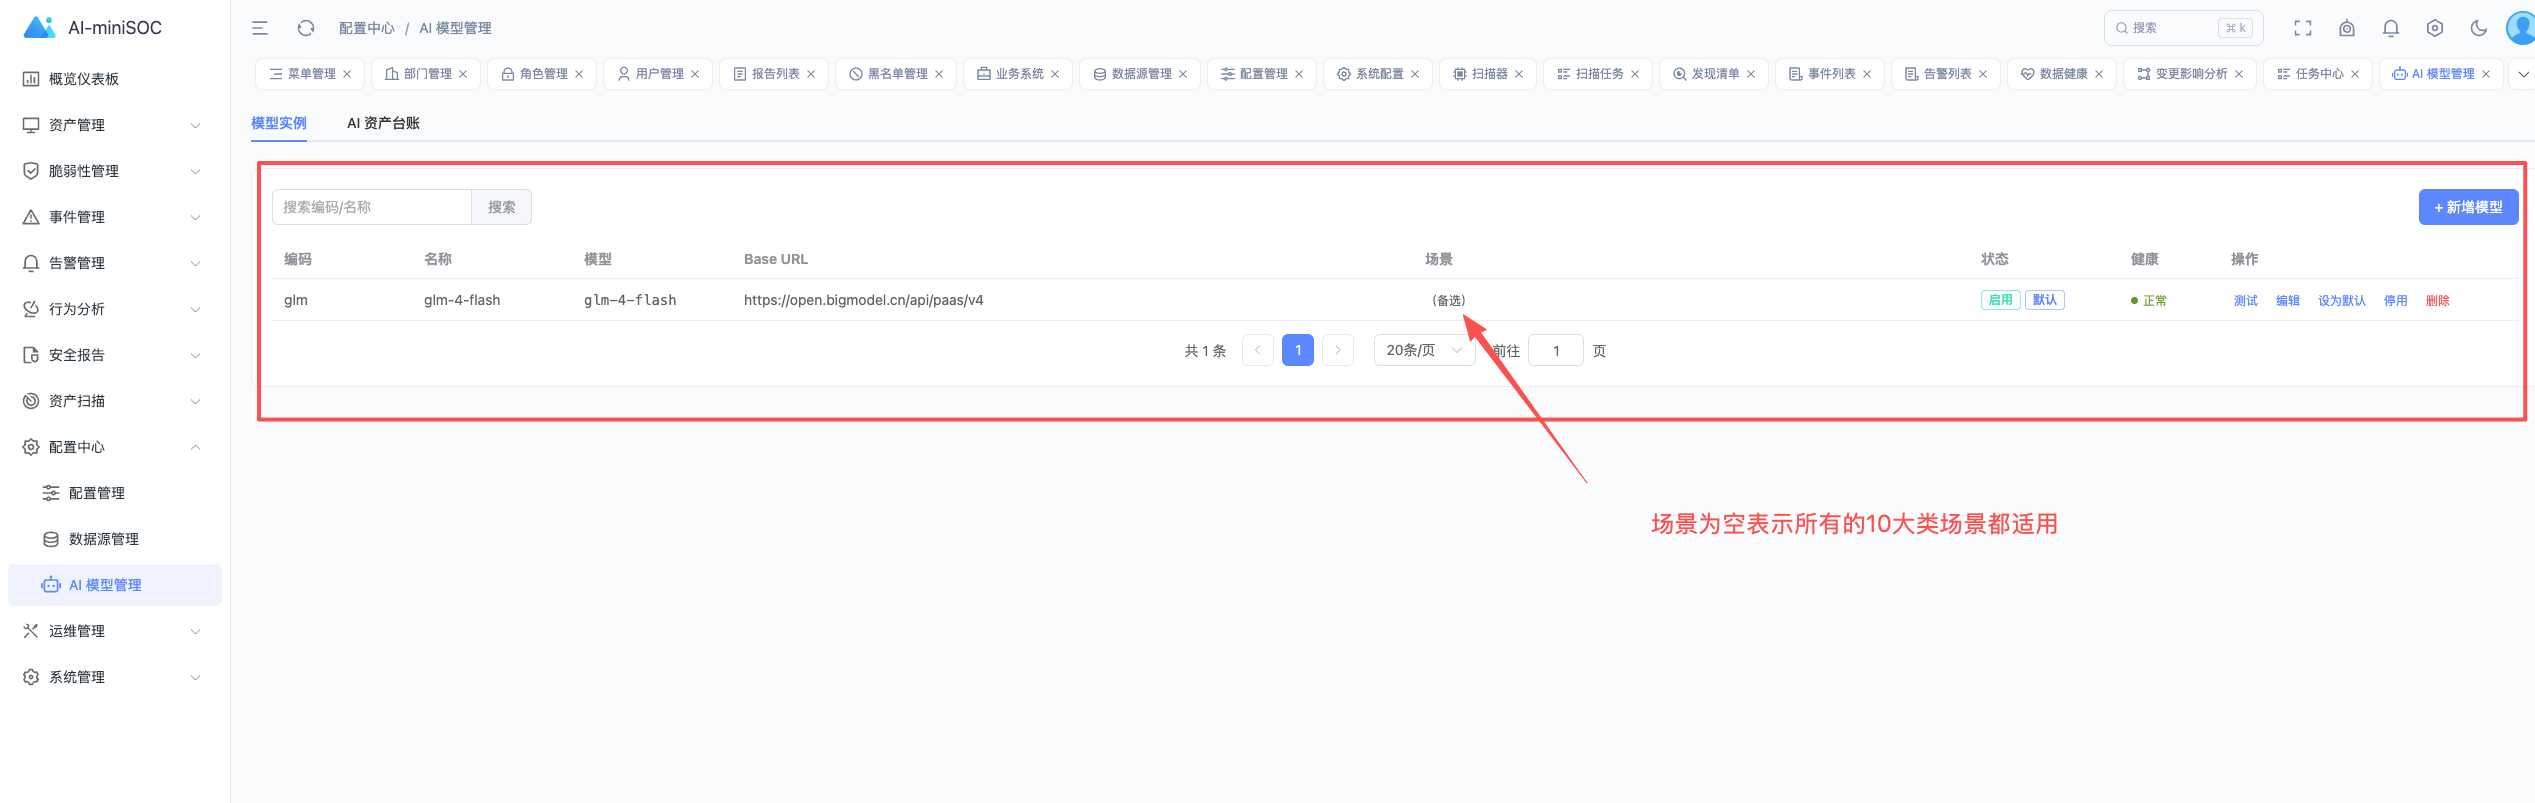
打开「配置中心 → AI 模型管理」界面,新增一个模型实例、填 Base URL 和 API Key、勾上场景——60 秒生效,不用重启,不用改代码。
GLM、DeepSeek、通义千问、Kimi、OpenAI,甚至 Ollama 本地模型——只要是 OpenAI 兼容协议都能配:
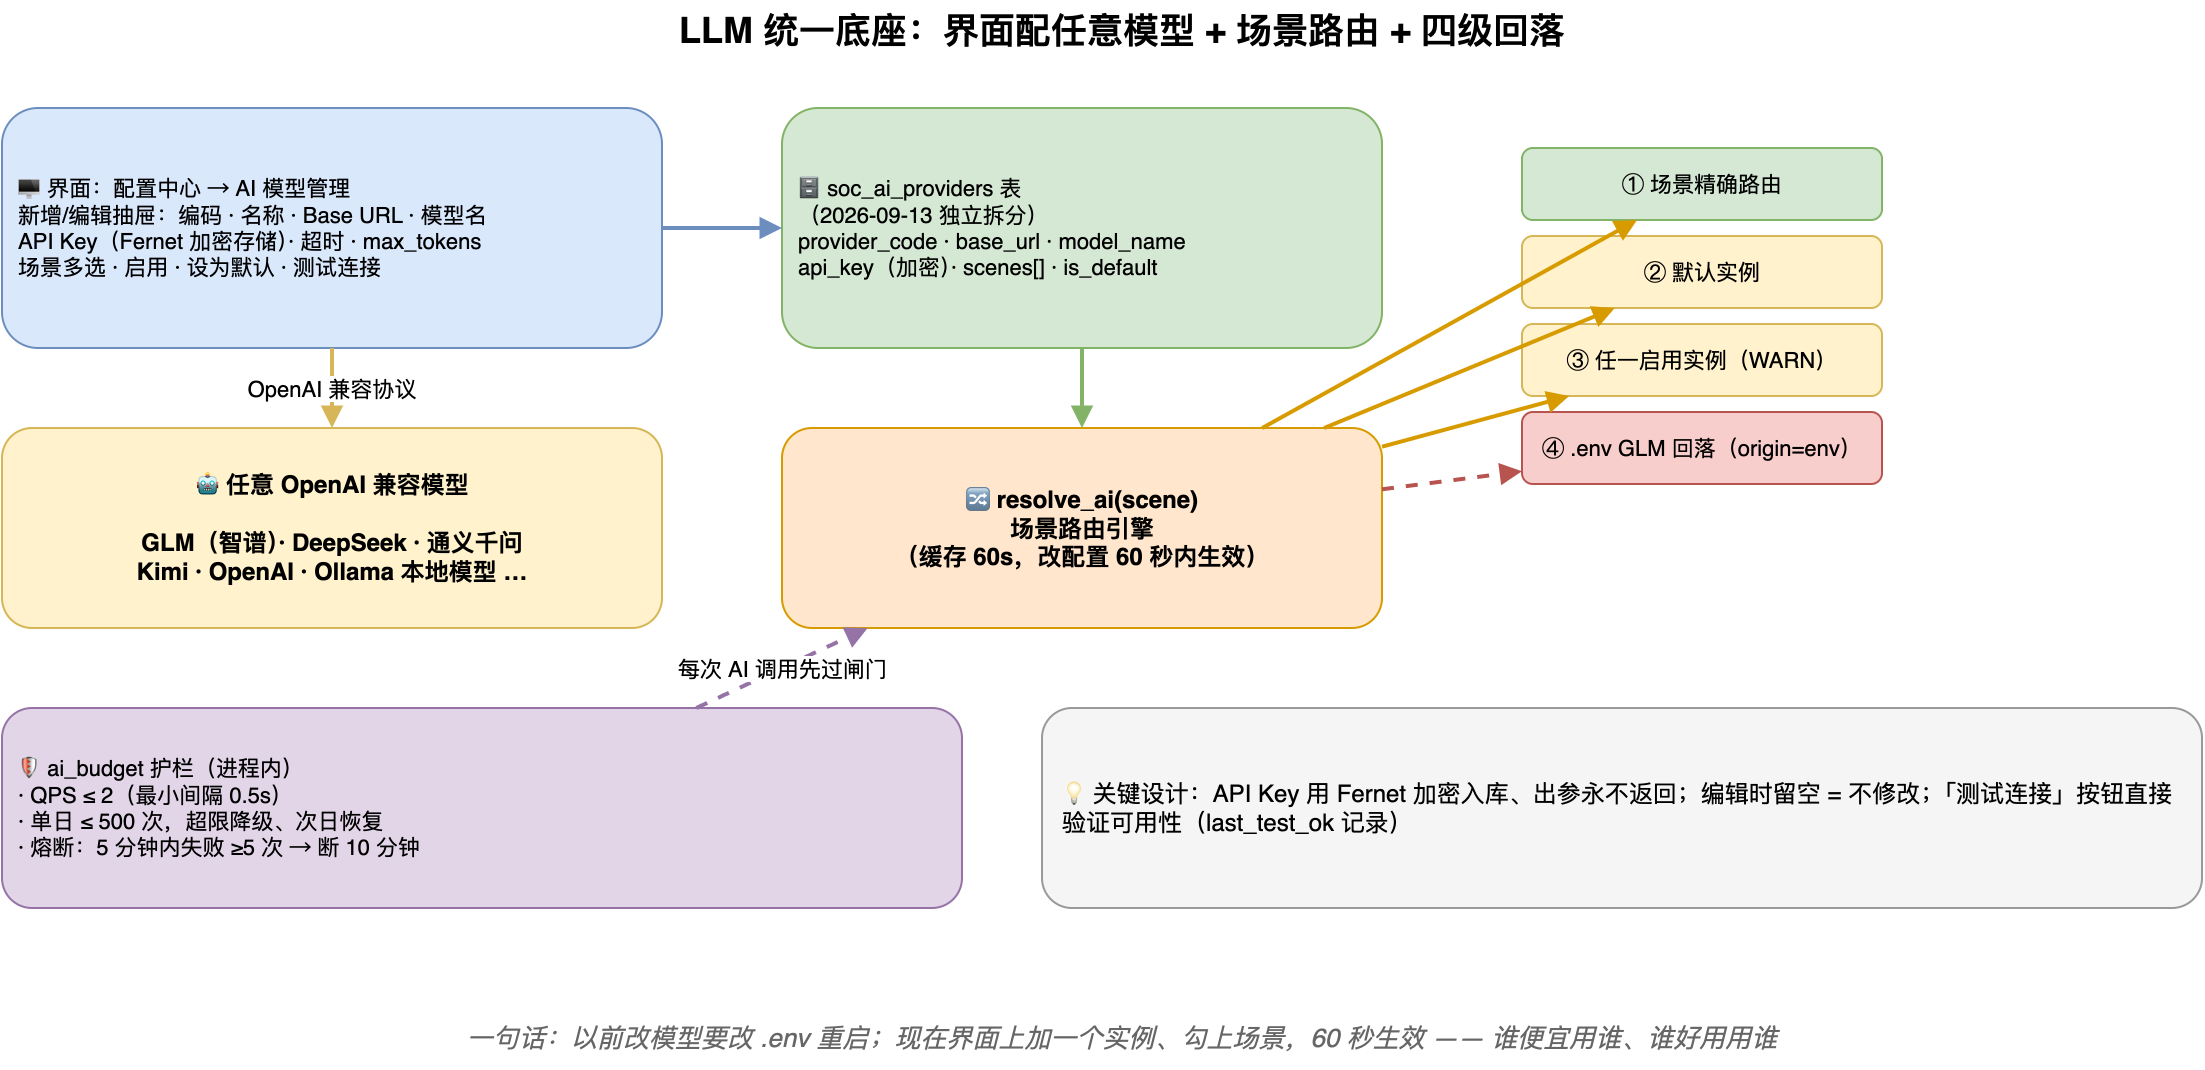
场景路由是核心玩法:每个模型实例勾选它负责的场景——
- 🅰 GLM-4-flash(免费) 设为默认,干高频粗活:查资产、风险摘要、对账解读
- 🅱 DeepSeek(擅长长文) 勾上
report+impact:周报给更强的模型写 - 🅲 Ollama 本地 勾上
behavior:行为画像数据不出网
谁便宜用谁、谁擅长用谁——10 个场景各取所需。
没勾的场景走四级回落保底:场景精确匹配 → 默认实例 → 任一启用 → .env GLM 环境变量(最后一级意味着老用户升级后什么都不用做,行为不变)。
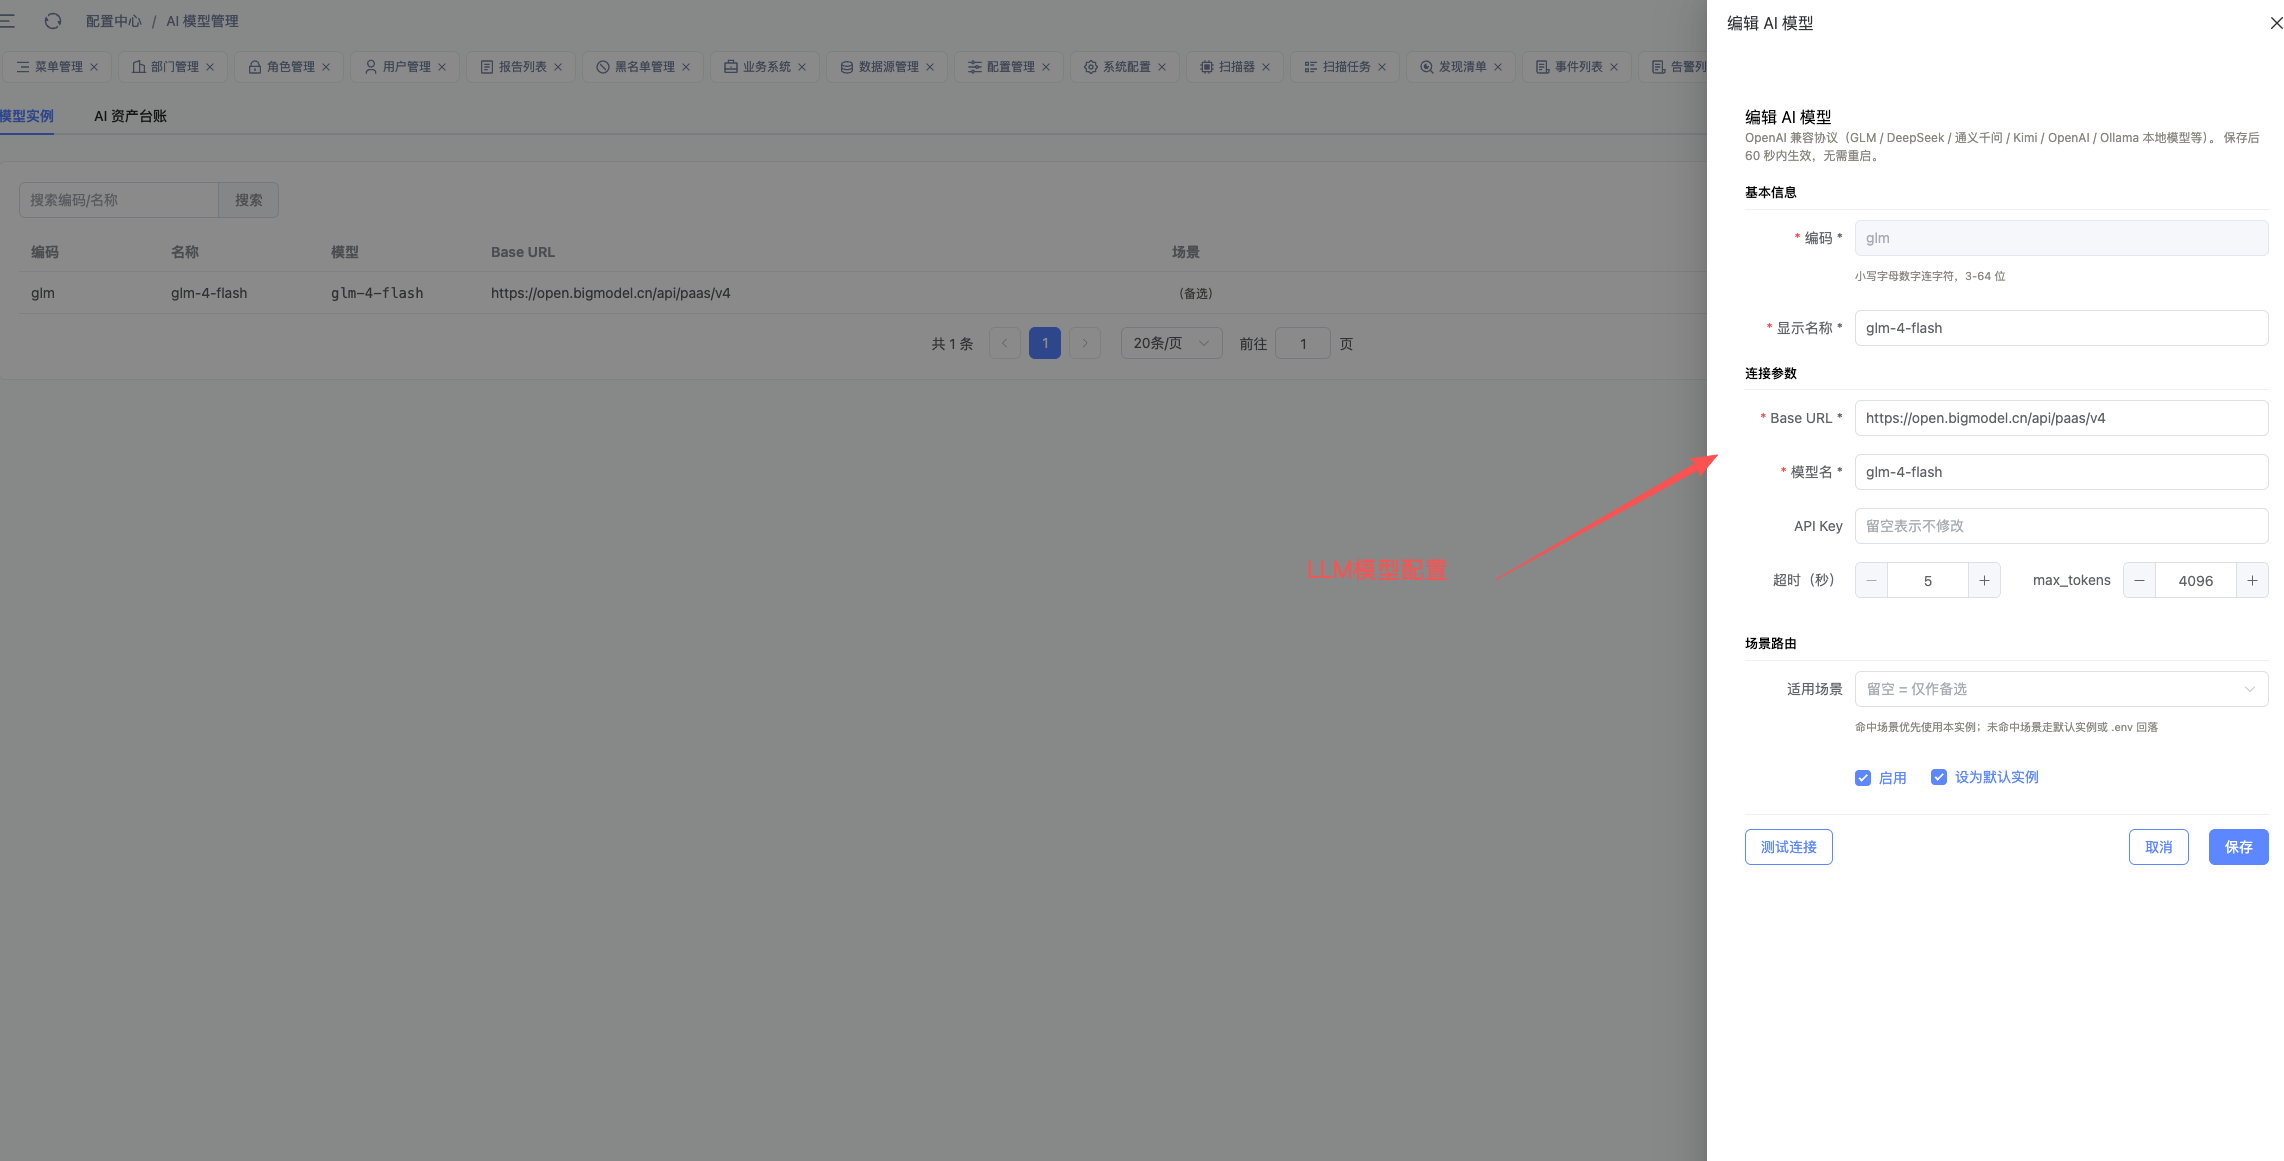
 配置时两个贴心设计:API Key Fernet 加密入库、出参永不返回明文(管理员也看不到完整 Key);保存前**点"测试连接"**真发一次请求验证——别跳过,配错一个字母 AI 会静默走降级,你看到的是"AI 怎么不出结果"而不是报错。
护栏:副手不会把你的预算烧光
“随便用 AI"听起来很爽,直到月底看到账单。底座内置三层护栏:
| 护栏 | 默认值 | 防什么 |
|---|---|---|
| QPS 限流 | ≤ 2 次/秒 | 防死循环脚本烧配额 |
| 单日上限 | 500 次/天,超限走降级、次日恢复 | 预算失控的最坏情况也可算 |
| 熔断器 | 5 分钟内失败 ≥5 次 → 断 10 分钟 | 模型挂了还疯狂重试的重试风暴 |
触发护栏时消费点不崩溃,走降级路径——这是 01 篇"AI 是消费点不是中枢"的兑现,(11) 篇专门展开。
常见问题
Q:起步配几个模型?
A:一个。配你有 Key 的那家(GLM 免费额度适合起步),设为默认,场景全留空。跑两周发现"报告不够好"再配第二个给 report 用。别一上来配五六个——路由关系越多越难排查。
Q:Ollama 本地模型够用吗?
A:按场景分流正是为此设计。小模型(7B 级)写周报与云端大模型有差距,但做 behavior 分类、标签提取够用——隐私数据不出网的价值远大于质量损失。
Q:正在生成的报告,换模型会中断吗?
A:不会。路由在每次调用时解析——跑着的任务用老配置跑完,下一个任务才用新路由。
Q:LLM 会不会幻觉,把错误的研判给我?
A:会,所以架构上防着它——这正是底座设计的出发点:主干业务(台账、对账、评分)全部规则计算不经过 LLM(06-08 篇讲的都是确定性逻辑);LLM 只做"读和写”,且每个场景都有降级路径。怎么降级是 (11) 篇的主题,那里有对抗样本 5/5 全拒的实测。
收尾:09 在系列中的位置
| 层 | 能力 | 篇目 |
|---|---|---|
| 资产地基 | 看得见 / 看得真 / 不被骗 / 信得对 | 03-08 |
| AI 副手底座 | 10 个场景替你干活 · 模型界面配置 · 场景路由 | 09(本篇) |
| AI 消费点深潜 | 自然语言查询 / 诚实降级 / AI 报告 / Agent | 10-13 |
后面四篇全部建立在今天这套底座上:(10) 最常用的 asset_query 怎么做到 98% 准确率;(11) 模型不可靠时每个场景怎么兜底(系列灵魂);(12) AI 报告与推送闭环;(13) AI Agent 与 MCP。
老李上周五 16:58 收到老板微信:“下周一早会上看安全月报。” 以前的老李会在公司熬到 20 点攒 PPT。 现在的他点了下"生成月报",AI 底层用 DeepSeek 写完初稿(他给
report场景勾的),他改了 3 处措辞,17:20 发出。 顺带一提:那个月的 AI 账单是 0 元——高频场景全在免费的 GLM 上,DeepSeek 只在写报告时用几次。
一个人的 SOC,副手已经就位。你的呢?
【系列导航】《一个人的SOC》总目录(持续更新)
【上一篇】(08) 身份可信度评分——多源数据不一致时信哪个
【系列开篇】(00) 中小企业为什么需要自己的安全运营中心
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐ 【Gitee 镜像】 https://gitee.com/xiejava/AI-miniSOC
【交流】 配了多家模型但路由不生效?把 AI 模型管理页的截图(Key 打码)发 Issue,我帮你看勾选关系。
下一篇(预告):(10) 自然语言查资产——L1/L2 双层设计与 98% 准确率是怎么来的(连载中,敬请关注)
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!