上一篇我们把架构和取舍讲透了:分级存储、拉模型采集、AI 消费点。老李也把那台 2019 年的旧服务器从库房搬了出来,装上了 Linux。
那么这一篇回答动手的人最关心的问题:
从一台裸机到登录进自己的 SOC 控制台,到底要几步、会卡在哪?
先交代一件事:这篇文章是写给"使用者"的——你的目标是用上它,不是给它提交代码。所以全文只有一条主线:“把它跑起来、用起来”。至于开发者才需要的东西(跑测试、本地开发环境),文末有个"进阶彩蛋"指个路,平时你完全不需要碰。
结论先行:核心链路 5 步、顺利的话 45 分钟。但"顺利"是有条件的——这篇文章除了正常步骤,还会把我部署时踩过的每一个坑原样交给你,因为坑才是部署教程真正值钱的部分,官方文档从来不会写"你会在这里卡 20 分钟"。
老规矩,先看全景再动手:
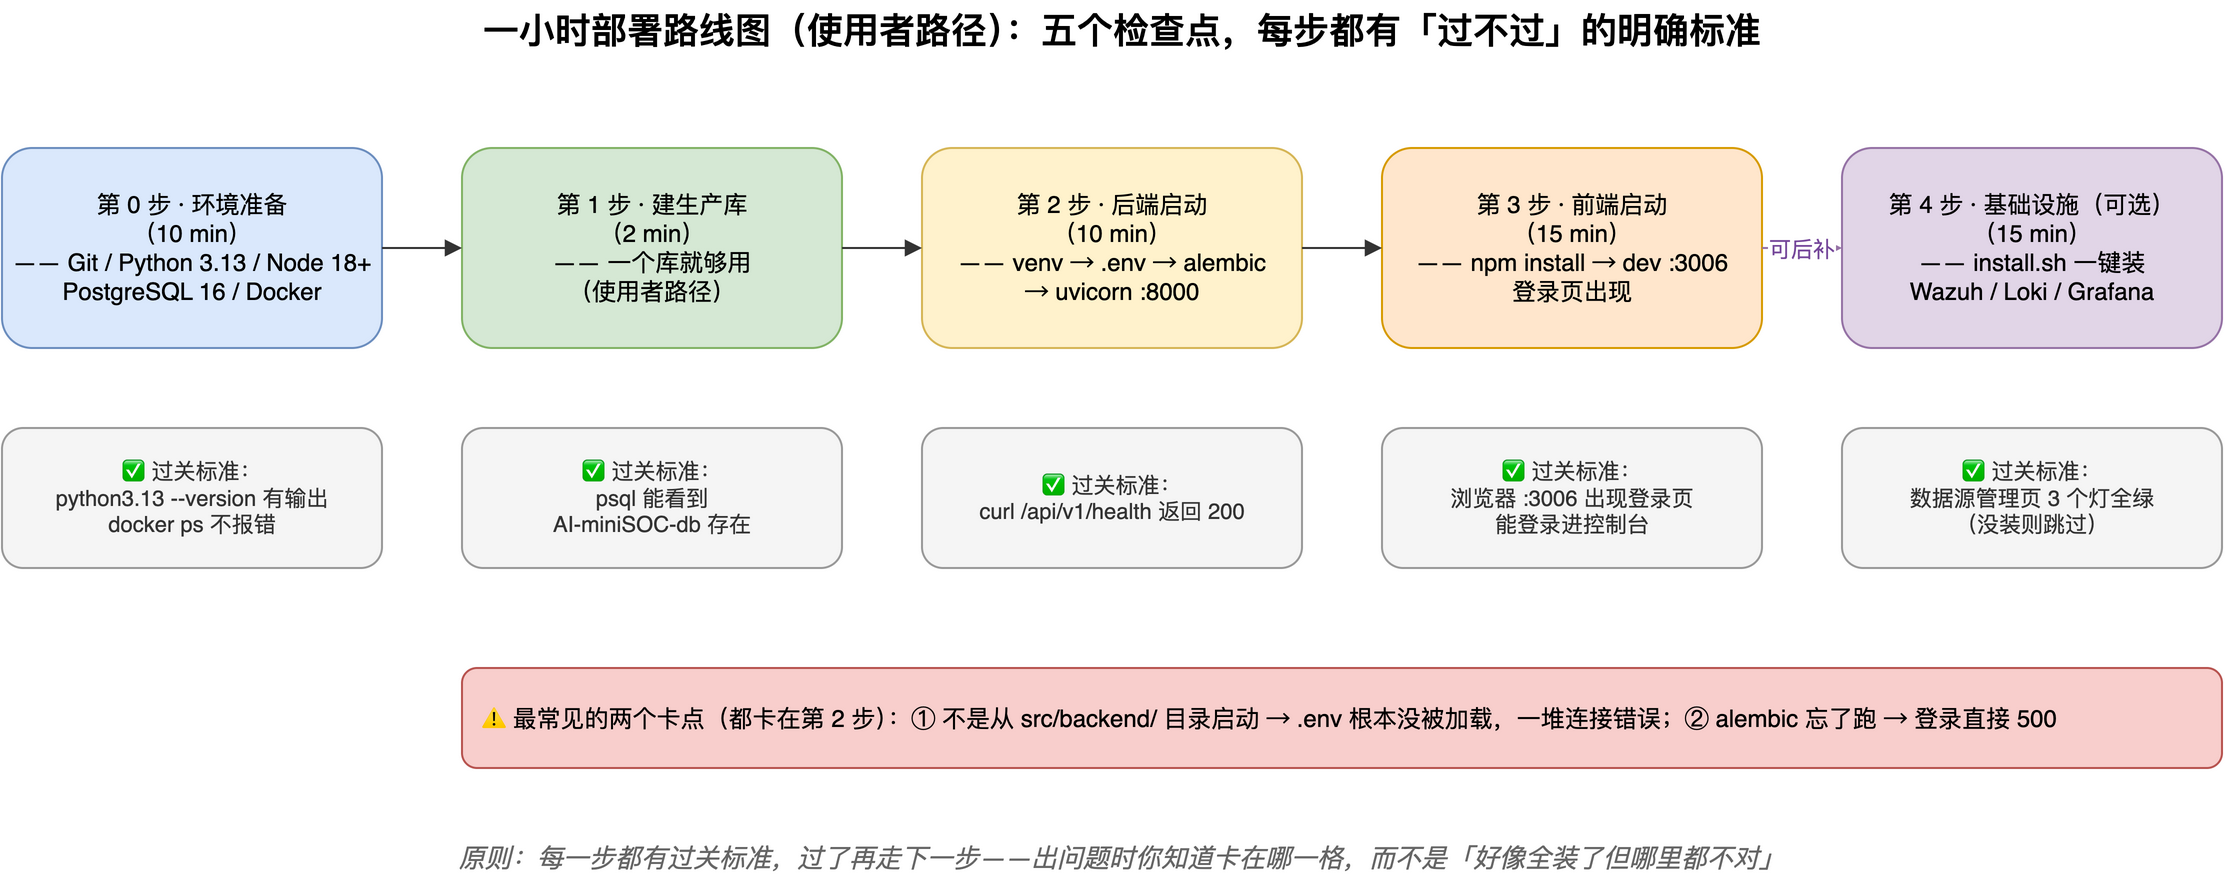
一个重要原则:每一步都有明确的"过关标准",过了再走下一步。这样新手最大的敌人——“好像都装了但不知道哪里不对”——就无处藏身:出问题时你永远知道卡在哪一格。
第 0 步:环境准备(10 分钟)
老李的旧服务器装的是 Ubuntu 22.04(Debian 12 也行),先确认这五样东西:
| |
过关标准:五条命令都有正常输出,没有 command not found。
Ubuntu 22.04 默认源里的 Python 是 3.10,装 3.13 要用 deadsnakes PPA。这是第 0 步最常见的坑,但网上教程很多,不展开。
然后克隆代码:
| |
第 1 步:建一个生产库(2 分钟)
使用者只需要一个数据库:
| |
过关标准:sudo -u postgres psql -c '\l' 能在列表里看到 AI-miniSOC-db。
就这么简单。README 里"一次建三个库"的写法是给项目贡献者准备的(本地开发库、pytest 测试库都是改代码的人才用得上)——你现在不需要,一个库就是全部。这也是使用者的天然优势:只有一个库,就不存在"测试数据误删生产表"这种事故,配置永远不会指错地方。
第 2 步:后端启动(10 分钟)——坑最密集的一步
2.1 虚拟环境与依赖
| |
2.2 配置 .env
| |
.env 长什么样、哪些必填哪些可空?先看配置地图:
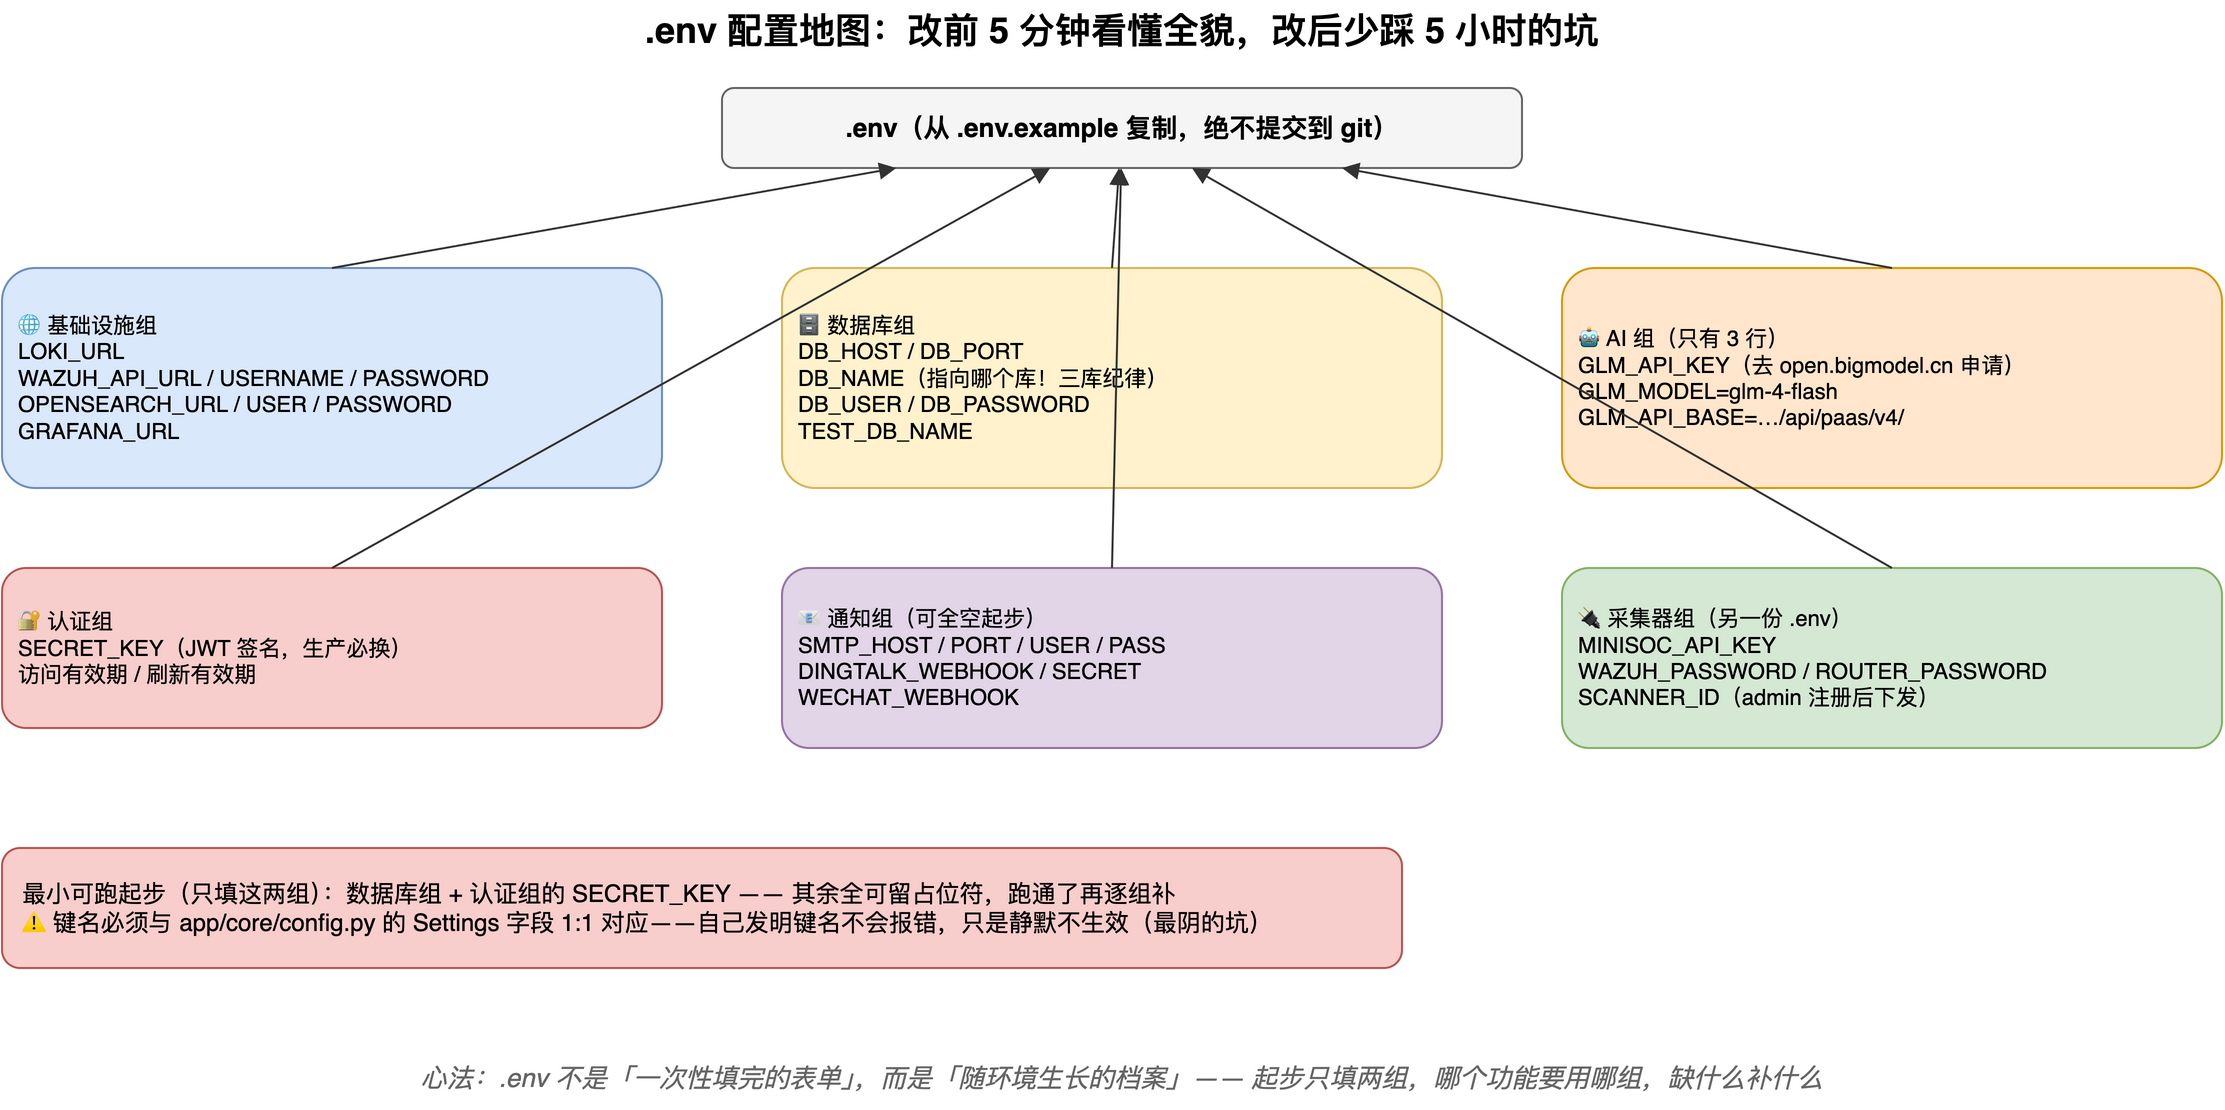
起步只需填两组(其余全部保留占位符,跑通再补):
| |
⚠️ .env 的键名必须与 app/core/config.py 里 Settings 类的字段 1:1 对应。自己发明键名不会报错——它只是静默不生效,然后你在"为什么连不上数据库"上浪费一小时。这是 .env 最阴的坑。
2.3 初始化数据库表(alembic)——新手必卡点 #1
| |
这条命令会把 52 张 soc_ 前缀的表建到 DB_NAME 指向的库里。跳过这步的后果:后端能启动,但登录直接 500,因为没有用户表。
2.4 启动后端
| |
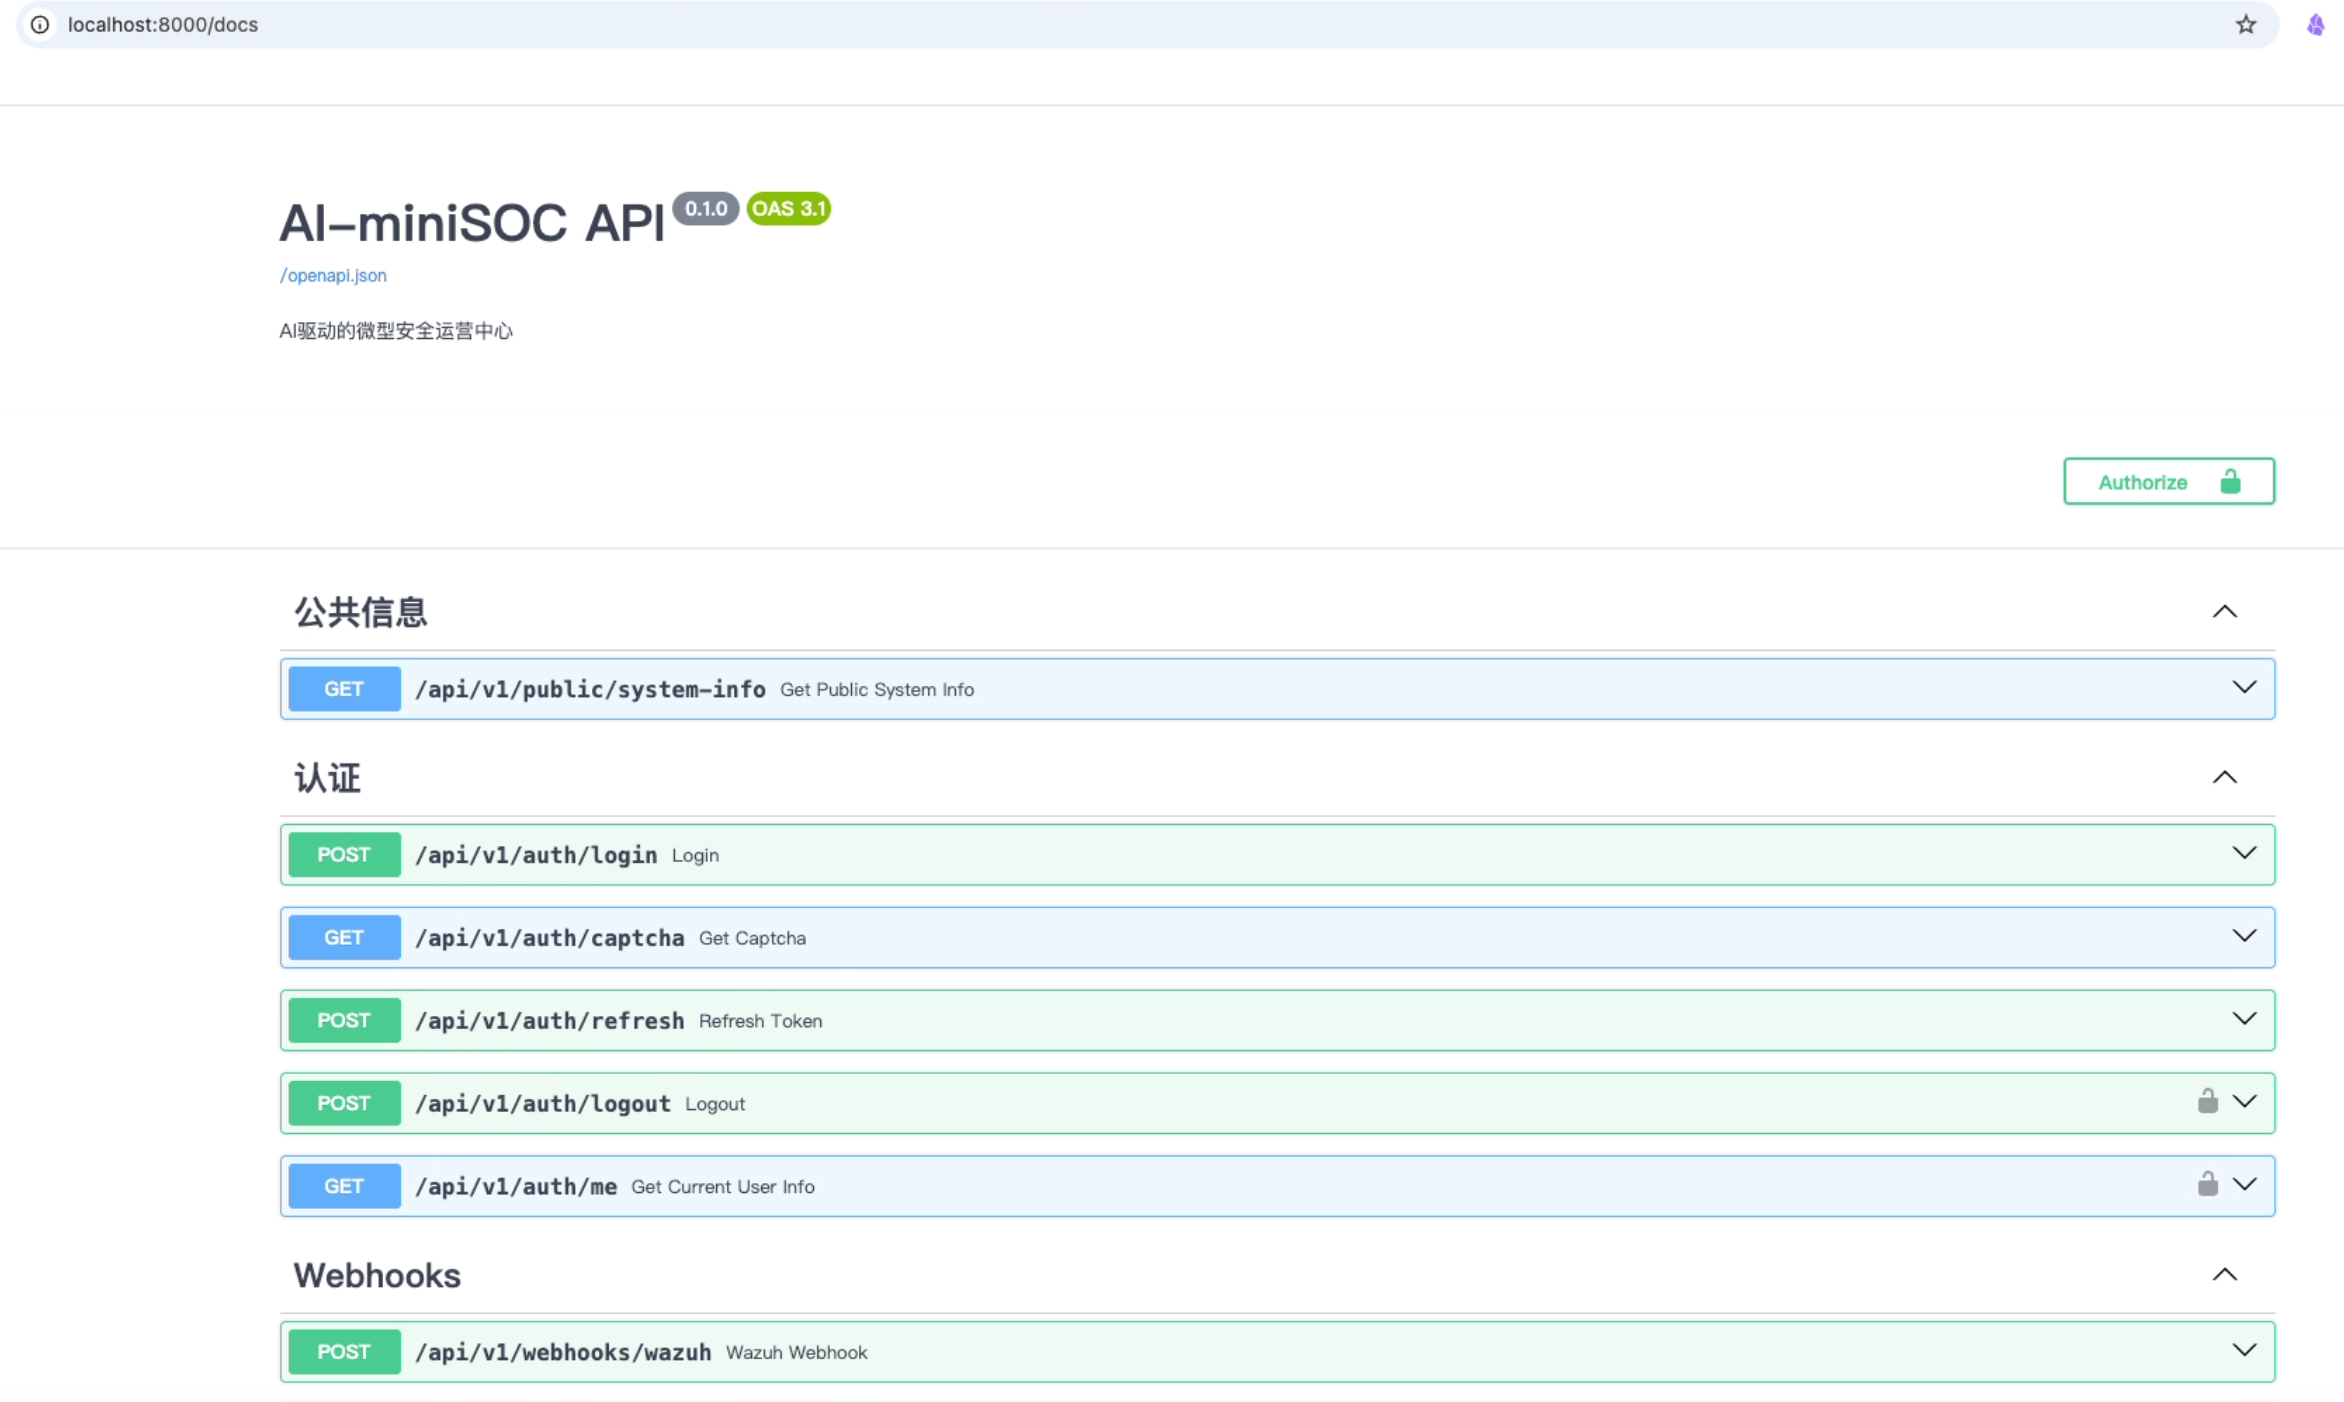
过关标准:health 接口返回正常;浏览器打开 http://localhost:8000/docs 能看到 Swagger 接口文档(43 个路由模块的分组列表)。
curl http://localhost:8000/health 健康检查结果——返回 JSON 就是活的:

浏览器打开 http://localhost:8000/docs,Swagger 接口文档长这样(左侧分组可以逐个展开):
🕳️ 新手必卡点 #2(本篇最大的坑):如果你不是从
src/backend/目录启动——比如图省事在仓库根目录跑uvicorn src.backend.main:app——程序照样能启动,但.env根本没被加载。症状是一堆数据库/Redis 连接错误,报错信息完全指向错误的方向。记住口诀:进到 src/backend 里面再启动。
第 3 步:前端启动(15 分钟)
| |
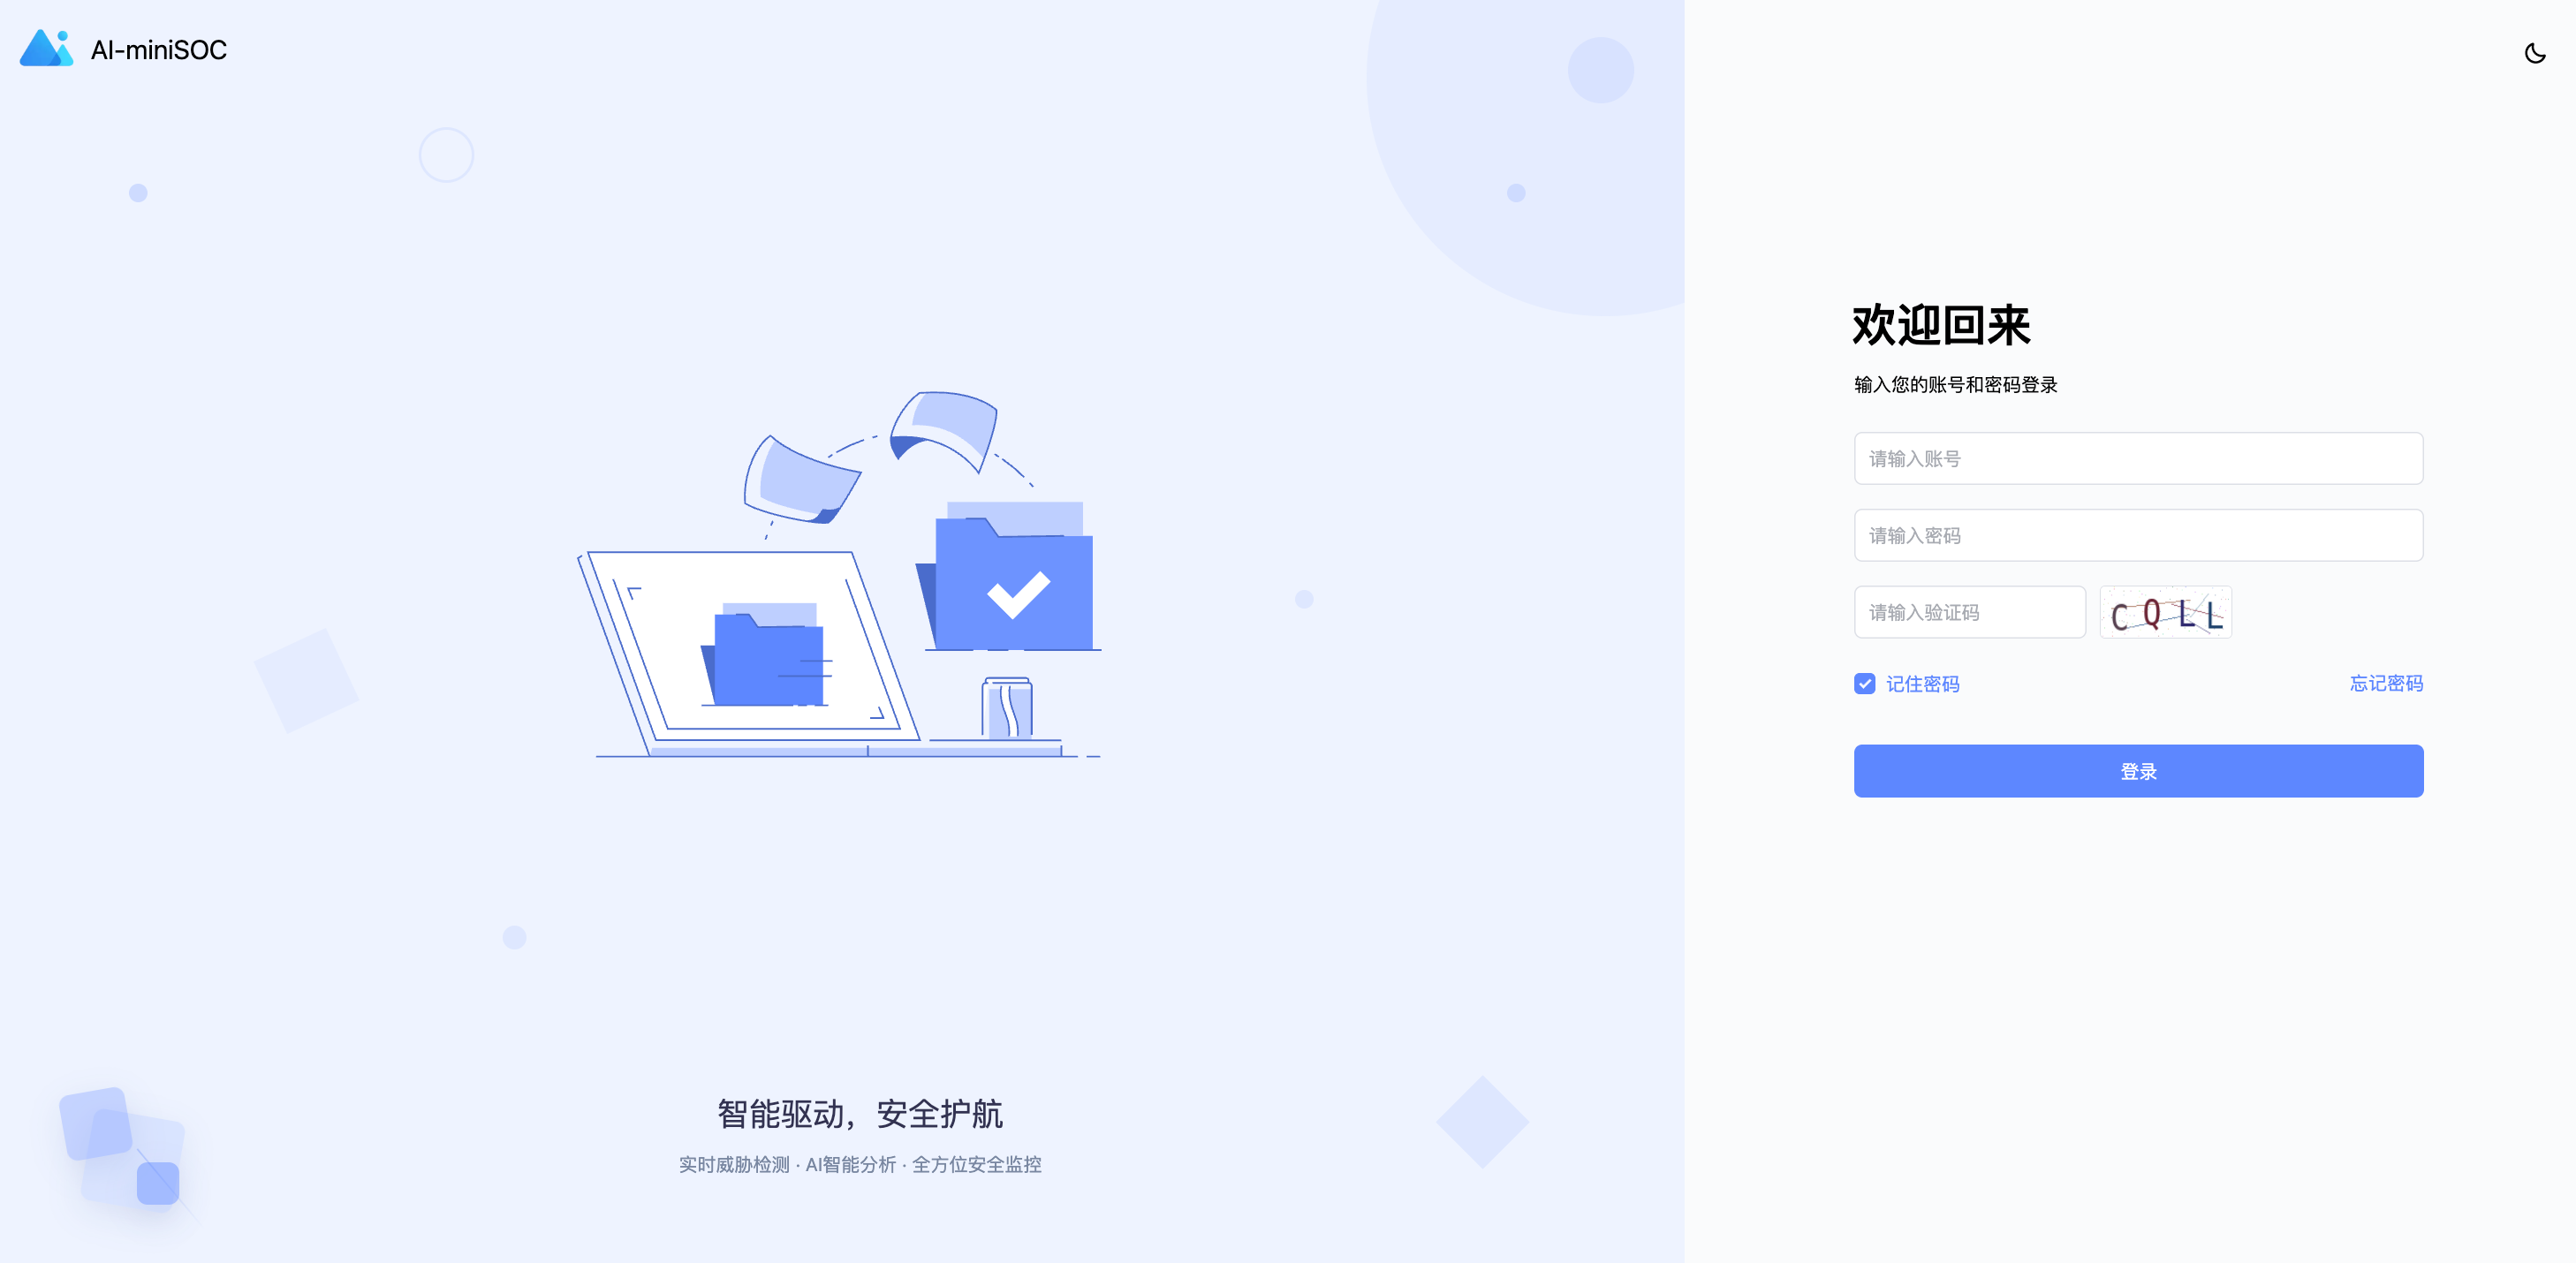
过关标准:http://localhost:3006 出现登录页,且能登录进控制台,看到左侧 11 个菜单。
登录页(注意有验证码——这是后端登录硬化的一部分):
登录成功后默认进入概览仪表盘——这就是"部署完成"的标志性瞬间,从裸机到这里,45 分钟:
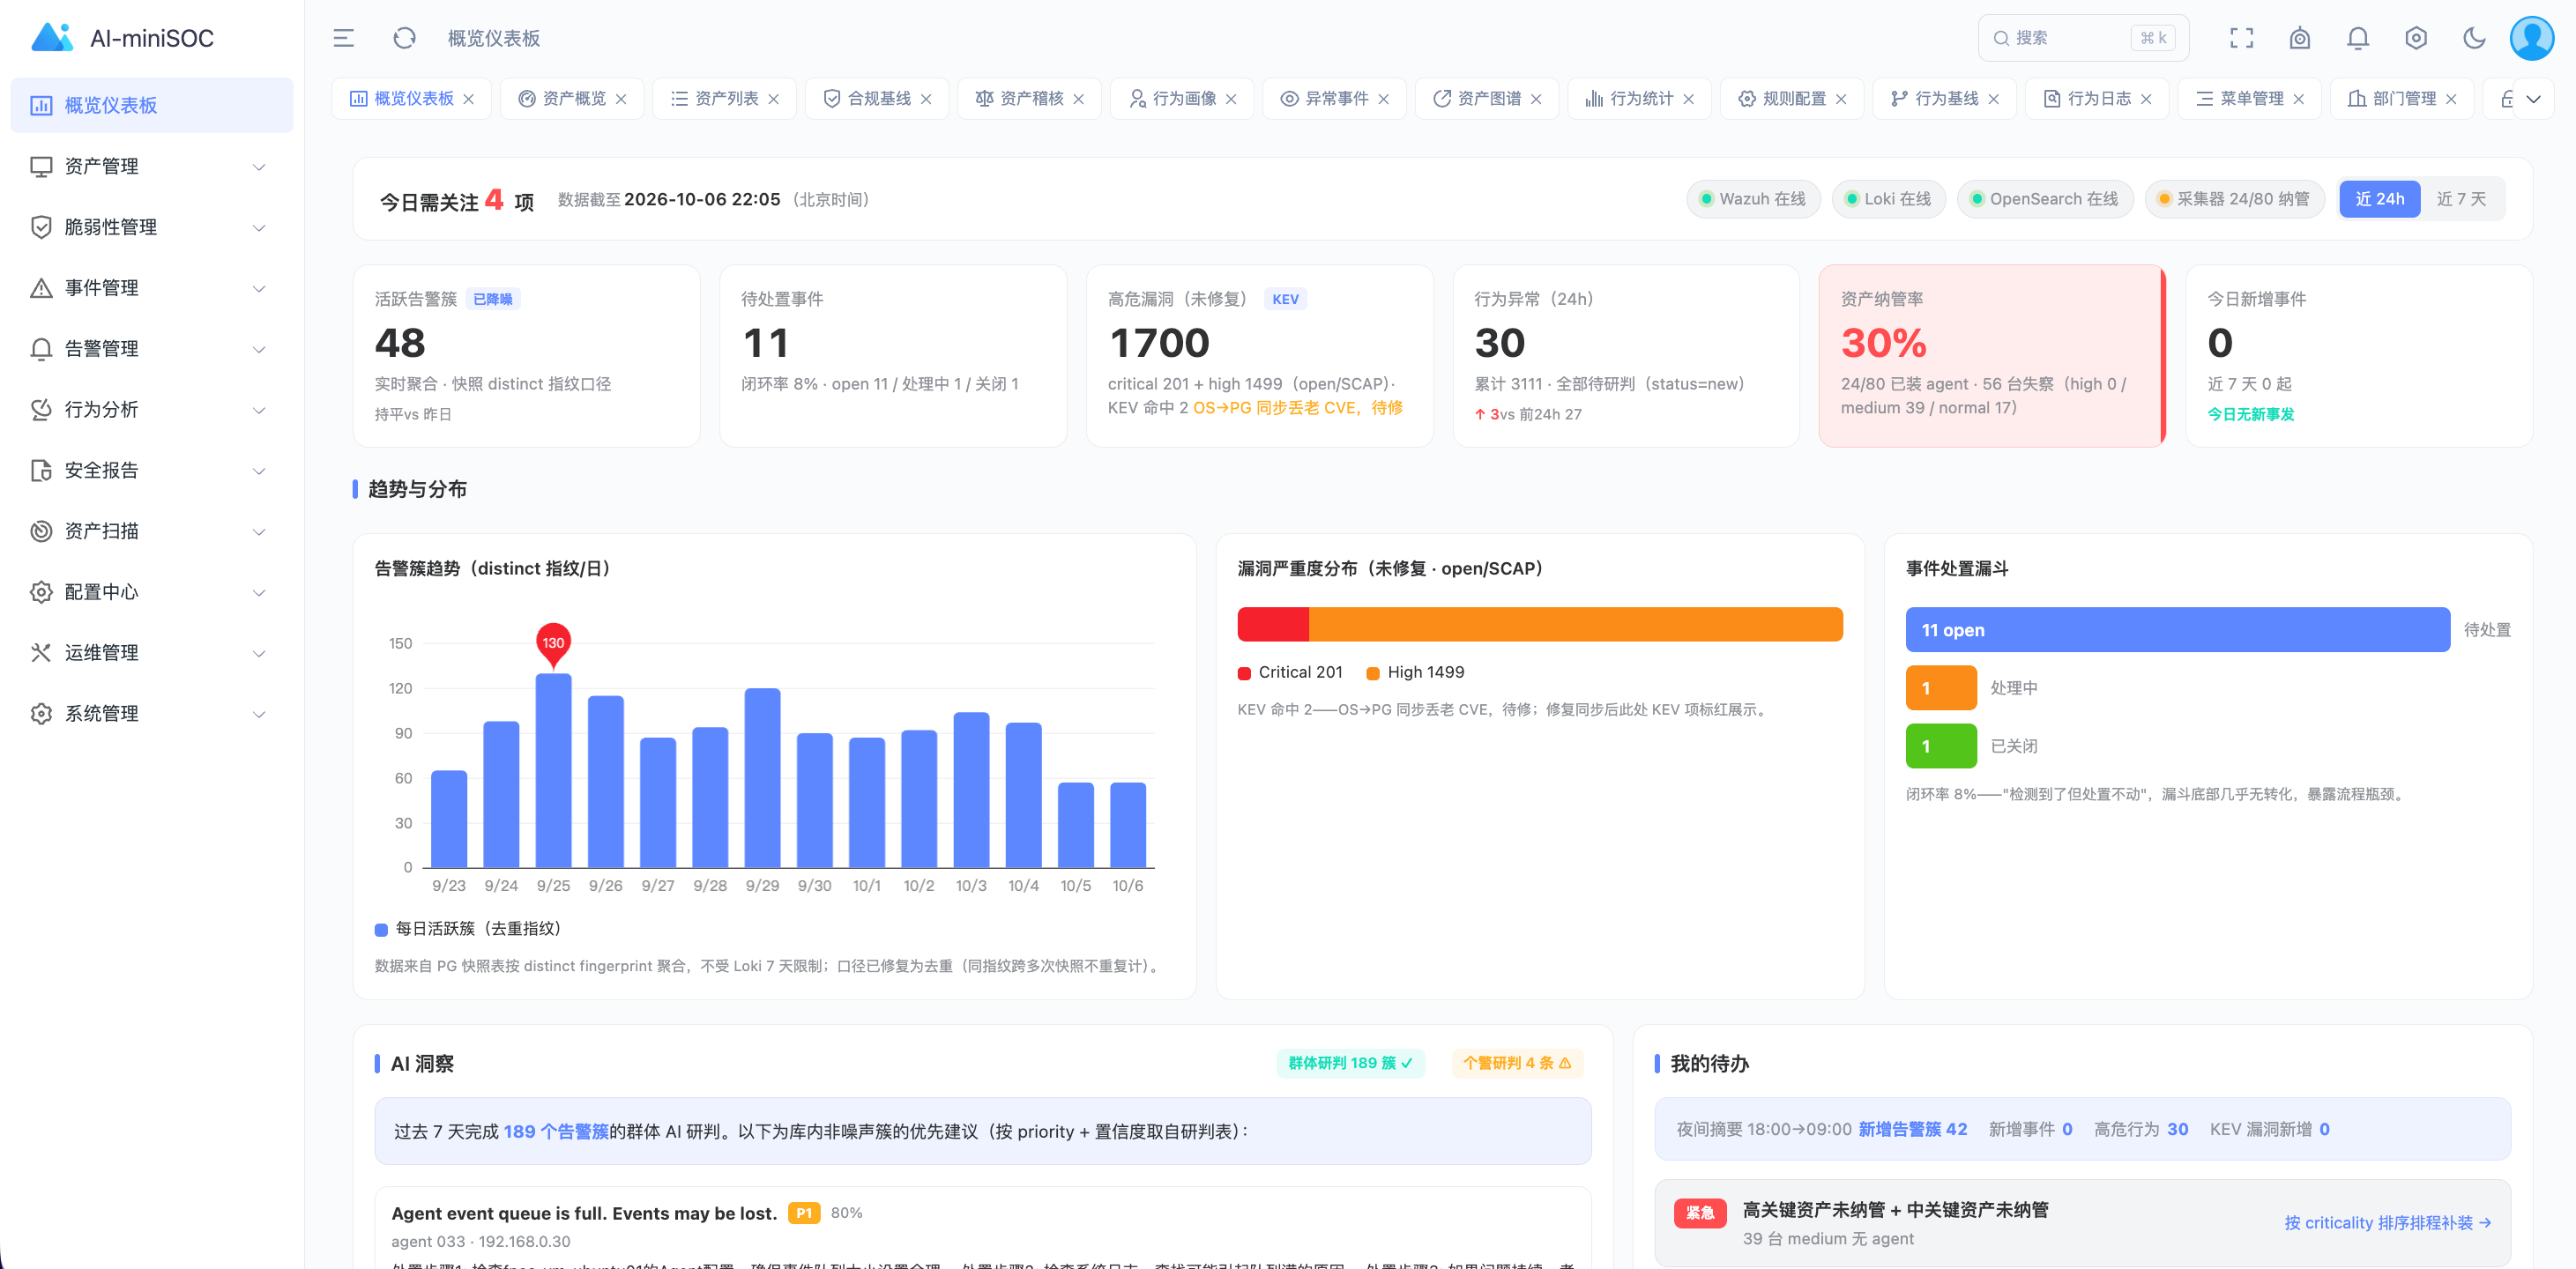
🕳️ 坑 #3:
npm install在国内网络环境可能极慢或失败——换 npm 镜像源(npm config set registry https://registry.npmmirror.com)可以解决 90% 的情况。
用起来了,然后呢?从开发模式切到生产模式
npm run dev 是开发模式——适合验证链路,但长期用(比如给同事开账号、挂到服务器常跑)应该切到生产模式:静态文件 + nginx 托管,速度更快、资源占用更低、重启自动拉起:
| |
🕳️ 坑 #4(进阶玩家才会遇到):别用
npm run build——它带的vue-tsc类型检查必挂(项目已知的类型欠账,不影响功能)。生产构建直接npx vite build。README 里写了这一点,但很多人不看这一行,然后卡半天。
到这里,核心链路已经打通——你现在有一个能登录、能看板的 SOC 了。下面是加分项。
第 4 步(可选):基础设施三件套
Wazuh / Loki / Grafana 这些基础设施,项目提供了懒人包:
| |
装完后,在控制台"配置中心 → 数据源管理"里配置三个数据源的地址(对应 .env 的基础设施组),看到状态灯变绿即接入成功:
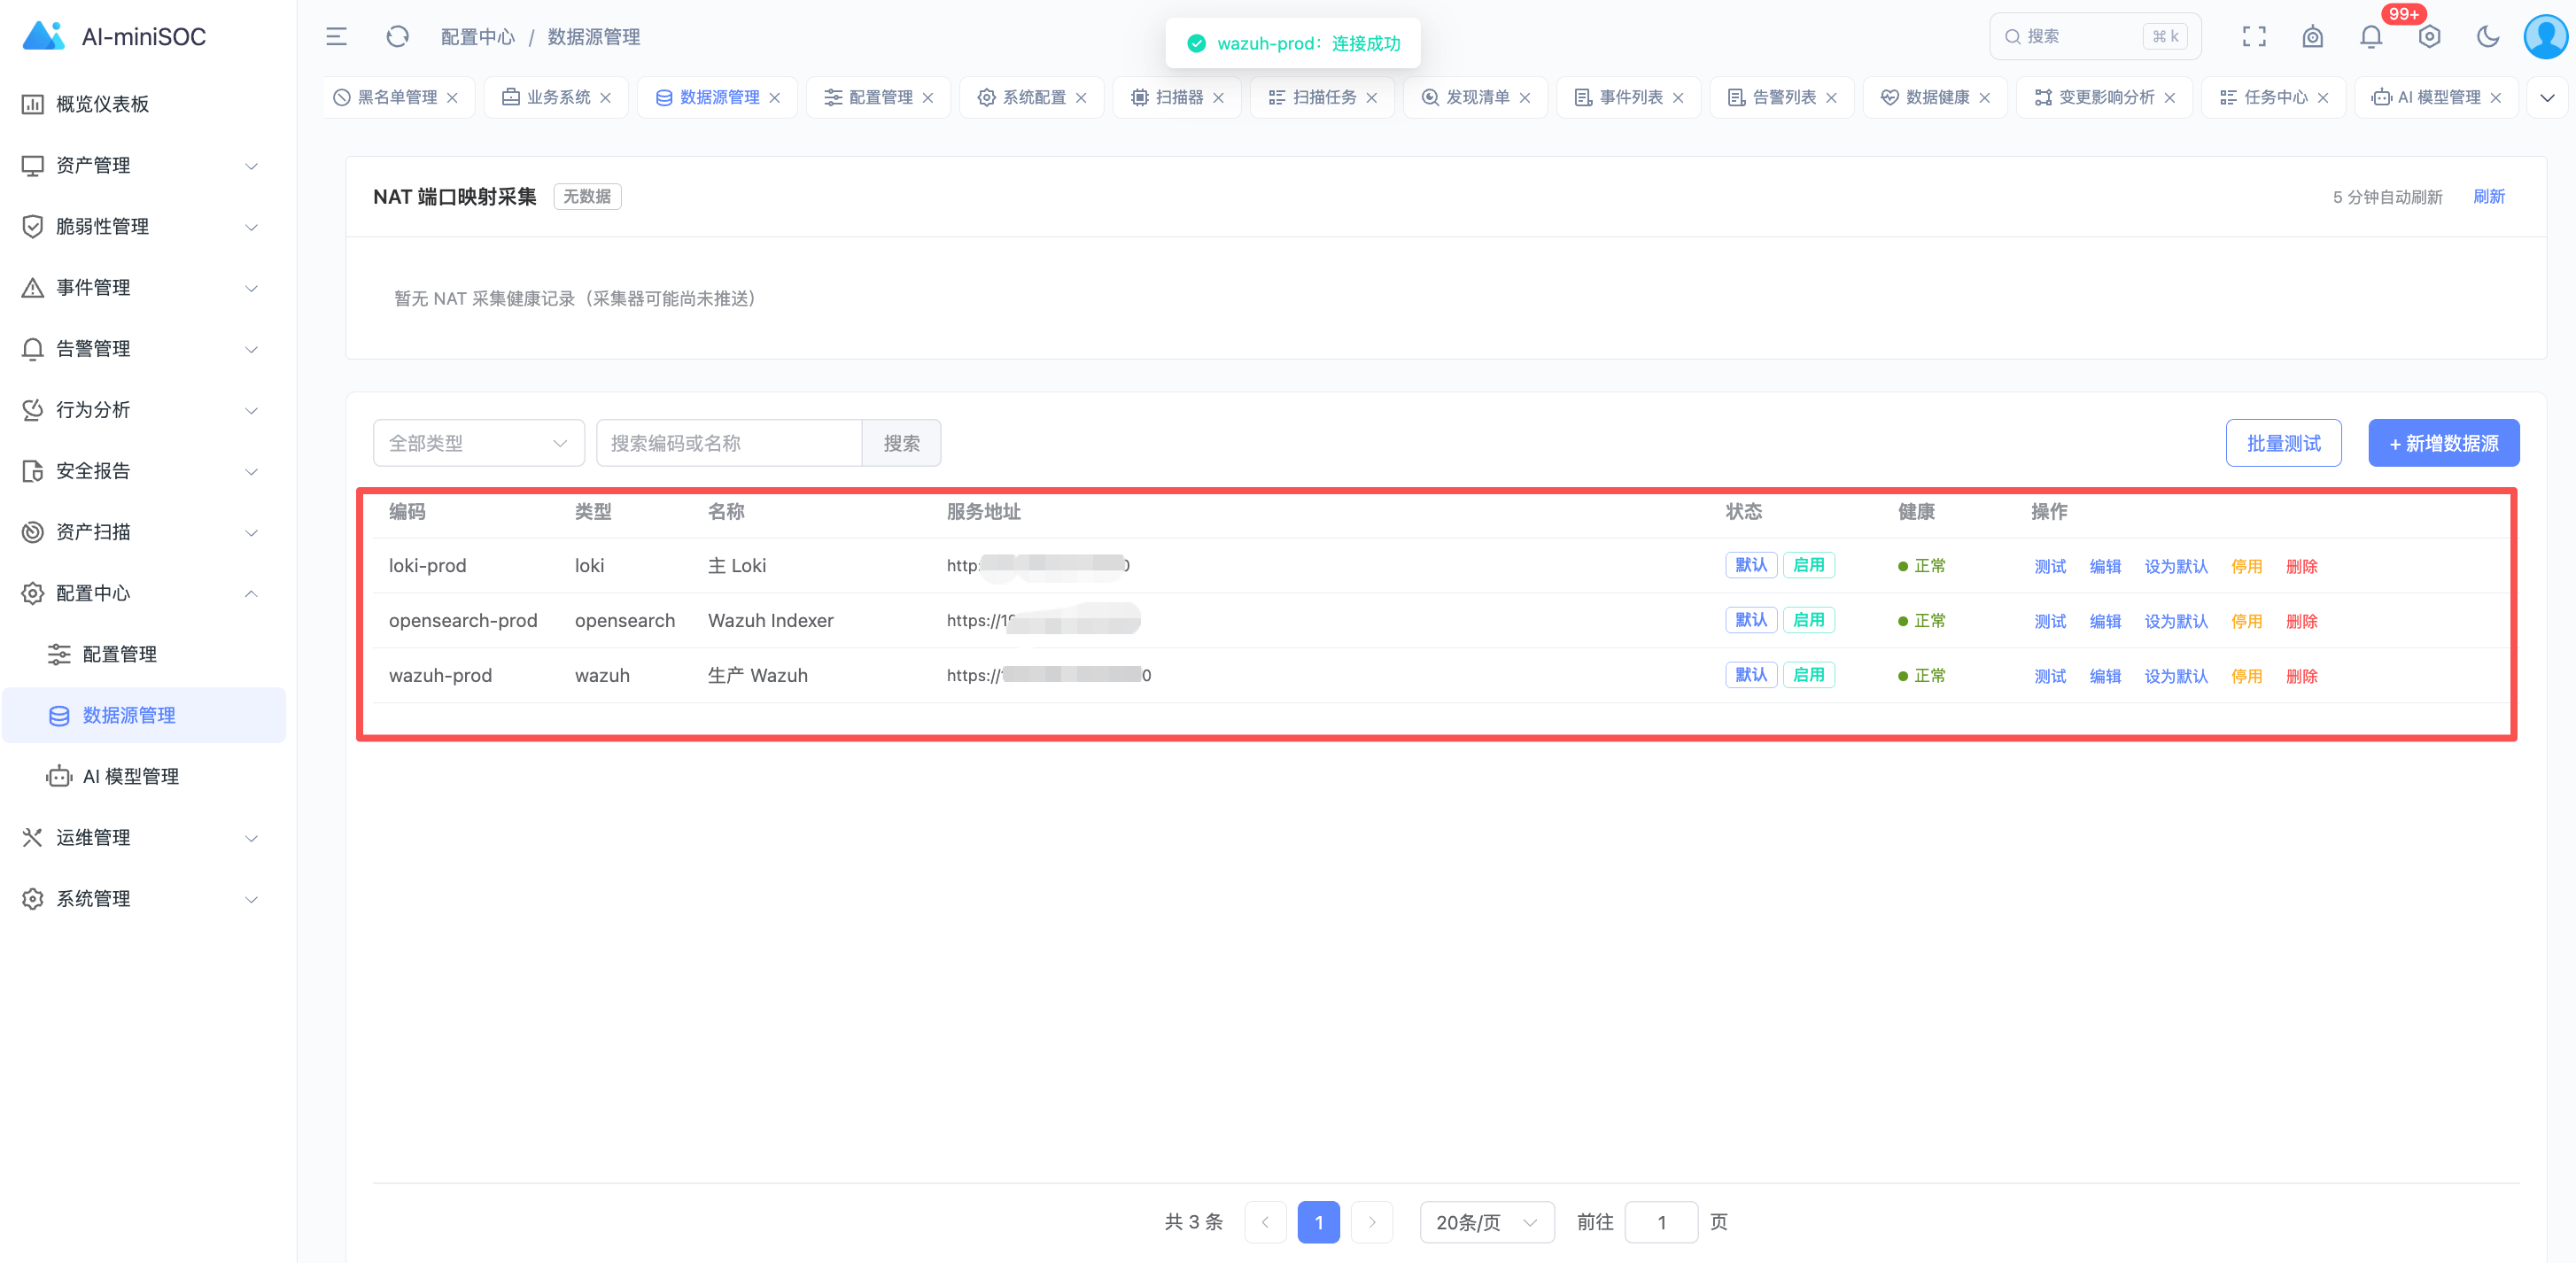
💡 为什么标"可选":不装 Wazuh/Loki,平台照样跑(告警和日志相关页面会是空的,但不崩)——这正是 01 篇"组件可独立替换"架构的现实好处。你可以先把平台跑起来、熟悉界面,再用一个周末把基础设施补上。分两次吃,每次都是小口。
进阶彩蛋:三个库的世界(想改代码的那天再看)
今天你只建了一个库。但如果哪天你不满足于"用",开始想"改"——给项目修个 bug、加个小功能,甚至提个 PR——那天你需要回来补建两个库:
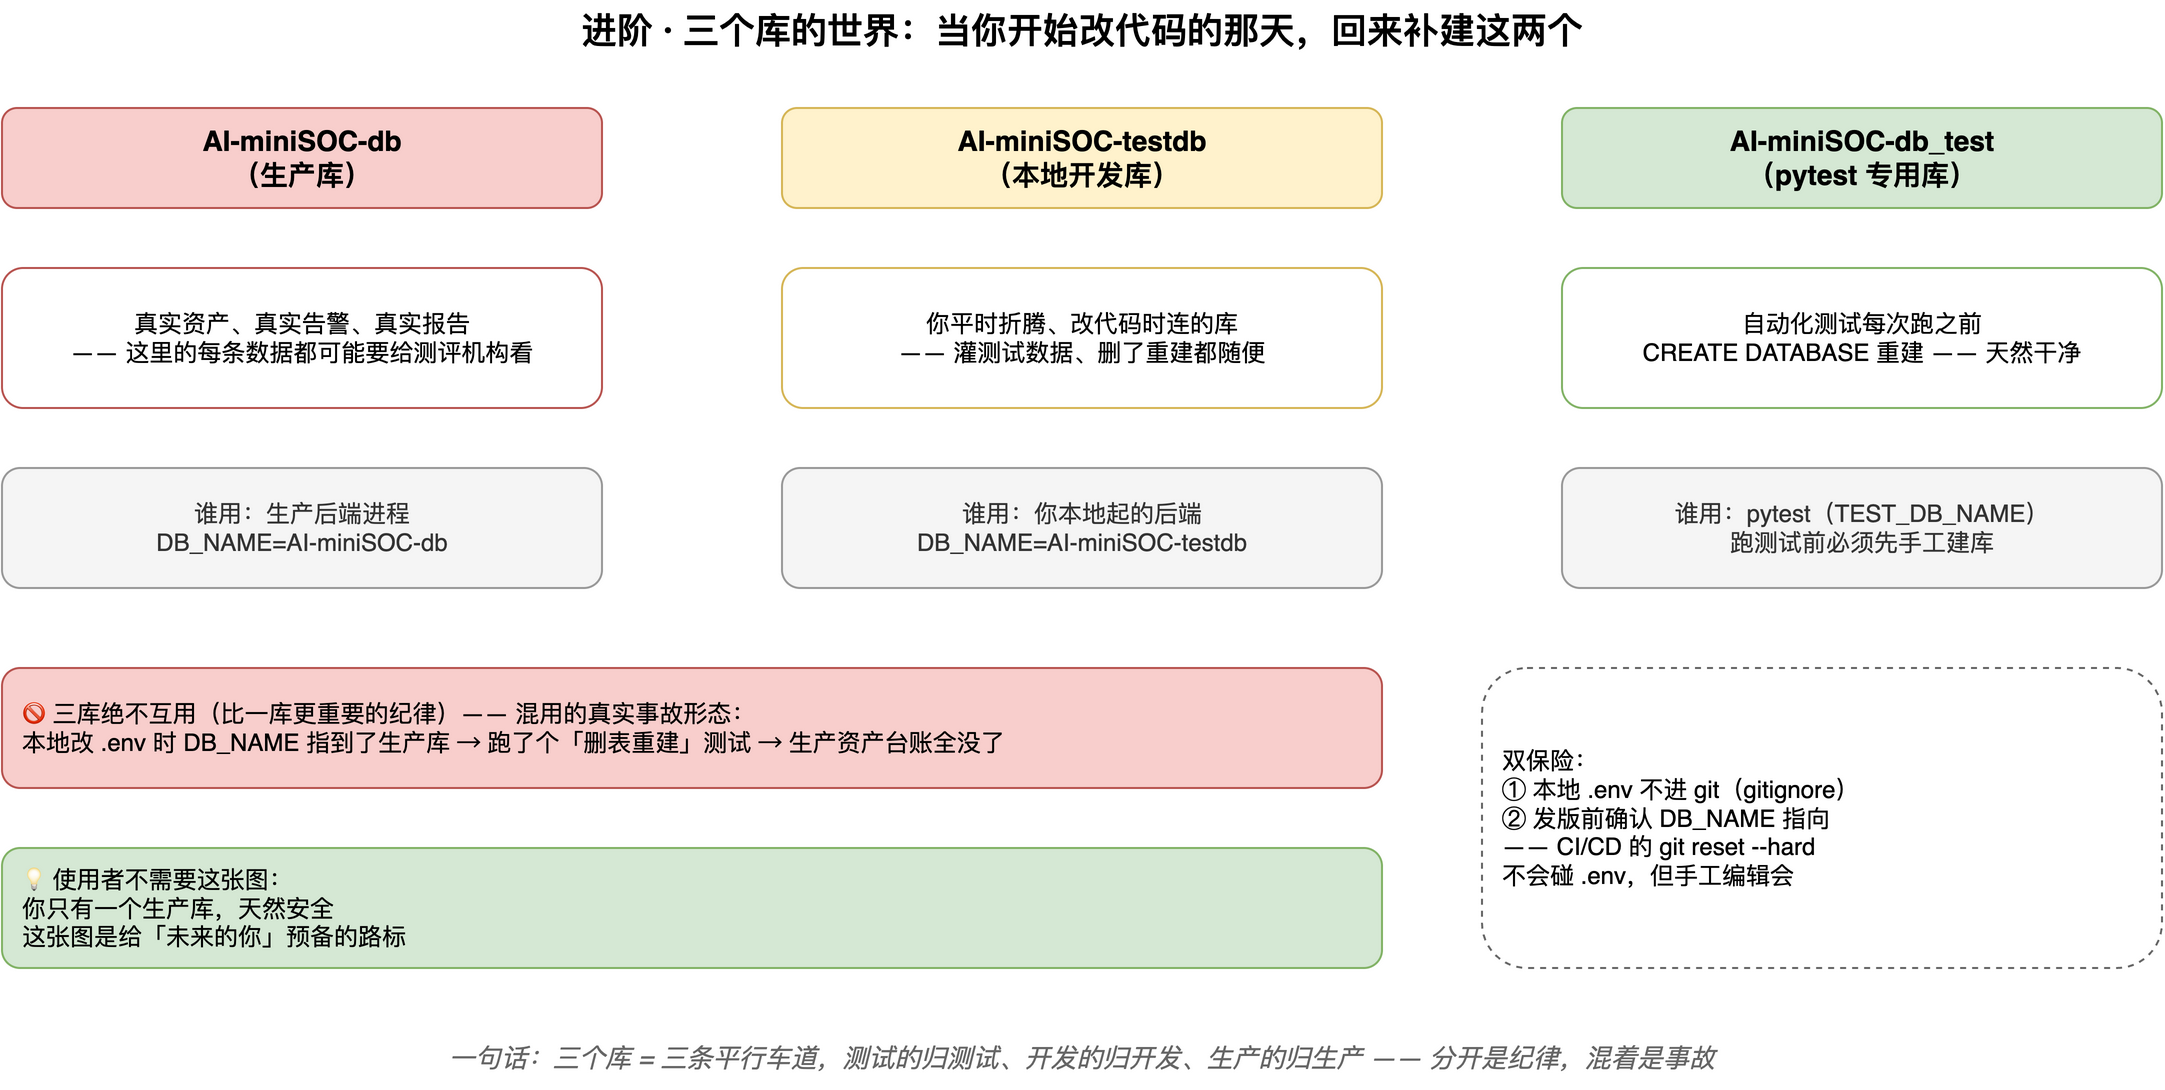
| 库 | 什么时候需要 |
|---|---|
AI-miniSOC-db(生产) | 第一天就要 ✅(你已经有了) |
AI-miniSOC-testdb(本地开发) | 你开始在本地改代码、起开发后端的那天 |
AI-miniSOC-db_test(pytest) | 你想跑项目测试套件的那天(通常是想提 PR 时) |
为什么那时候要分库?因为"改代码的世界"里存在真实的事故形态:本地改 .env 时把 DB_NAME 指到生产库,随手跑了个会"删表重建"的测试——生产资产台账瞬间清空。三个库就是三条平行车道,分开是纪律,混着是事故。
这也是这个项目有意思的地方:使用者和贡献者之间,隔的只是两条 CREATE DATABASE 命令。哪天你跨过去了,欢迎——那是 [第 18 篇(路线图与共建)] 要讲的故事。
踩坑总表(对号入座用)
把这次的坑集中列一遍,部署卡住时直接对表:
| # | 症状 | 根因 | 解法 |
|---|---|---|---|
| 1 | 后端启动报一堆数据库连接错误 | 不在 src/backend/ 目录启动,.env 没加载 | cd src/backend 再启动 |
| 2 | 登录接口 500 | alembic 迁移没跑,库里没表 | alembic upgrade head |
| 3 | npm install 卡死/失败 | 国内网络 | 换 npmmirror 镜像源 |
| 4 | npm run build 类型报错挂掉 | vue-tsc 已知类型欠账 | 生产构建用 npx vite build |
| 5 | Python 3.13 装不上 | Ubuntu 22.04 默认源没有 | deadsnakes PPA |
| 6 | 改了 .env 不生效 | 键名拼写与 Settings 字段不一致(静默失败) | 对照 app/core/config.py 逐个检查 |
这张表以后会持续更新——你在部署中踩到的新坑,欢迎到仓库提 Issue,我会补进表里并注明出处。踩坑记录本身,就是这个开源项目给后来者最实在的礼物。
部署完成之后:先做这三件事
跑起来只是起点。接下来建议按顺序做三件事,把这个"能跑的系统"变成"你的系统":
- 改默认密码 + 确认 SECRET_KEY 已换——安全系统的第一课是保护自己;
- 接入第一台主机:找一台你的服务器装 Wazuh agent,看它的日志和告警第一次流进你的控制台——那一刻你会真正理解"自己的 SOC"是什么感觉(具体步骤是 [下一篇 (03)] 的内容);
- 配置一条推送通道(邮件或钉钉),然后故意触发一条告警测试全链路——打通"告警 → 通知到你手机"的闭环,SOC 才算活了。
写在最后
00 篇我们想清楚"为什么做",01 篇看懂"凭什么做得动",这一篇把它跑了起来。
回头看这 45 分钟:五步路线、一个数据库、两组必填配置、四个坑。这些数字都不吓人——吓人的从来不是步骤数,而是"不知道自己卡在哪"。所以本篇反复强调的就是一件事:每步设过关标准,过了再走。
下一篇 (03):Wazuh 接入实战——把你的第一台主机纳管进来。从装 agent、跑通第一条告警,到我那七篇 Wazuh 教程没写的"平台化集成"经验(Webhook 实时同步 vs 手动全量的取舍)。
老李的服务器已经跑起来了,你的呢?
【系列导航】《一个人的SOC》总目录(持续更新)
【上一篇】(01) 总体架构——8G 内存的小服务器如何装下一个 SOC
【系列开篇】(00) 中小企业为什么需要自己的安全运营中心
【项目地址】AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐ https://github.com/xiejava1018/AI-miniSOC
【交流】 部署卡住了?把你卡住的报错截图发到仓库 Issue,我会逐个回复——典型问题会写进下一篇的踩坑表。
下一篇(预告):(03) Wazuh 接入实战——把第一台主机纳管进来(连载中,敬请关注)
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!