导语:大模型有两件事天生做不了——它不知道训练截止之后的新知识,也不知道你公司自己的私有知识。RAG 就是给它的外挂。但外挂也有三代,能力差得很远。
一、先说清楚:为什么模型需要一个"外挂"
今天你让大模型做一件很平常的事:
“把我们公司这三年的安全运营复盘报告总结一下,说说主要问题。”
它大概率会一本正经地编。原因很简单,两个:
- 它没读过你的文档——预训练截止之后发生的事,它不知道
- 就算读过,它也记不住——模型学的是"语言和公开知识的统计规律",不是"你司的规章制度和踩过的坑"
所以 RAG(Retrieval-Augmented Generation,检索增强生成)出现了。
说人话:给大模型装一个外挂。 回答问题之前,先去外挂里翻资料,把翻到的东西塞回给它,让它照着答。
于是回答会更贴业务、更有时效——外挂里的东西,是你当场喂进去的。
二、第一代外挂怎么干活
传统 RAG 的工作流,拆开就五步:
- 切片:把长文档切成一段段的小块
- 向量化:每一小块变成一串数字(embedding),数字相近就代表意思相近
- 入库:存进向量库
- 检索:你提问时,算出问题和哪几块最像,取 Top-K
- 回灌:把这 K 块塞进提示词,让模型基于它们回答
这五步本身没问题,效率很高——毫秒级返回,成本低。它解决了前面说的两个短板:时效性和私域。
但它有一个天花板。
三、第一代的天花板:它只找"像",不找"关系"
举个我自己的例子。
我博客名叫 xiejava,CSDN ID 是 fullbug。现在我问一个 RAG 系统:
“xiejava 都写过哪些博客?哪几篇是讲 RAG 的?”
向量检索会怎么做?它会去找 ** “字面上最像"的那几段** ——比如所有同时含"xiejava"和"RAG"的段落。
结果它能答出"有一篇讲 RAG 的博客提到了 xiejava”。 但它答不出:“xiejava 一共写了 260 多篇,其中 2 篇讲 RAG,分别是什么主题。”
因为要回答后面这个问题,模型必须理解实体与实体之间的关系——xiejava 这个人,和 RAG 这篇文章之间是什么关系、作者和文章之间是什么关系。而向量检索只告诉你"这两段文字像不像",不告诉你谁和谁有关系。
这就是第一代 RAG 的死穴:它是基于相似度的检索,不是基于关系的检索。
四、第二代:把关系画成一张图
GraphRAG(微软研究院 2024 年提出)换了个思路:既然要回答关系问题,那就把关系显式地画出来。
做法是:
- 用大模型从文档里抽取语义实体(人、组织、概念、项目……)
- 抽取实体之间的关系(谁属于谁、谁负责什么、谁和谁相关)
- 把这些实体和关系存成图谱
- 回答问题时,在图上走关系路径,而不是只比相似度
有了图谱,模型就能回答这类问题:
- 谁负责这个项目?(Who)
- 什么事导致了那次故障?(What)
- 什么事情是由什么原因造成的?(Why)
- 某个实体还有哪些相关属性?
这里有个很多人忽略的关键点:GraphRAG 真正的杀手锏,其实不只是关系问答。
传统 RAG 无论怎么检索,Top-K 永远只能看到局部——你问"这批文档整体在讲什么",它给你的是 K 个最相关的片段,不是一份全局摘要。
GraphRAG 靠社区发现 + 分层摘要(把图上的关系聚成社区,逐层向上概括)能做到全局性问题——“这三年我们的安全运营,主要踩了哪几类坑”。这是向量检索原理上就做不到的。
顺带说清楚一个容易被讲歪的点:GraphRAG 不是“只能回答一轮”。它的全局搜索用的是 map-reduce 思路——把各社区的摘要分块并行生成局部答案,再过滤、排序、归并成一个全局答案。它的短板是"图是静态的",不是"只能一轮"。
代价:建图很贵。要把全量文档跑一遍让模型抽实体和关系,还要做社区聚类,逐层生成摘要。查询反而比传统 RAG 慢。
五、第三代:给外挂加一个会自己判断"够不够"的循环
前两代还有个共同点:一次检索,一次作答。
但很多真实问题不是查一次就够的:
“我们去年那次故障,根因到底是什么?” → 需要先查故障报告 → 发现提到某个组件 → 再查那个组件的历史问题 → 发现是版本变更 → 再查变更记录……
这需要多步、动态、按需地查。这正是 AgentRAG 的地盘。
它给外挂加了三样东西:
- Loop(循环):检索 → 判断"信息够不够" → 不够就再检索、再调工具 → 直到满意
- 记忆:把中间过程和结论保留下来,供后续推理使用
- 工具调用:不只是搜文档,还可以查数据库、跑代码、调接口
于是它能深挖多跳问题,回答更有逻辑性和推理性。
代价也很实在:慢(要转好多圈)、贵(每一圈都是模型调用)、结果不确定(可能绕圈、可能提前收敛在错的答案上)。
六、三代怎么选
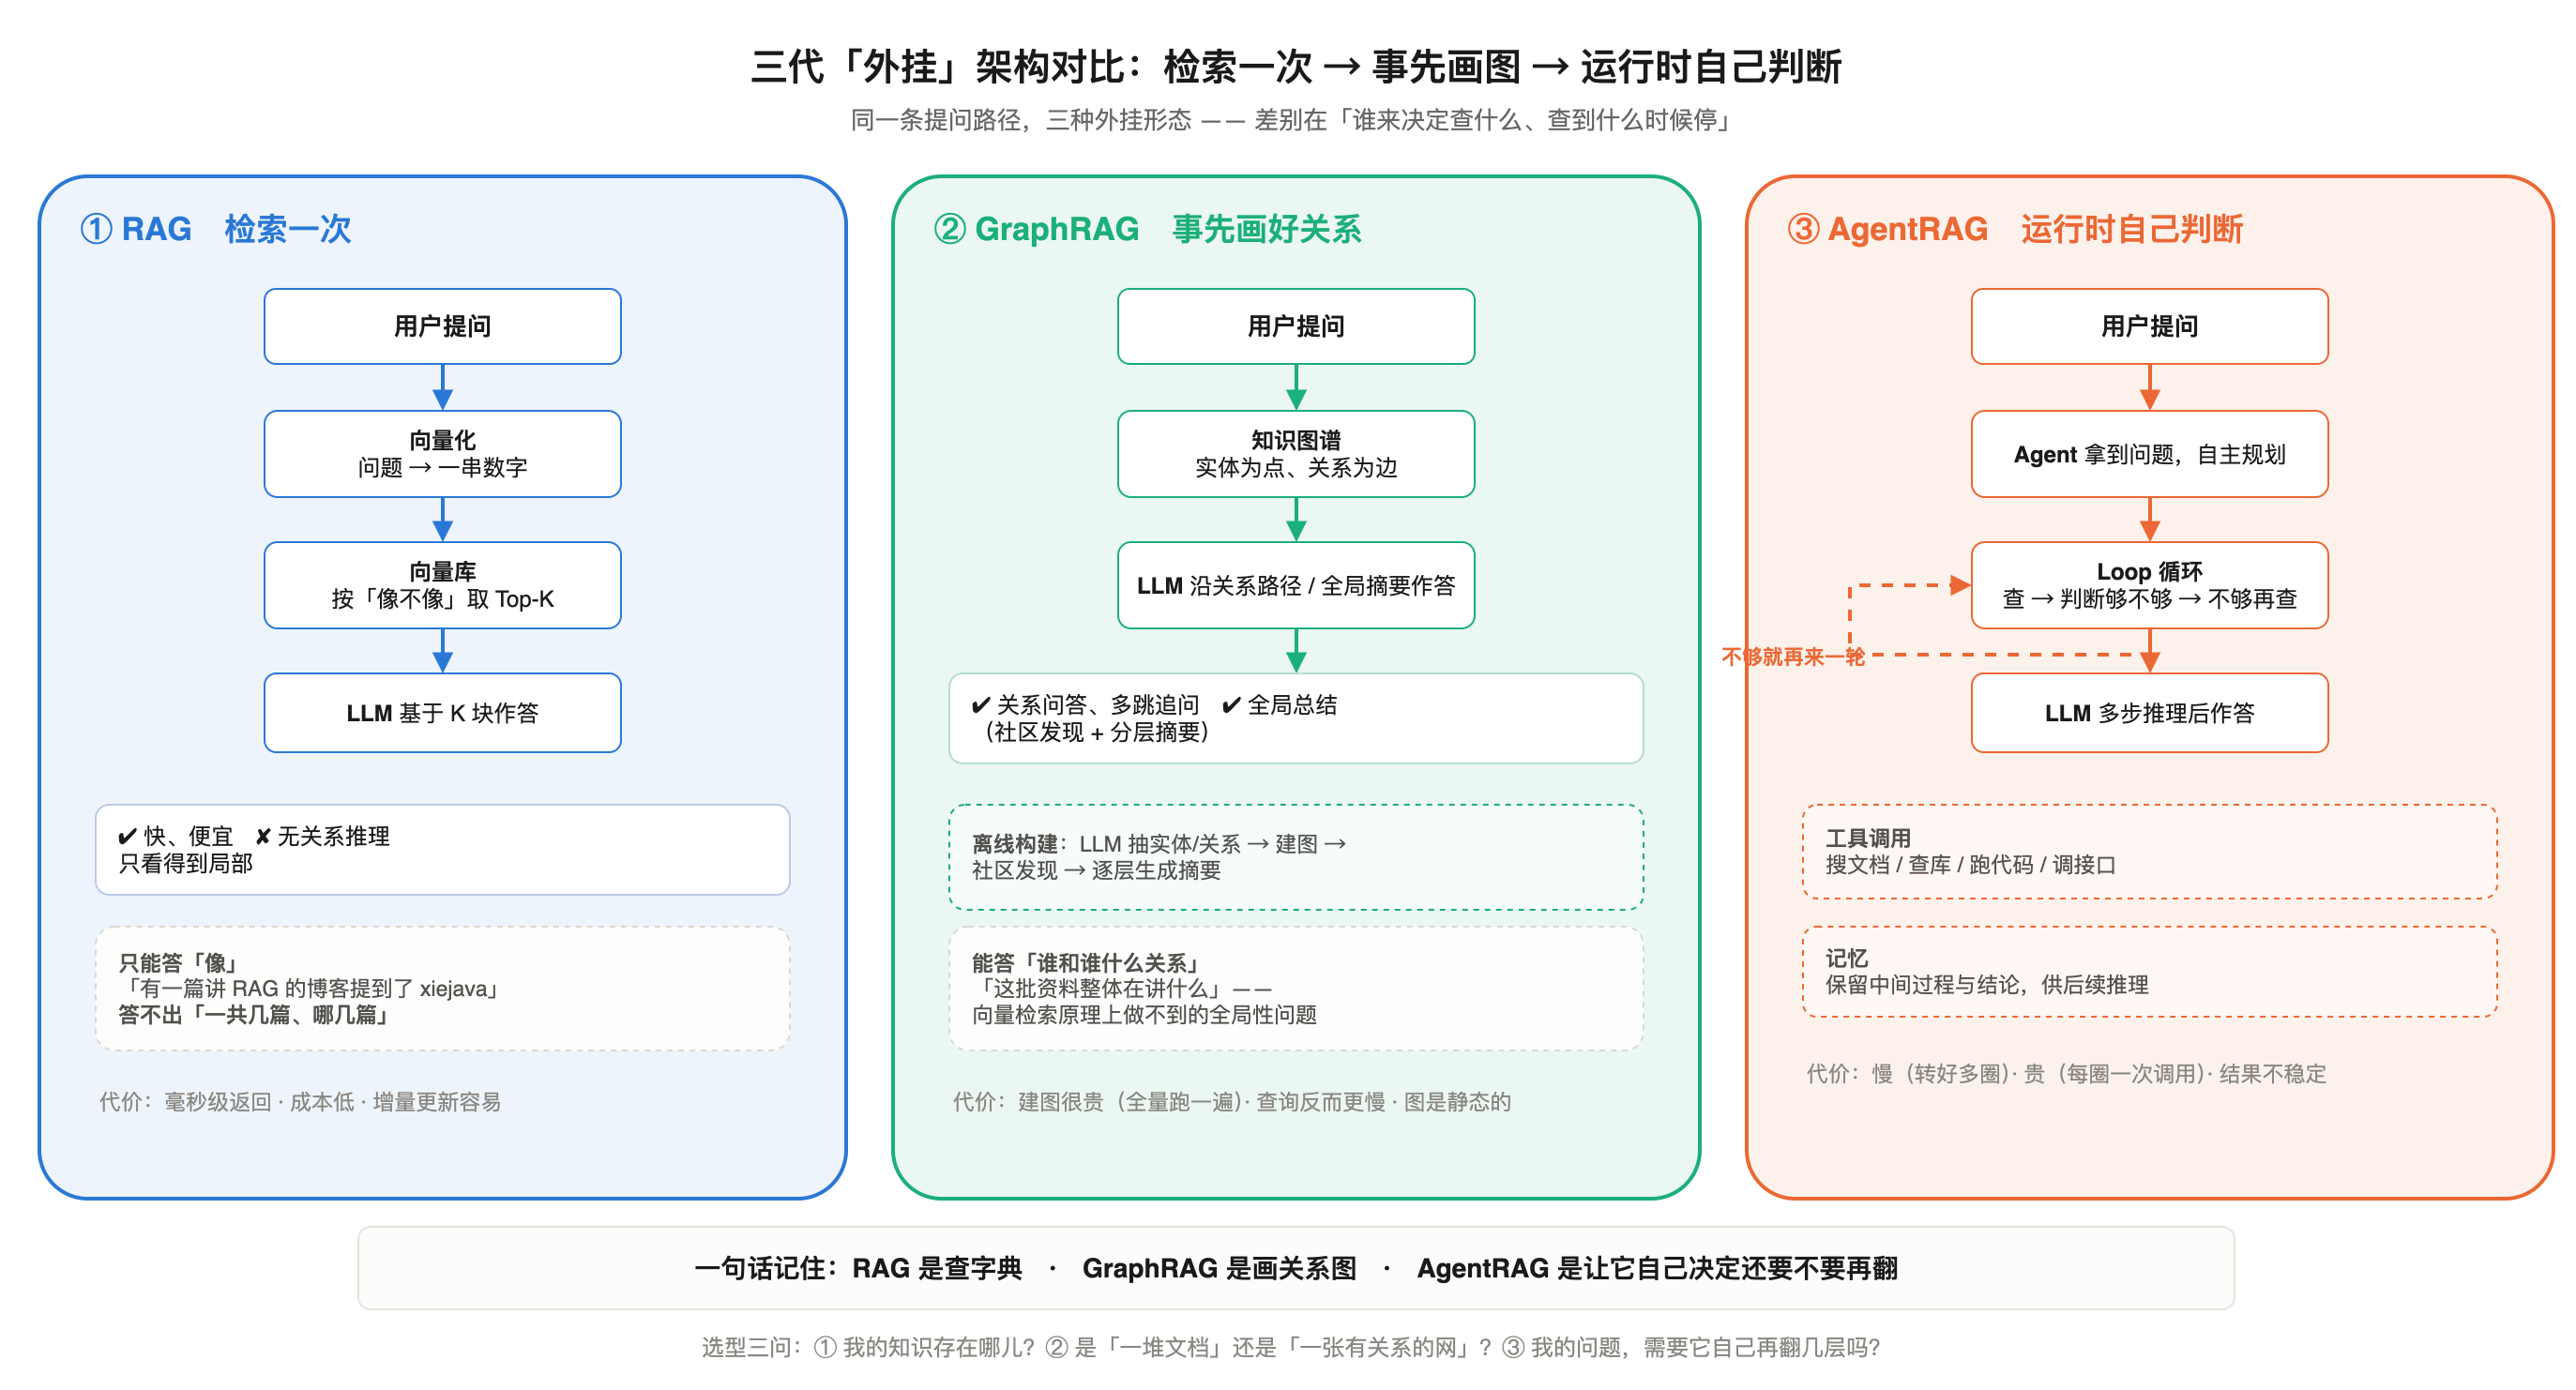
| 本质 | 强项 | 什么时候用 | 代价 | |
|---|---|---|---|---|
| RAG | 检索一次 | 快、便宜 | 事实问答、文档查找、“这份文档说了什么” | 无关系推理、多跳弱、只见局部 |
| GraphRAG | 把关系事先画好 | 关系问答、全局总结 | “谁和谁什么关系"“这批资料整体讲了什么” | 建图贵、图静态、不做动态决策 |
| AgentRAG | 运行时自己判断够不够 | 多跳推理、动态取证 | 需要连查好几层、需要调工具的复杂问题 | 慢、贵、结果不稳定 |
一句话记住这三代的区别:
传统 RAG 是查字典,GraphRAG 是画关系图,AgentRAG 是让它自己决定还要不要再翻。
七、同一道题,三种走法
把上面三个代际放进同一道题里对照,就更清楚了:
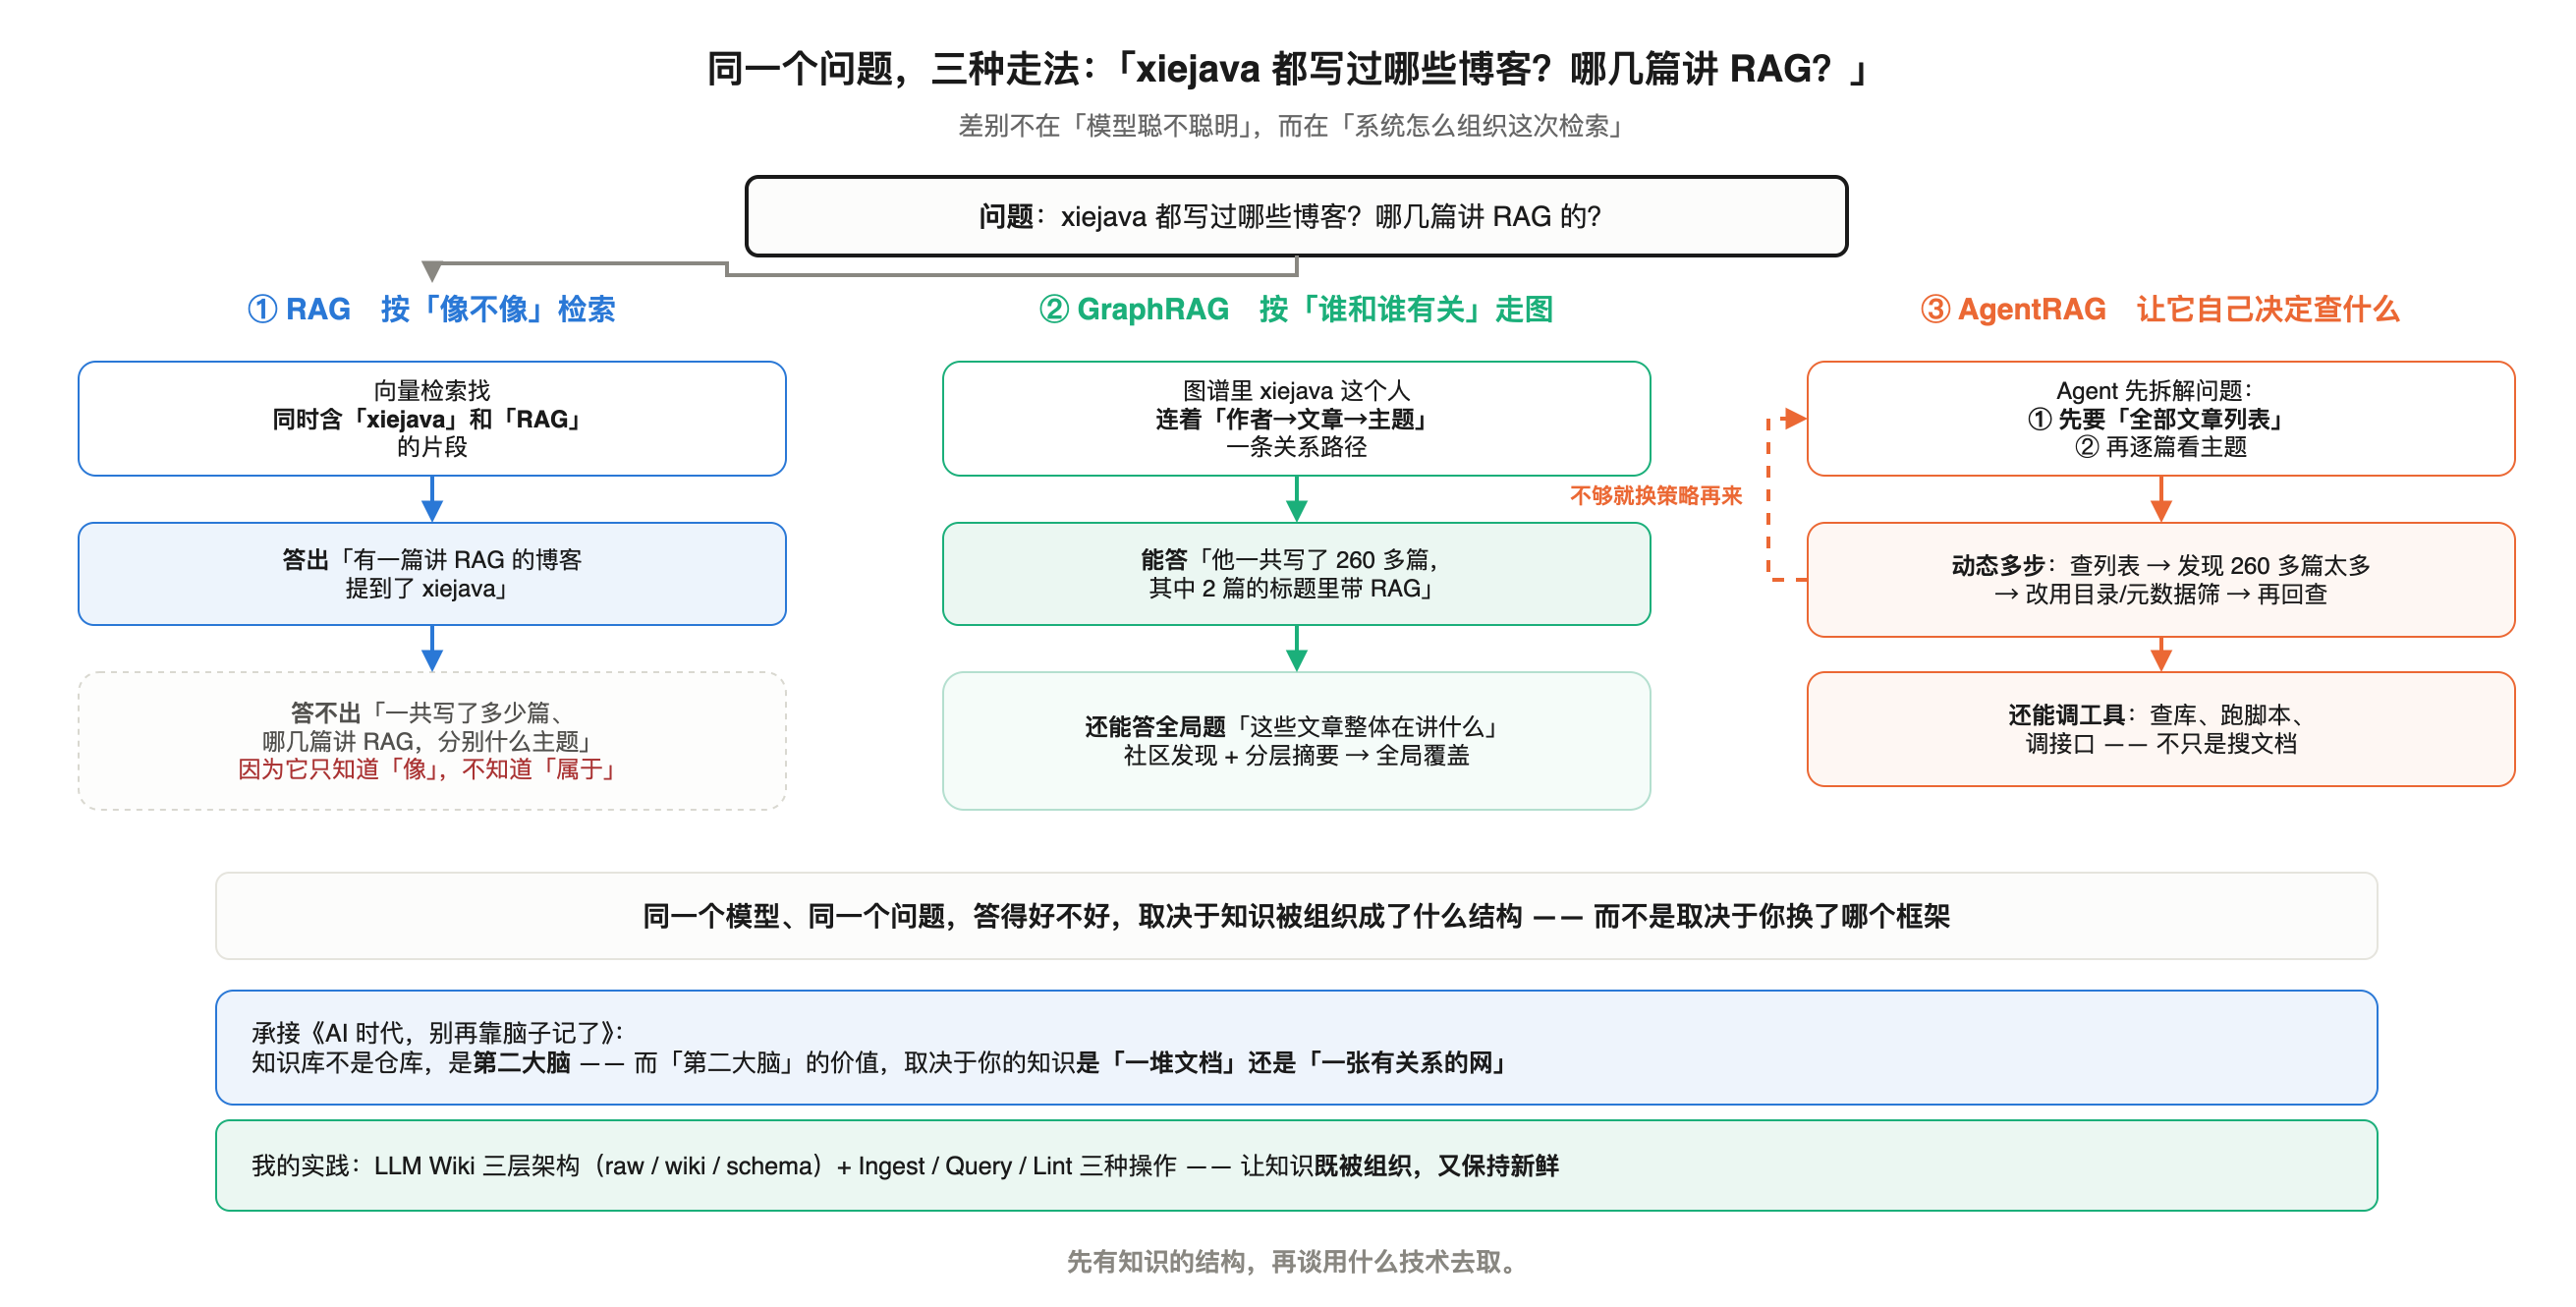
同一个模型、同一个问题,答得好不好,取决于知识被组织成了什么结构——而不是取决于你换了哪个框架。
八、最后
工具会一直变,每隔几个月就有个新框架。但问题的形状没变:你的知识不在模型里,就得靠外挂接进来。
所以真正该问的,不是"该用哪个框架”,而是:
- 我的知识,现在存在哪儿?
- 它是"一堆文档",还是"一张有关系的网"?
- 我的问题,需要它自己再翻几层吗?
这三个问题答清楚了,框架自己会浮出来。
先有知识的结构,再谈用什么技术去取。
这一点我在上一篇《AI 时代,别再靠脑子记了:知识库不是仓库,是你的第二大脑》里已经讲过一半——知识库和仓库的分界线,就在于知识有没有被组织起来。今天这篇补上了另一半:组织起来的知识,得配一个能配得上它的检索方式。
我自己跑的这套"组织知识"的方法,落在 LLM Wiki 三层架构上:raw/ 存原始、wiki/ 存被加工过的页面、schema/ 存维护规范,再用 Ingest / Query / Lint 三种操作让它持续保鲜。如果你想看它是怎么从一段原始资料长成一张网的,可以看《让 AI 帮你"养"知识库》和《用一个 Skill 打通三类知识库》。
评论区聊聊:你现在给大模型接的外挂,是"一堆文档"还是"一张有关系的网"?有没有哪个问题,是你现在这套答不好的?
延伸阅读:
- AI 时代,别再靠脑子记了:知识库不是仓库,是你的第二大脑 —— 前篇:知识库为什么不能只是个仓库
- 把知识库当系统来工程化:我的 LLM Wiki 实践 —— 三层架构与 Ingest / Query / Lint 三种操作
- 方案写不出来?用 Claude Code + RAG 知识库 + scheme-writer 打通写方案最后一公里 —— 我自己怎么把 RAG 用进日常写方案
- 《一个人的 SOC》系列导航(18 篇) —— 知识被组织起来之后的样子
作者博客:http://xiejava.ishareread.com/
关注:微信公众号,一起学习成长!